
莫烦PyTorch学习笔记(五)——分类
import torch

from torch.autograd import Variable

import torch.nn.functional as F

import matplotlib.pyplot as plt

# make fake data

n_data = torch.ones(, )

x0 = torch.normal(*n_data, )      #每个元素(x,y)是从 均值=*n_data中对应位置的取值,标准差为1的正态分布中随机生成的

y0 = torch.zeros()               # 给每个元素一个0标签

x1 = torch.normal(-*n_data, )     # 每个元素(x,y)是从 均值=-*n_data中对应位置的取值,标准差为1的正态分布中随机生成的

y1 = torch.ones()                # 给每个元素一个1标签

x = torch.cat((x0, x1), ).type(torch.FloatTensor)  # shape (, ) FloatTensor = -bit floating

y = torch.cat((y0, y1), ).type(torch.LongTensor)    # shape (,) LongTensor = -bit integer

# torch can only train on Variable, so convert them to Variable

x, y = Variable(x), Variable(y)

# draw the data

plt.scatter(x.data.numpy()[:, ], x.data.numpy()[:, ], c=y.data.numpy())#c是一个颜色序列

#plt.show()

#神经网络模块

class Net(torch.nn.Module):#继承神经网络模块

    def __init__(self,n_features,n_hidden,n_output):#初始化神经网络的超参数

        super(Net,self).__init__()#调用父类神经网络模块的初始化方法,上面三行固定步骤,不用深究

        self.hidden = torch.nn.Linear(n_features,n_hidden)#指定隐藏层有多少输入,多少输出

        self.predict = torch.nn.Linear(n_hidden, n_output)#指定预测层有多少输入,多少输出

    def forward(self,x):#搭建神经网络

        x = F.relu(self.hidden(x))#积极函数激活加工经过隐藏层的x

        x = self.predict(x)#隐藏层的数据经过预测层得到预测结果

        return x

net = Net(,,)#声明一个类对象

print(net)

plt.ion()#在Plt.ion和plt.ioff之间的代码,交互绘图

plt.show()

#神经网络优化器,主要是为了优化我们的神经网络,使他在我们的训练过程中快起来,节省社交网络训练的时间。

optimizer = torch.optim.SGD(net.parameters(),lr = 0.01)#其实就是神经网络的反向传播,第一个参数是更新权重等参数,第二个对应的是学习率

loss_func = torch.nn.CrossEntropyLoss()#标签误差代价函数

for t in range():

    out = net(x)

    loss = loss_func(out,y)#计算损失

    optimizer.zero_grad()#梯度置零

    loss.backward()#反向传播

    optimizer.step()#计算结点梯度并优化,

    if t %  == :

        plt.cla()# Clear axis即清除当前图形中的之前的轨迹

        prediction = torch.max(F.softmax(out), )[]#转换为概率,后面的一是最大值索引,如果为0则返回最大值

        pred_y = prediction.data.numpy().squeeze()

        target_y = y.data.numpy()

        plt.scatter(x.data.numpy()[:, ], x.data.numpy()[:, ], c=pred_y, s=, lw=, cmap='RdYlGn')

        accuracy = sum(pred_y == target_y) / .#求准确率

        plt.text(1.5, -, 'Accuracy=%.2f' % accuracy, fontdict={'size': , 'color': 'red'})

        plt.pause(0.1)

plt.ioff()

plt.show()
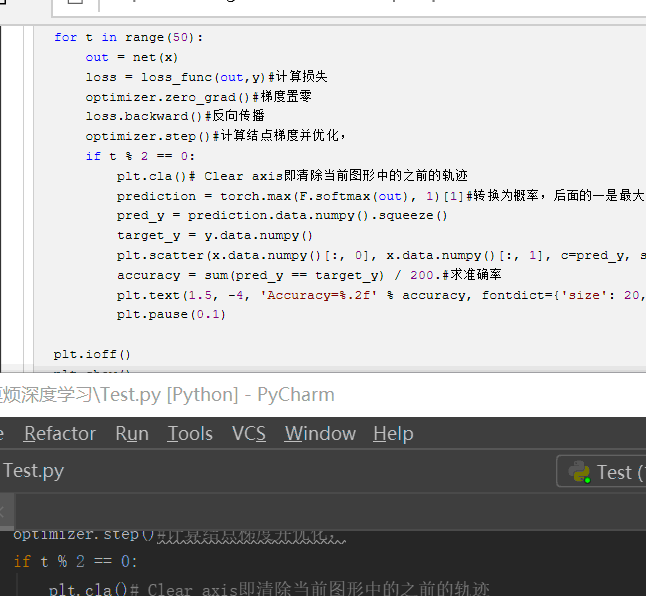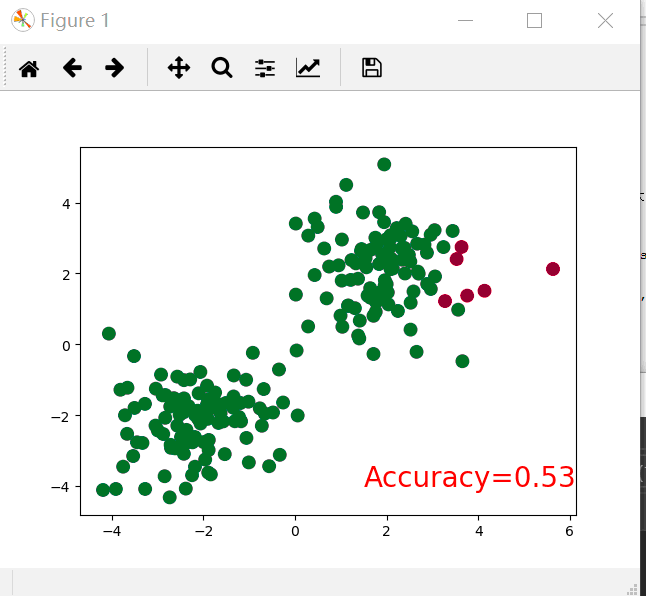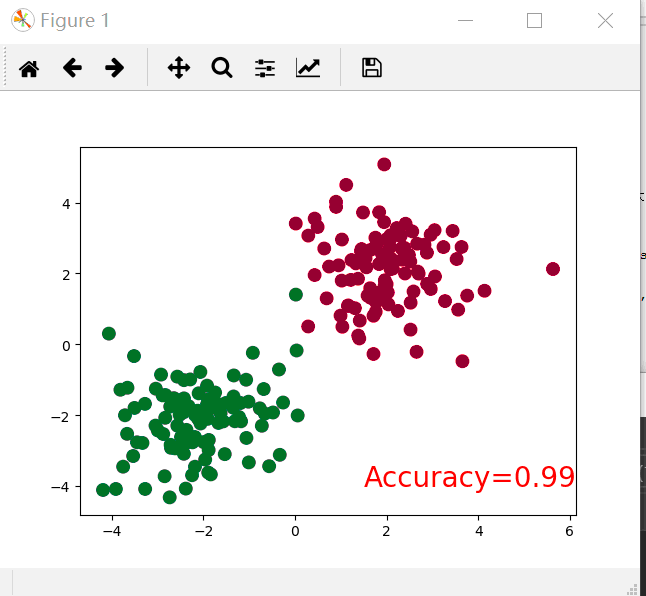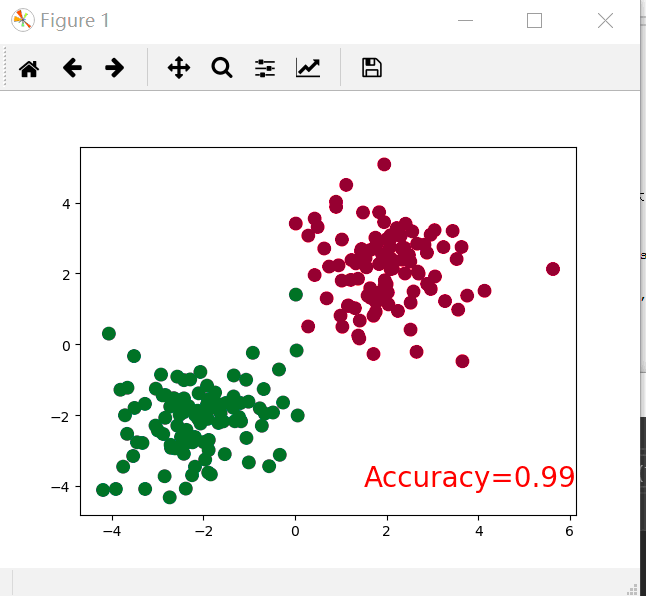
下面的是一个比较快搭建神经网络的代码,在上面的代码进行修改,代码如下
import torch

from torch.autograd import Variable

import torch.nn.functional as F

import matplotlib.pyplot as plt

# make fake data

n_data = torch.ones(, )

x0 = torch.normal(*n_data, )      #每个元素(x,y)是从 均值=*n_data中对应位置的取值,标准差为1的正态分布中随机生成的

y0 = torch.zeros()               # 给每个元素一个0标签

x1 = torch.normal(-*n_data, )     # 每个元素(x,y)是从 均值=-*n_data中对应位置的取值,标准差为1的正态分布中随机生成的

y1 = torch.ones()                # 给每个元素一个1标签

x = torch.cat((x0, x1), ).type(torch.FloatTensor)  # shape (, ) FloatTensor = -bit floating

y = torch.cat((y0, y1), ).type(torch.LongTensor)    # shape (,) LongTensor = -bit integer

# torch can only train on Variable, so convert them to Variable

x, y = Variable(x), Variable(y)

# draw the data

plt.scatter(x.data.numpy()[:, ], x.data.numpy()[:, ], c=y.data.numpy())#c是一个颜色序列

#plt.show()

#神经网络模块

net2 = torch.nn.Sequential(

    torch.nn.Linear(,),

    torch.nn.ReLU(),

    torch.nn.Linear(,)

)

plt.ion()#在Plt.ion和plt.ioff之间的代码,交互绘图

plt.show()

#神经网络优化器,主要是为了优化我们的神经网络,使他在我们的训练过程中快起来,节省社交网络训练的时间。

optimizer = torch.optim.SGD(net.parameters(),lr = 0.01)#其实就是神经网络的反向传播,第一个参数是更新权重等参数,第二个对应的是学习率

loss_func = torch.nn.CrossEntropyLoss()#标签误差代价函数

for t in range():

    out = net(x)

    loss = loss_func(out,y)#计算损失

    optimizer.zero_grad()#梯度置零

    loss.backward()#反向传播

    optimizer.step()#计算结点梯度并优化,

    if t %  == :

        plt.cla()# Clear axis即清除当前图形中的之前的轨迹

        prediction = torch.max(F.softmax(out), )[]#转换为概率,后面的一是最大值索引,如果为0则返回最大值

        pred_y = prediction.data.numpy().squeeze()

        target_y = y.data.numpy()

        plt.scatter(x.data.numpy()[:, ], x.data.numpy()[:, ], c=pred_y, s=, lw=, cmap='RdYlGn')

        accuracy = sum(pred_y == target_y) / .#求准确率

        plt.text(1.5, -, 'Accuracy=%.2f' % accuracy, fontdict={'size': , 'color': 'red'})

        plt.pause(0.1)

plt.ioff()

plt.show()
莫烦PyTorch学习笔记(五)——分类的更多相关文章
- 莫烦PyTorch学习笔记(五)——模型的存取
import torch from torch.autograd import Variable import matplotlib.pyplot as plt torch.manual_seed() ...
- 莫烦pytorch学习笔记(八)——卷积神经网络(手写数字识别实现)
莫烦视频网址 这个代码实现了预测和可视化 import os # third-party library import torch import torch.nn as nn import torch ...
- 莫烦pytorch学习笔记(七)——Optimizer优化器
各种优化器的比较 莫烦的对各种优化通俗理解的视频 import torch import torch.utils.data as Data import torch.nn.functional as ...
- 莫烦PyTorch学习笔记(六)——批处理
1.要点 Torch 中提供了一种帮你整理你的数据结构的好东西, 叫做 DataLoader, 我们能用它来包装自己的数据, 进行批训练. 而且批训练可以有很多种途径. 2.DataLoader Da ...
- 莫烦pytorch学习笔记(二)——variable
.简介 torch.autograd.Variable是Autograd的核心类,它封装了Tensor,并整合了反向传播的相关实现 Variable和tensor的区别和联系 Variable是篮子, ...
- 莫烦PyTorch学习笔记(三)——激励函数
1. sigmod函数 函数公式和图表如下图 在sigmod函数中我们可以看到,其输出是在(0,1)这个开区间内,这点很有意思,可以联想到概率,但是严格意义上讲,不要当成概率.sigmod函数 ...
- 莫烦 - Pytorch学习笔记 [ 二 ] CNN ( 1 )
CNN原理和结构 观点提出 关于照片的三种观点引出了CNN的作用. 局部性:某一特征只出现在一张image的局部位置中. 相同性: 同一特征重复出现.例如鸟的羽毛. 不变性:subsampling下图 ...
- 莫烦 - Pytorch学习笔记 [ 一 ]
1. Numpy VS Torch #相互转换 np_data = torch_data.numpy() torch_data = torch.from_numpy(np_data) #abs dat ...
- 莫烦PyTorch学习笔记(四)——回归
下面的代码说明个整个神经网络模拟回归的过程,代码含有详细注释,直接贴下来了 import torch from torch.autograd import Variable import torch. ...
随机推荐
- 新建的maven项目里没有src
百度上搜到一个网友的一句话:没筷子你就不吃饭了是吧 若有所思 自己新建一个src文件 然后, 由于已经转换,因此上图没有sources选项 然后就可以在文件中随意编写文件 如果想添加package,直 ...
- 20140319 const sizeof define 编译时分配内存
1.面试宝典预处理,const,sizeof Define作用定义函数: //用一个宏定义FIND求一个结构体struc里某个变量相对于struc的偏移量,如FIND(student,a)//等于0 ...
- IDEA @Autowired dao大红波浪线
SptingBoot+Mybatis开发通常在dao层的注解是@Mapper 这样每次在ServiceImpl层加注解@Autowired时,注入的dao总是波浪线烦人,其实并没有错,只是idea你太 ...
- 史上最全Html和CSS布局技巧
单列布局水平居中 水平居中的页面布局中最为常见的一种布局形式,多出现于标题,以及内容区域的组织形式,下面介绍四种实现水平居中的方法(注:下面各个实例中实现的是child元素的对齐操作,child元 ...
- Day9 - 异步IO\数据库\队列\缓存
本节内容 Gevent协程 Select\Poll\Epoll异步IO与事件驱动 Python连接Mysql数据库操作 RabbitMQ队列 Redis\Memcached缓存 Paramiko SS ...
- adb shell 查看内存信息
1.根据包名来查看指定的APP指定数据adb shell "top | grep com.xxx.xxx" 由于这样打印出来的数据没有参数名,可以参考这个命令来看:adb shel ...
- Codeforces Round #526 C - The Fair Nut and String /// 组合递推
题目大意: 给定原字符序列 找出其中所有子序列满足 1.序列内字符都为a 2.若有两个以上的字符 则相邻两个字符在原序列中两者之间存在字符b 的数量 将整个字符序列用b分开 此时再得到每个b之间a的数 ...
- Codeforces Round #525 D - Ehab and another another xor problem /// 构造
题目大意: 本题有两个隐藏起来的a b(1<=a,b<=1e30) 每次可 printf("? %d %d\n",c,d); 表示询问 a^c 与 b^d 的相对大小 ...
- python自动化基础(参数化)
一.创建加法类 #定义一个数学加法类 class Mathmethod(): def add(self,a,b): return(a+b) def sub(self,a,b): return(a-b) ...
- 查看Linux服务器公网IP
参考:https://www.cnblogs.com/pyyu/p/8545896.html 方法1:curl ifconfig.me 方法2:curl cip.cc