
自己写的数据交换工具——从Oracle到Elasticsearch
先说说需求的背景,由于业务数据都在Oracle数据库中,想要对它进行数据的分析会非常非常慢,用传统的数据仓库-->数据集市这种方式,集市层表会非常大,查询的时候如果再做一些group的操作,一个访问需要一分钟甚至更久才能响应。
为了解决这个问题,就想把业务库的数据迁移到Elasticsearch中,然后针对es再去做聚合查询。
问题来了,数据库中的数据量很大,如何导入到ES中呢?
Logstash JDBC
Logstash提供了一款JDBC的插件,可以在里面写sql语句,自动查询然后导入到ES中。这种方式比较简单,需要注意的就是需要用户自己下载jdbc的驱动jar包。
input {

	jdbc {

		jdbc_driver_library => "ojdbc14-10.2.0.3.0.jar"

		jdbc_driver_class => "Java::oracle.jdbc.driver.OracleDriver"

		jdbc_connection_string => "jdbc:oracle:thin:@localhost:1521:test"

		jdbc_user => "test"

		jdbc_password => "test123"

		schedule => "* * * * *"

		statement => "select * from TARGET_TABLE"

		add_field => ["type","a"]

	}

}

output{

	elasticsearch {

		hosts =>["10.10.1.205:9200"]

		index => "product"

		document_type => "%{type}"

	}

}
不过,它的性能实在是太差了!我导了一天,才导了两百多万的数据。
因此,就考虑自己来导。
自己的数据交换工具
思路:
- 1 采用JDBC的方式,通过分页读取数据库的全部数据。
- 2 数据库读取的数据存储成bulk形式的数据,关于bulk需要的文件格式,可以参考这里
- 3 利用bulk命令分批导入到es中
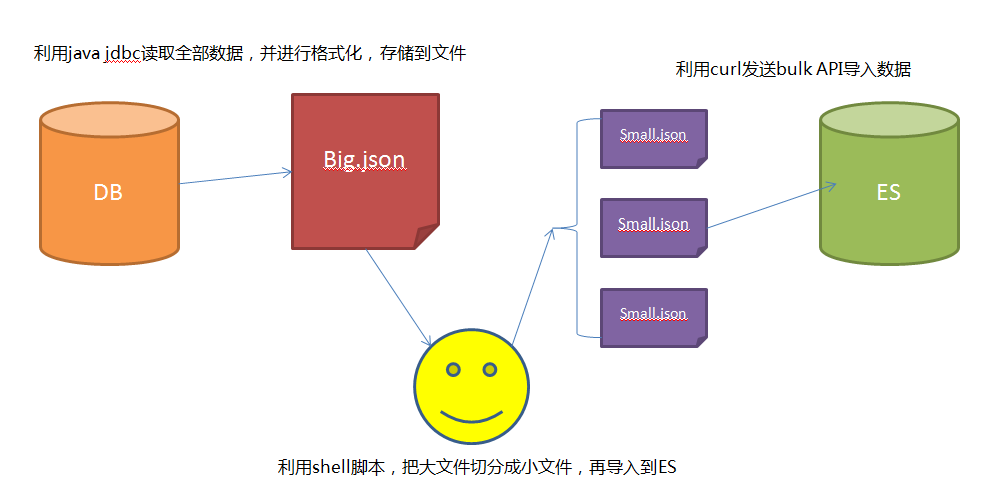
最后使用发现,自己写的导入程序,比Logstash jdbc快5-6倍~~~~~~ 嗨皮!!!!
遇到的问题
- 1 JDBC需要采用分页的方式读取全量数据
- 2 要模仿bulk文件进行存储
- 3 由于bulk文件过大,导致curl内存溢出
程序开源
下面的代码需要注意的就是
public class JDBCUtil {

    private static Connection conn = null;

    private static PreparedStatement sta=null;

    static{

        try {

            Class.forName("oracle.jdbc.driver.OracleDriver");

            conn = DriverManager.getConnection("jdbc:oracle:thin:@localhost:1521:test", "test", "test123");

        } catch (ClassNotFoundException e) {

            e.printStackTrace();

        } catch (SQLException e) {

            e.printStackTrace();

        }

        System.out.println("Database connection established");

    }

    /**

    * 把查到的数据格式化写入到文件

    *

    * @param list 需要存储的数据

    * @param index 索引的名称

    * @param type 类型的名称

    * @param path 文件存储的路径

    **/

    public static void writeTable(List<Map> list,String index,String type,String path) throws SQLException, IOException {

        System.out.println("开始写文件");

        File file = new File(path);

        int count = 0;

        int size = list.size();

        for(Map map : list){

            FileUtils.write(file,  "{ \"index\" : { \"_index\" : \""+index+"\", \"_type\" : \""+type+"\" } }\n","UTF-8",true);

            FileUtils.write(file, JSON.toJSONString(map)+"\n","UTF-8",true);

//            System.out.println("写入了" + ((count++)+1) + "[" + size + "]");

        }

        System.out.println("写入完成");

    }

    /**

     * 读取数据

     * @param sql

     * @return

     * @throws SQLException

     */

    public static List<Map> readTable(String tablename,int start,int end) throws SQLException {

        System.out.println("开始读数据库");

        //执行查询

        sta = conn.prepareStatement("select * from(select rownum as rn,t.* from "+tablename+" t )where rn >="+start+" and rn <"+end);

        ResultSet rs = sta.executeQuery();

        //获取数据列表

        List<Map> data = new ArrayList();

        List<String> columnLabels = getColumnLabels(rs);

        Map<String, Object> map = null;

        while(rs.next()){

            map = new HashMap<String, Object>();

            for (String columnLabel : columnLabels) {

                Object value = rs.getObject(columnLabel);

                map.put(columnLabel.toLowerCase(), value);

            }

            data.add(map);

        }

        sta.close();

        System.out.println("数据读取完毕");

        return data;

    }

    /**

     * 获得列名

     * @param resultSet

     * @return

     * @throws SQLException

     */

    private static List<String> getColumnLabels(ResultSet resultSet)

            throws SQLException {

        List<String> labels = new ArrayList<String>();

        ResultSetMetaData rsmd = (ResultSetMetaData) resultSet.getMetaData();

        for (int i = 0; i < rsmd.getColumnCount(); i++) {

            labels.add(rsmd.getColumnLabel(i + 1));

        }

        return labels;

    }

    /**

    * 获得数据库表的总数,方便进行分页

    *

    * @param tablename 表名

    */

    public static int count(String tablename) throws SQLException {

        int count = 0;

        Statement stmt = conn.createStatement(ResultSet.TYPE_SCROLL_INSENSITIVE, ResultSet.CONCUR_UPDATABLE);

        ResultSet rs = stmt.executeQuery("select count(1) from "+tablename);

        while (rs.next()) {

            count = rs.getInt(1);

        }

        System.out.println("Total Size = " + count);

        rs.close();

        stmt.close();

        return count;

    }

    /**

     * 执行查询,并持久化文件

     *

     * @param tablename 导出的表明

     * @param page 分页的大小

     * @param path 文件的路径

     * @param index 索引的名称

     * @param type 类型的名称

     * @return

     * @throws SQLException

     */

    public static void readDataByPage(String tablename,int page,String path,String index,String type) throws SQLException, IOException {

        int count = count(tablename);

        int i =0;

        for(i =0;i<count;){

            List<Map> map = JDBCUtil.readTable(tablename,i,i+page);

            JDBCUtil.writeTable(map,index,type,path);

            i+=page;

        }

    }

}
在main方法中传入必要的参数即可:
public class Main {

    public static void main(String[] args) {

        try {

            JDBCUtil.readDataByPage("TABLE_NAME",1000,"D://data.json","index","type");

        } catch (SQLException e) {

            e.printStackTrace();

        } catch (IOException e) {

            e.printStackTrace();

        }

    }

}
这样得到bulk的数据后,就可以运行脚本分批导入了。
下面脚本的思路,就是每100000行左右的数据导入到一个目标文件,使用bulk命令导入到es中。注意一个细节就是不能随意的切分文件,因为bulk的文件是两行为一条数据的。
#!/bin/bash

count=0

rm target.json

touch target.json

while read line;do

((count++))

{

        echo $line >> target.json

        if [ $count -gt 100000 ] && [ $((count%2)) -eq 0 ];then

                count=0

                curl -XPOST localhost:9200/_bulk --data-binary @target.json > /dev/null

                rm target.json

                touch target.json

        fi

}

done < $1

echo 'last submit'

curl -XPOST localhost:9200/_bulk --data-binary @target.json > /dev/null
最后执行脚本:
sh auto_bulk.sh data.json
自己测试最后要比logstasj jdbc快5-6倍。
自己写的数据交换工具——从Oracle到Elasticsearch的更多相关文章
- 从Oracle到Elasticsearch
自己写的数据交换工具——从Oracle到Elasticsearch 自己写的数据交换工具——从Oracle到Elasticsearch 先说说需求的背景,由于业务数据都在Oracle数据库中,想要 ...
- 数据交换工具Kettle
网上搜集了一些关于开源数据交换工具Kattle的文章,特收藏例如以下: 文章一:ETL和Kettle简单介绍 ETL即数据抽取(Extract).转换(Transform).装载(Load)的过程.它 ...
- 数据导入导出Oracle数据库
临近春节,接到了一个导入数据的任务,在Linux客户端中的数据有50G,大约3亿3千万行: 刚开始很天真,把原始的txt/csv文件用sh脚本转化成了oralce 的insert into 语句,然后 ...
- Oracle和Elasticsearch数据同步
Python编写Oracle和Elasticsearch数据同步脚本 标签: elasticsearchoraclecx_Oraclepython数据同步 Python知识库 一.版本 Pyth ...
- Java代码实现excel数据导入到Oracle
1.首先需要两个jar包jxl.jar,ojdbc.jar(注意版本,版本不合适会报版本错误)2.代码: Java代码 import java.io.File; import java.io.Fi ...
- SQL SERVER 2000/2005/2008数据库数据迁移到Oracle 10G细述
最近参与的一个系统涉及到把SQL Server 2k的数据迁移到Oracle 10G这一非功能需求.特将涉及到相关步骤列举如下供大家参考: 环境及现有资源: 1.OS: Windows 7 Enter ...
- Netty中如何写大型数据
因为网络饱和的可能性,如何在异步框架中高效地写大块的数据是一个特殊的问题.由于写操作是非阻塞的,所以即使没有写出所有的数据,写操作也会在完成时返回并通知ChannelFuture.当这种情况发生时,如 ...
- excel文件与txt文件互转,并且把excel里的数据导入到oracle中
一.excel文件转换成txt文件的步骤 a.首先要把excel文件转换成txt文件 1.Excel另存为中已经包含了TXT格式,所以我们可以直接将Excel表格另存为TXT格式,但是最后的效果好像不 ...
- 通过hive向写elasticsearch的写如数据
通过hive向写elasticsearch的写如数据 hive 和 elasticsearch 的整合可以参考官方的文档: ES-hadoop的hive整合 : https://www.elastic ...
随机推荐
- ASP.NET Aries 入门开发教程8:树型列表及自定义右键菜单
前言: 前面几篇重点都在讲普通列表的相关操作. 本篇主要讲树型列表的操作. 框架在设计时,已经把树型列表和普通列表全面统一了操作,用法几乎是一致的. 下面介绍一些差距化的内容: 1:树型列表绑定: v ...
- 我为NET狂官方面试题-数据库篇答案
题目:http://www.cnblogs.com/dunitian/p/6028838.html 汇总:http://www.cnblogs.com/dunitian/p/5977425.html ...
- PHP验证用户登录例子-学习笔记
1.基本流程: 2.UML类图: 3.PHP代码: 3.1 index.php <?php /** * Created by PhpStorm. * User: andy * Date: 16- ...
- 【解决方案】Myeclipse 10 安装 GIT 插件 集成 步骤 图解
工程开发中,往往要使用到集成GIT ,那么下面说说插件安装步骤 PS:以Myeclipse 10 为例,讲解集成安装步骤. ----------------------main------------ ...
- jQuery学习之路(6)- 简单的表格应用
▓▓▓▓▓▓ 大致介绍 在CSS技术之前,网页的布局基本都是依靠表格制作,当有了CSS之后,表格就被很多设计师所抛弃,但是表格也有他的用武之地,比如数据列表,下面以表格中常见的几个应用来加深对jQue ...
- MVC常遇见的几个场景代码分享
本次主要分享几个场景的处理代码,有更好处理方式多多交流,相互促进进步:代码由来主要是这几天使用前端Ace框架做后台管理系统,这Ace是H5框架里面的控件效果挺多的,做兼容也很好,有点遗憾是控件效果基本 ...
- DDD 领域驱动设计-两个实体的碰撞火花
上一篇:<DDD 领域驱动设计-领域模型中的用户设计?> 开源地址:https://github.com/yuezhongxin/CNBlogs.Apply.Sample(代码已更新) 在 ...
- 简记某WebGIS项目的优化之路
文章版权由作者李晓晖和博客园共有,若转载请于明显处标明出处:http://www.cnblogs.com/naaoveGIS/ 1. 背景 该项目为研究生时的老师牵头,个人已毕业数年,应老师要求协助其 ...
- js从数组中随机取出不同的元素
前言 上午处理个需求需要从一个总数组中随机取出不同的元素.共使用两个方法.第一种方法较常规,经测试有bug,数据量大以后随机几次返回的对象直接是function而不是object. 当然简单数据类型应 ...
- CSS 3学习——box-sizing和背景
box-sizing 在CSS 2中设置元素的width和height仅仅是设置了元素内容区的宽和高,元素实际的尺寸是margin + border + padding + 内容区. CSS 3(截止 ...