
爬 NationalData ,虽然可以直接下,但还是爬一下吧
爬取的是分省月度数据,2017年的,包括:居民消费价格指数,食品烟酒类居民消费价格指数,衣着类居民消费价格指数,居住类居民消费价格指数,生活用品及服务类居民消费价格指数,交通和通信类居民消费价格指数,教育文化和娱乐类居民消费价格指数,医疗保健类居民消费价格指数,其他用品和服务类居民消费价格指数。
打开网站,地区数据-----分省月度数据,如图:
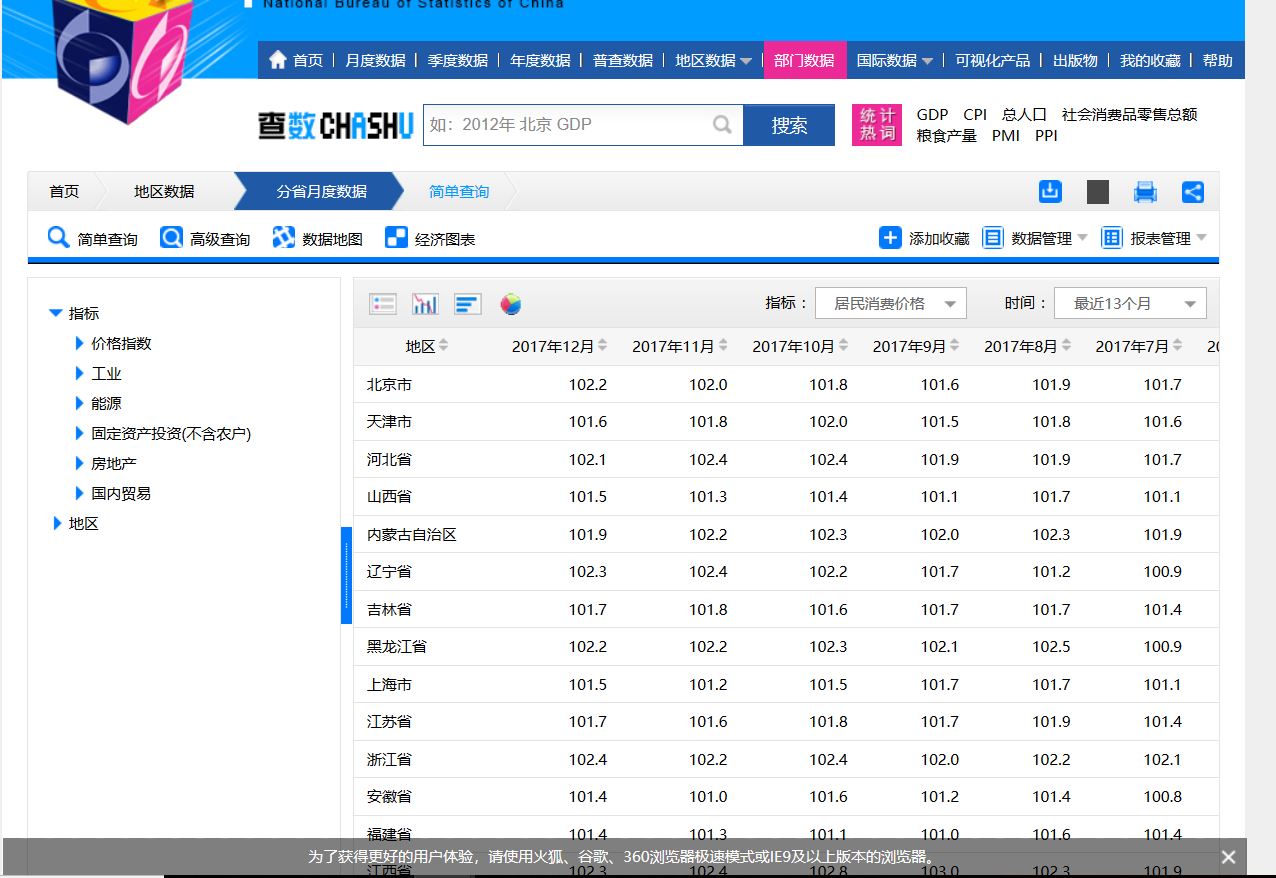
按F12,在按F5会出现3个请求url:
1:http://data.stats.gov.cn/easyquery.htm
2:http://data.stats.gov.cn/easyquery.htm?m=getOtherWds&dbcode=fsyd&rowcode=reg&colcode=sj&wds=[]&k1=1516511359046
3:http://data.stats.gov.cn/easyquery.htm?m=QueryData&dbcode=fsyd&rowcode=reg&colcode=sj&wds=[{"wdcode":"zb","valuecode":"A01010101"}]&dfwds=[]&k1=1516511359249
这三个请求url都有用,但这个爬虫只用了两个:2,3
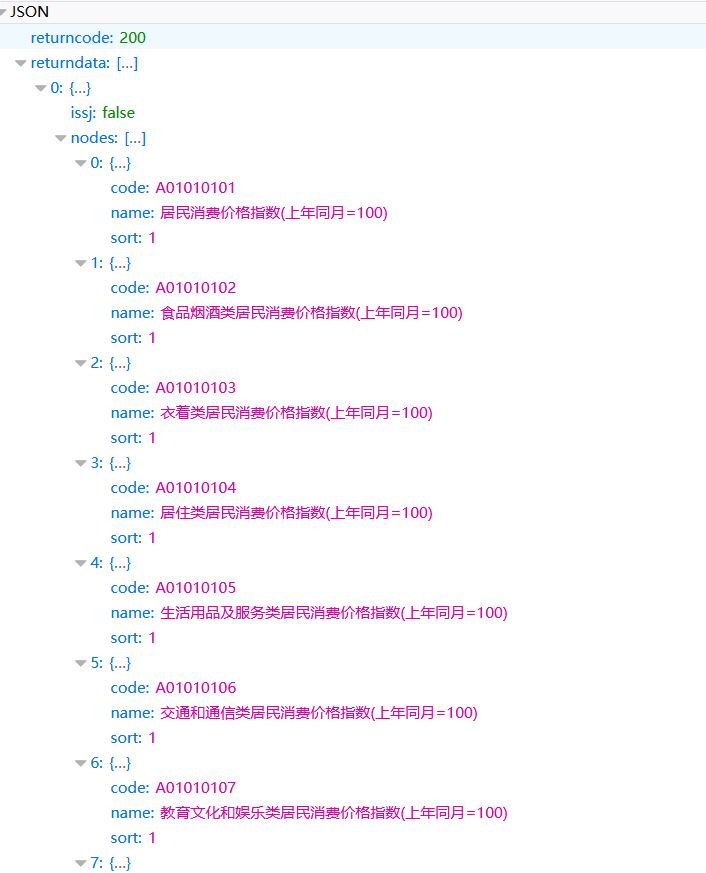
2的效果图:
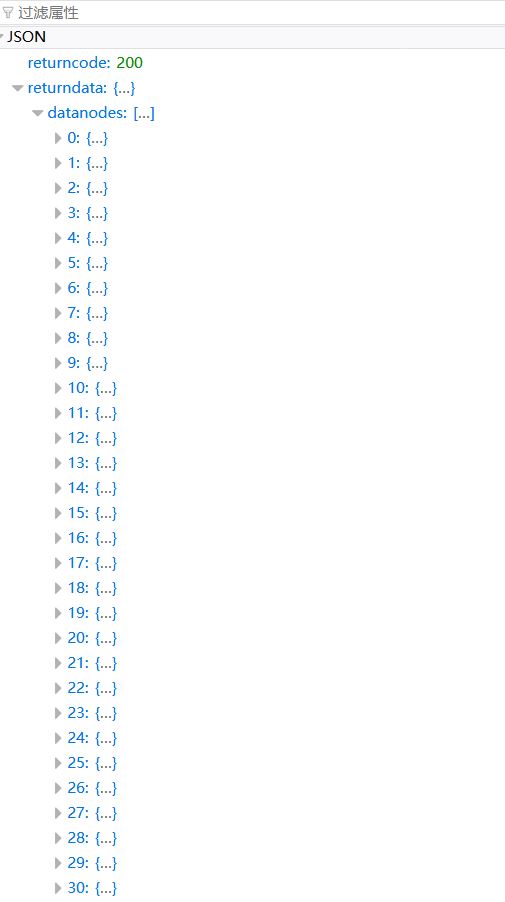
3的效果图:
代码如下:
import urllib
from  urllib import request
from json import loads
import pymssql

# 发起请求
def getRequestBody(url):
    return urllib.request.urlopen(url).read().decode('utf8')
# 获取指标类型
def getTarget(url):
    body = getRequestBody(url)
    print('body', body)
    dicts = loads(body)
    return dicts['returndata']

url = 'http://data.stats.gov.cn/easyquery.htm?m=getOtherWds&dbcode=fsyd&rowcode=reg&colcode=sj&wds=[]&k1=1516507560165'
targetList_returnData = getTarget(url)    # list
print('targetList_returnData',targetList_returnData)
for targetIndex_returnData in range(len(targetList_returnData)):
    targetDict_returnData = dict(targetList_returnData[targetIndex_returnData])    # dict
    targetList_nodes = targetDict_returnData['nodes']    # list
    # 请求无法得到,但却有,只能硬来了
    targetList_nodes.append({'code': 'A01010106', 'name': '交通和通信类居民消费价格指数(上年同月=100)', 'sort': '1'})
    targetList_nodes.append({'code': 'A01010107', 'name': '教育文化和娱乐类居民消费价格指数(上年同月=100)', 'sort': '1'})
    targetList_nodes.append({'code': 'A01010108', 'name': '医疗保健类居民消费价格指数(上年同月=100)', 'sort': '1'})
    targetList_nodes.append({'code': 'A01010109', 'name': '其他用品和服务类居民消费价格指数(上年同月=100)', 'sort': '1'})
    print('targetList_nodes',targetList_nodes)
    for targetIndex_nodes in range(len(targetList_nodes)):
        targetDict_nodes = dict(targetList_nodes[targetIndex_nodes])    # dict
        print(targetDict_nodes['code'],targetDict_nodes['name'])
        #
        url1 = 'http://data.stats.gov.cn/easyquery.htm?m=QueryData&dbcode=fsyd&rowcode=reg&colcode=sj' \
               '&wds=[{"wdcode":"zb","valuecode":"%s"}]&dfwds=[]' %(targetDict_nodes['code'])
        body1 = getRequestBody(url1)
        print('body1',body1)
        dictAll = loads(body1)
        # 获取wdnodes键的name,以name当表名
        dataList2 = dictAll['returndata']['wdnodes']
        dataList2.pop()
        name = dataList2[0]['nodes'][0]['cname']
        if name.find('(') != -1:
            name = name[:name.find('(')] + '2017'
        print(name)
        # 获取wdnodes键的地区
        regionList = dataList2[1]['nodes']
        # 获取datanodes键的内容
        dataList1 = dictAll['returndata']['datanodes']
        # 控制遍历,以删除2016年12月的数据,只要2017年的数据
        index = 1
        # 控制插入的地区
        region = 0
        # 存储具体数据
        data = []
        for dataIndex1 in range(len(dataList1)):
            if index <= 12:
                # 获取‘datanodes’的指数数据
                data_f = dataList1[dataIndex1]['data']['data']
                print(data_f,index)
                data.append(data_f)
                conn = pymssql.connect(host='localhost', user='sa', password='123456c', database='NationalData', charset='utf8')
                cur = conn.cursor()
                if index == 12:
                    print(regionList[region]['cname'])
                    sql ='''insert into {} values('{}',{},{},{},{},{},{},{},{},{},{},{},{});'''\
                        .format(name,regionList[region]['cname'],data[0],data[1],data[2],data[3],data[4],data[5],data[6],data[7],data[8],data[9],data[10],data[11])
                    region += 1
                    cur.execute(sql)
                    conn.commit()
                    cur.close()
                    conn.close()
            elif index == 13:
                data = []
                index = 0
            index += 1
    break
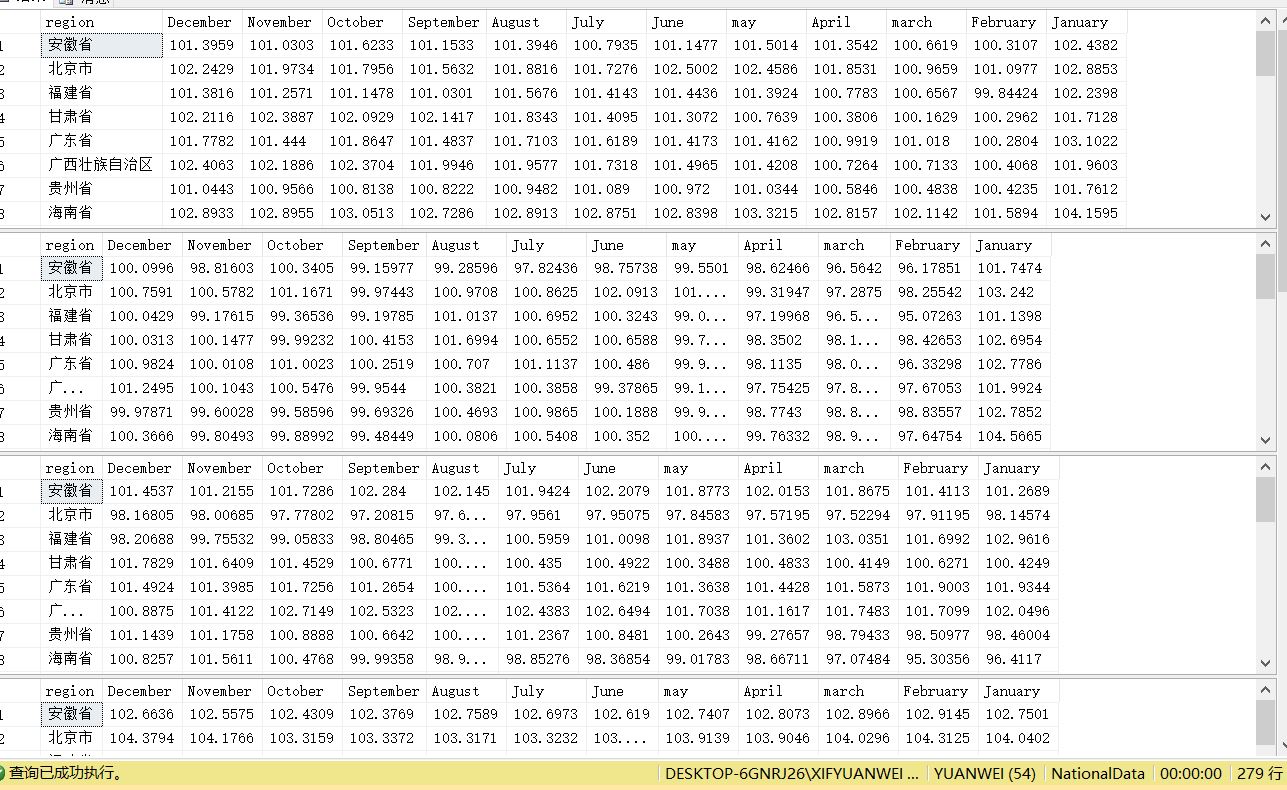
数据库有如下表:
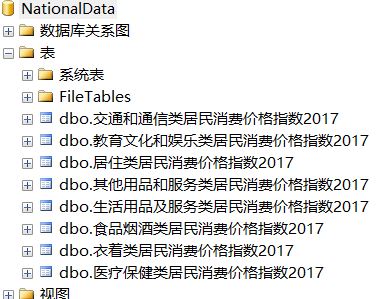
结果:
爬 NationalData ,虽然可以直接下,但还是爬一下吧的更多相关文章
- 安居客scrapy房产信息爬取到数据可视化(下)-可视化代码
接上篇:安居客scrapy房产信息爬取到数据可视化(下)-可视化代码,可视化的实现~ 先看看保存的数据吧~ 本人之前都是习惯把爬到的数据保存到本地json文件, 这次保存到数据库后发现使用mongod ...
- 一个简单的爬取b站up下所有视频的所有评论信息的爬虫
心血来潮搞了一个简单的爬虫,主要是想知道某个人的b站账号,但是你知道,b站在搜索一个用户时,如果这个用户没有投过稿,是搜不到的,,,这时就只能想方法搞到对方的mid,,就是 space.bilibil ...
- MOJITO 发布一周,爬一波弹幕分析下
MOJITO 最近一直啥都没写,追个热点都赶不上热乎的,鄙视自己一下. 周董的新歌 「MOJITO」 发售(6 月 12 日的零点)至今大致过去了一周,翻开 B 站 MV 一看,播放量妥妥破千万,弹幕 ...
- (4)分布式下的爬虫Scrapy应该如何做-规则自动爬取及命令行下传参
本次探讨的主题是规则爬取的实现及命令行下的自定义参数的传递,规则下的爬虫在我看来才是真正意义上的爬虫. 我们选从逻辑上来看,这种爬虫是如何工作的: 我们给定一个起点的url link ,进入页面之后提 ...
- python3爬虫爬取猫眼电影TOP100(含详细爬取思路)
待爬取的网页地址为https://maoyan.com/board/4,本次以requests.BeautifulSoup css selector为路线进行爬取,最终目的是把影片排名.图片.名称.演 ...
- Scrapy 实现爬取多页数据 + 多层url数据爬取
项目需求:爬取https://www.4567tv.tv/frim/index1.html网站前三页的电影名称和电影的导演名称 项目分析:电影名称在初次发的url返回的response中可以获取,可以 ...
- python爬虫---CrawlSpider实现的全站数据的爬取,分布式,增量式,所有的反爬机制
CrawlSpider实现的全站数据的爬取 新建一个工程 cd 工程 创建爬虫文件:scrapy genspider -t crawl spiderName www.xxx.com 连接提取器Link ...
- python爬取实习僧招聘信息字体反爬
参考博客:http://www.cnblogs.com/eastonliu/p/9925652.html 实习僧招聘的网站采用了字体反爬,在页面上显示正常,查看源码关键信息乱码,如下图所示: 查看网页 ...
- Python反爬:利用js逆向和woff文件爬取猫眼电影评分信息
首先:看看运行结果效果如何! 1. 实现思路 小编基本实现思路如下: 利用js逆向模拟请求得到电影评分的页面(就是猫眼电影的评分信息并不是我们上述看到的那个页面上,应该它的实现是在一个页面上插入另外一 ...
随机推荐
- phpexcel导出成绩表
效果图如下: 代码如下:代码注释不全,请大家参考phpexcel中文帮助手册 <?php require_once 'PHPExcel.php'; function bfb($n) { retu ...
- windows下查看端口占用情况及关闭相应的进程
经常,我们在启动应用的时候发现系统需要的端口被别的程序占用,如何知道谁占有了我们需要的端口,很多人都比较头疼,下面就介绍一种非常简单的方法. 例如:需要查看9001端口被谁占用,并将其进程强制关闭 在 ...
- 快速开发基于 HTML5 网络拓扑图应用1
今天开始我们就从最基础解析如何构建 HTML5 Canvas 拓扑图应用,HT 内部封装了一个拓扑图形组件 ht.graph.GraphView(以下简称 GraphView)是 HT 框架中 2D ...
- 为什么树莓派不会受到 Spectre 和 Meltdown 攻击
最近爆出来的 Intel CPU 的底层漏洞可谓是影响巨大,过去20年的电脑都可能会受影响.前几天 Raspberry Pi 的官方 Twitter(@Raspberry_Pi) 转推了这篇文章,通过 ...
- MyEclipse 2015利用Cygwin+CDT搭建C/C++开发环境
GitHub原文:https://github.com/x113773/testall/issues/22 首先安装Cygwin 1:首先去网站 www.cygwin.com 下载 Cygwin 的 ...
- 初学Python之 布尔类型
与运算:只有两个布尔值都为 True 时,计算结果才为 True. True and True # ==> True True and False # ==> False False an ...
- BitCoin p2p通信过程
众所周知,Bitcoin是建立在p2p网络上的,但是具体的通信过程一直没有搞懂,所以特意去bitcoin的Developer Guid上去了解了一下.由于本人英文水平有限,理解难免有偏差的地方,希望大 ...
- CI_SMOKE配置手册
1.1. SVN安装 安装TortoiseSVN,并检出AutoScript目录至本地 1.2. Java环境安装 确认测试环境安装了JDK,在cmd下键入java -version 检查JDK是 ...
- bootstrapru软件官网
一 bootstrap:http://v3.bootcss.com/ 二 起步:http://v3.bootcss.com/getting-started/ 三 全局css样式:htt ...
- asp.net mvc 5 蛋疼的问题
看图,debugger显示匹配路径没有错. html开源码看 显示没有实现IController. 然而我的确实现了. 关闭vs 重启