
单个图片获取-爬取网易"数读"信息数据(暴涨的房租,正在摧毁中国年轻人的生活)
参考链接:https://www.makcyun.top/web_scraping_withpython3.html
该网页其实有16张图片,但是因为页面数据中某处多个空白,导致参考链接中的方式只有15张图片,并且亲测有些方式能用,有些方式不能用,特此记录一下
正常显示:

不正常显示:
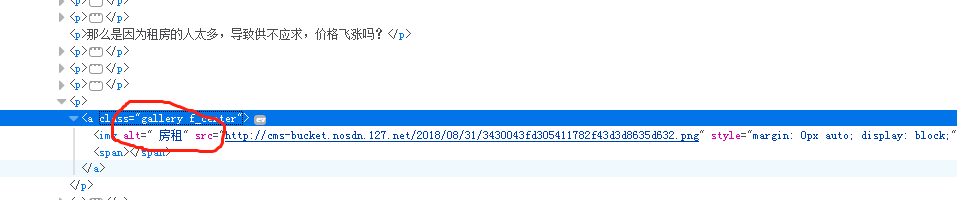
#!/usr/bin/env python

# -*- coding: utf-8 -*-

import random

import re

import requests

from bs4 import BeautifulSoup

from lxml import etree

from pyquery import PyQuery as pq

from requests import RequestException

headers = {

    'User-Agent': 'Mozilla/5.0 (Windows NT 6.1; Win64; x64; rv:60.0) Gecko/20100101 Firefox/60.0'

}

def get_one_page():

    url = 'http://data.163.com/18/0901/01/DQJ3D0D9000181IU.html'

    try:

        response = requests.get(url, headers=headers)

        if response.status_code == 200:

            return response.text

    except RequestException:

        print('网页请求失败')

        return None

### 如下是解析网页数据的5中方式

# 正则表达式

def parse_one_page1(html):

    pattern = re.compile('<img alt=".*?租" src="(.*?)"', re.S)

    items = re.findall(pattern, html)

    for item in items:

        yield {

            'url': item

        }

# Xpath语法 # 使用这个('*//p//img[@alt = "房租"]/@src') 则结果只有15条,因为有个alt参数中房租前面有空格

def parse_one_page2(html):

    parse = etree.HTML(html)

    items = parse.xpath('*//img[@style="margin: 0px auto; display: block;" ]/@src')

    for item in items:

        yield {

            'url': item

        }

# CSS选择器,结果有8条,还有待研究

def parse_one_page3(html):

    soup = BeautifulSoup(html, 'lxml')

    items = soup.select('p a img')

    # print(items)

    for item in items:

        yield {

            'url': item['src']

        }

# Beautiful Soup + find_all函数提取 结果有8条,还有待研究

def parse_one_page4(html):

    soup = BeautifulSoup(html, 'lxml')

    item = soup.find_all(attrs={'width': '100%', 'style': 'margin: 0px auto; display: block;'})

    print(item)

    for i in range(len(item)):

        url = item[i].attrs['src']

        yield {

            'url': url

        }

# PyQuery

def parse_one_page5(html):

    data = pq(html)

    data2 = data('p>a>img')

    for item in data2.items():

        yield {

            'url': item.attr('src')

        }

def download_thumb(url, name):

    print(url, name)

    try:

        response = requests.get(url)

        with open(name + '.jpg', 'wb') as f:

            f.write(response.content)

    except RequestException as e:

        print(e)

        pass

def main():

    html = get_one_page()

    items = parse_one_page5(html)

    for item in items:

        # print(item['url'])

        download_thumb(item['url'], str(random.randint(1, 1000)))

if __name__ == '__main__':

    main()
注:下载保存图片的函数还能再优化一下,不过懒得弄了,直接上随机数,哈哈
单个图片获取-爬取网易"数读"信息数据(暴涨的房租,正在摧毁中国年轻人的生活)的更多相关文章
- python爬取豆瓣电影信息数据
题外话+ 大家好啊,最近自己在做一个属于自己的博客网站(准备辞职回家养老了,明年再战)在家里 琐事也很多, 加上自己 一回到家就懒了(主要是家里冷啊! 广东十几度,老家几度,躲在被窝瑟瑟发抖,) 由于 ...
- Python scrapy框架爬取瓜子二手车信息数据
项目实施依赖: python,scrapy ,fiddler scrapy安装依赖的包: 可以到https://www.lfd.uci.edu/~gohlke/pythonlibs/ 下载 pywi ...
- 使用Jsoup 爬取网易首页所有的图片
package com.enation.newtest; import java.io.File; import java.io.FileNotFoundException; import java. ...
- 爬虫—Selenium爬取JD商品信息
一,抓取分析 本次目标是爬取京东商品信息,包括商品的图片,名称,价格,评价人数,店铺名称.抓取入口就是京东的搜索页面,这个链接可以通过直接构造参数访问https://search.jd.com/Sea ...
- 如何利用python爬取网易新闻
前言 本文的文字及图片来源于网络,仅供学习.交流使用,不具有任何商业用途,版权归原作者所有,如有问题请及时联系我们以作处理. 作者: LSGOGroup PS:如有需要Python学习资料的小伙伴可以 ...
- 爬虫系列2:Requests+Xpath 爬取租房网站信息
Requests+Xpath 爬取租房网站信息 [抓取]:参考前文 爬虫系列1:https://www.cnblogs.com/yizhiamumu/p/9451093.html [分页]:参考前文 ...
- python itchat 爬取微信好友信息
原文链接:https://mp.weixin.qq.com/s/4EXgR4GkriTnAzVxluJxmg 「itchat」一个开源的微信个人接口,今天我们就用itchat爬取微信好友信息,无图言虚 ...
- 简单的python爬虫--爬取Taobao淘女郎信息
最近在学Python的爬虫,顺便就练习了一下爬取淘宝上的淘女郎信息:手法简单,由于淘宝网站本上做了很多的防爬措施,应此效果不太好! 爬虫的入口:https://mm.taobao.com/json/r ...
- [Python学习] 简单爬取CSDN下载资源信息
这是一篇Python爬取CSDN下载资源信息的样例,主要是通过urllib2获取CSDN某个人全部资源的资源URL.资源名称.下载次数.分数等信息.写这篇文章的原因是我想获取自己的资源全部的评论信息. ...
随机推荐
- Java怎样获取Content-Type的文件类型Mime Type
在Http请求中.有时须要知道Content-Type类型,尤其是上传文件时.更为重要.尽管有些办法可以解决,但都不太准确或者繁琐,索性我发现一个开源的类库可以解决相对完美的解决问题,它就是jMime ...
- Codeforces Round #388 (Div. 2) C. Voting
题意:有n个人,每个人要么是属于D派要么就是R派的.从编号1开始按顺序,每个人都有一次机会可以剔除其他任何一个人(被剔除的人就不在序列中也就失去了剔除其他人的机会了):当轮完一遍后就再次从头从仅存的人 ...
- Mysql查看sql是否走事务
登陆进入server [root@gzmtest_25 ~]# su - mysql [mysql@gzmtest_25 ~]$ mysql.local Welcome to the MySQL mo ...
- LINQ Query Expressions
https://msdn.microsoft.com/en-us/library/bb397676(v=vs.100).aspx Language-Integrated Query (LINQ) is ...
- JAVA8与lambda表达式
一.lambda表达式的来源 Lambda 表达式(拉姆达表达式)来源于lambda演算是Alonzo Church给出的一套图灵机等价的形式计算系统.lambda演算系统以函数和变量为基础,也可以进 ...
- PCB MS SQL 排序应用---相邻数据且相同合并处理
这是一个很有趣SQL数据处理应用,具体需求如下 ERP需要工程将物料编码相邻的编码合并求和BOM用量,巧妙的用到了已有排序号与分组排序号之间的差值求解 示例: 原数据: 要求转换: 实际转换后数据: ...
- JavaScript学习二
2019-05-30 15:08:24 加油,这几天在赶高数,都…… <!DOCTYPE html> <html> <head> <script type=& ...
- HTML 打印 换页
打印 HTML 无法强制换页其实是一件很令人困扰的事,要达到这个功能其实可以透过 CSS 的 Pagebreak 来处理. 强制分页有大概只有二种用的到: { page-break-after: al ...
- POJ 2230 DFS
题意: Bessie 最近做了农场看守,他每天晚上的工作就是巡视农场并且保证没有坏人破坏农场.从谷仓出发去巡视,并且最终回到谷仓. Bessie 视力不是很好,不能像其他农场的看守一样,对农场的每一条 ...
- HDU 1166 线段树模板&树状数组模板
HDU1166 上好的线段树模板&&树状数组模板 自己写的第一棵线段树&第一棵树状数组 莫名的兴奋 线段树: #include <cstdio> using nam ...