
中国石油大学(华东)OJ题目的HTML爬取
这几天刷华东OJ的题,写博客还要复制HTML的代码,感觉麻烦的一批,然后就去摸鱼写了个小爬虫。。
看一下运行效果吧~

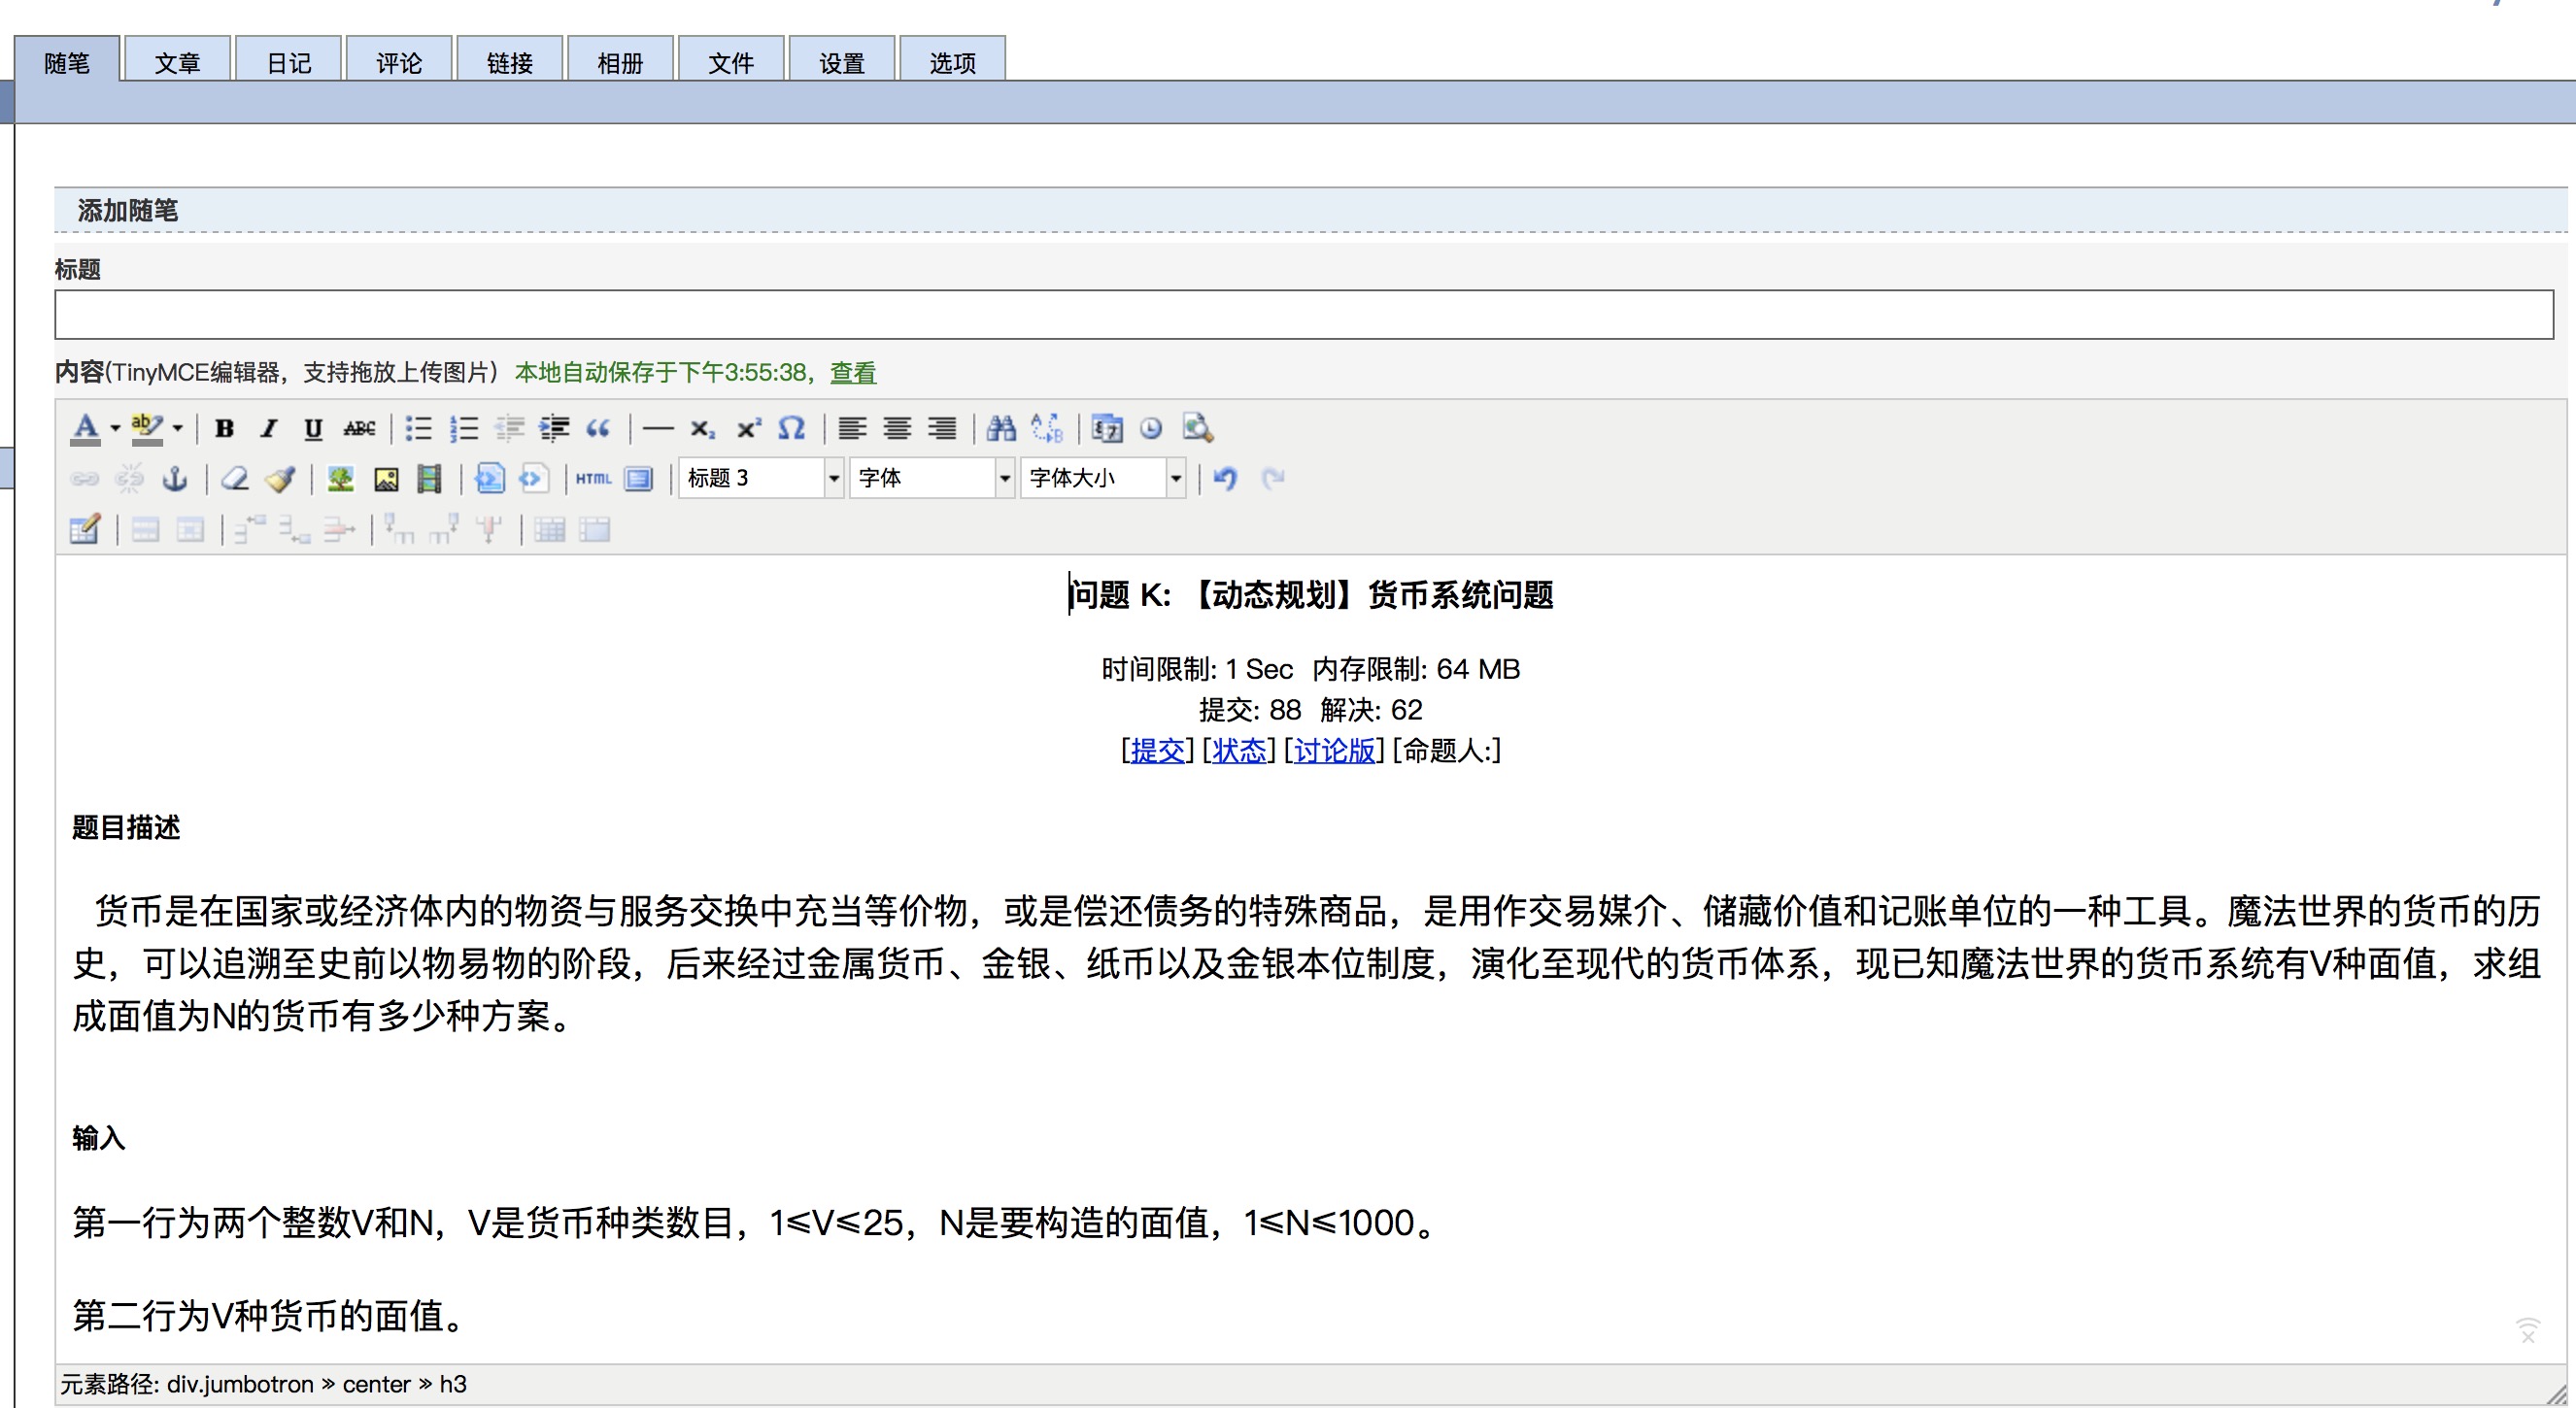
输入详细的pid、cid或id即可爬取相应的html代码
一些注意要点:
关键的还是登陆问题,程序需要在同文件夹下添加一个“headers.csv”文件用于更新和保存cookie,内容包括浏览器标头和cookie就好。也可以看我的。。。

程序提示需要输入新的cookie时去浏览器登录一下把cookie复制进去就好。(什么,你不知道cookie从哪找?那你知道羊驼为什么会淹死吗?)
源码:
import requests

from requests.exceptions import RequestException

import re

import csv

#读入headers

headers = {}

with open('headers.csv', 'r') as f:

    rawinfos = list(csv.reader(f))

    for i in rawinfos:

        headers[i[0]] = i[1]

def get_one_page(url, headers):

    #获取页面HTML

    try:

        response = requests.get(url, headers=headers)

        if response.status_code == 200:

            response.encoding = 'utf-8'

            return response.text

        return None

    except RequestException:

        return None

#选择题目

flag = int(input("是否为专题题目(0/1):"))

if flag:

    url = "http://exam.upc.edu.cn/problem.php?cid=" + input("专题(cid):") + "&pid=" + input("题号(pid):")

else:

    url = "http://exam.upc.edu.cn/problem.php?id=" + input("题号(id):")

#开始爬取

FLAG = False

html = get_one_page(url, headers)

while re.findall('<form id="(.*?)"', html, re.S) != []:#玄学判断cookie失效~

    #如果cookie失效,要求重新输入cookie

    headers['Cookie'] = input('your cookie may lose efficacy, input again:')

    html = get_one_page(url, headers)

    FLAG = True

if FLAG:

    #输入有效cookie后更改headers文件

    with open('headers.csv', 'w') as f:

        writer = csv.writer(f)

        for i in headers:

            data = []

            data.append(i)

            data.append(headers[i])

            writer.writerow(data)

#正则处理html内容

aim = re.findall('<!-- Main component for a primary marketing message or call to action -->(.*?)<!-- /container -->',

                 html, re.S)#匹配题目内容的HTML

rr1 = re.findall('<title>(.*?)</title>', aim[0], re.S)[0]#正则匹配第一个需要被删掉的字符串

rr2 = re.findall('<!--EndMarkForVirtualJudge-->(.*?)</center>', aim[0], re.S)[0]#正则匹配第二个需要被删除的字符串

tmp = aim[0]

#开始删除

tmp = tmp.replace("<title>" + rr1 + "</title>", '')

tmp = tmp.replace(rr2, '')

#输出处理好的HTML内容

print(tmp)
中国石油大学(华东)OJ题目的HTML爬取的更多相关文章
- 2016国赛B题小区数据爬取软件
-------------------------请以任何方式留言给作者,否则视为窃取----------------------------- 看你们找数据找的那么辛苦 我就苦逼的花了1个小时写了个 ...
- 小爬虫。爬取网站多页的通知标题并存取在txt文档里。
爬取网页中通知标题的内容展示: this is 1 page!<精算学综合>科目考试参考大纲2016年上半年研究生开题报告评议审核结果公示[答辩]2016下半年研究生论文答辩及学位评定 ...
- Python实战项目网络爬虫 之 爬取小说吧小说正文
本次实战项目适合,有一定Python语法知识的小白学员.本人也是根据一些网上的资料,自己摸索编写的内容.有不明白的童鞋,欢迎提问. 目的:爬取百度小说吧中的原创小说<猎奇师>部分小说内容 ...
- python爬取拉勾网职位数据
今天写的这篇文章是关于python爬虫简单的一个使用,选取的爬取对象是著名的招聘网站--拉钩网,由于和大家的职业息息相关,所以爬取拉钩的数据进行分析,对于职业规划和求职时的信息提供有很大的帮助. 完成 ...
- Scrapy实战篇(一)之爬取链家网成交房源数据(上)
今天,我们就以链家网南京地区为例,来学习爬取链家网的成交房源数据. 这里推荐使用火狐浏览器,并且安装firebug和firepath两款插件,你会发现,这两款插件会给我们后续的数据提取带来很大的方便. ...
- 零基础掌握百度地图兴趣点获取POI爬虫(python语言爬取)(代码篇)
好,现在进入高阶代码篇. 目的: 爬取昆明市中学的兴趣点POI. 关键词:中学 已有ak:9s5GSYZsWbMaFU8Ps2V2VWvDlDlqGaaO 昆明市坐标范围: 左下角:24.390894 ...
- Python爬虫爬取豆瓣电影之数据提取值xpath和lxml模块
工具:Python 3.6.5.PyCharm开发工具.Windows 10 操作系统.谷歌浏览器 目的:爬取豆瓣电影排行榜中电影的title.链接地址.图片.评价人数.评分等 网址:https:// ...
- 【python爬虫】对喜马拉雅上一个专辑的音频进行爬取并保存到本地
>>>内容基本框架: 1.爬虫目的 2.爬取过程 3.代码实现 4.爬取结果 >>>实验环境: python3.6版本,pycharm,电脑可上网. [一 爬虫目 ...
- Python网络爬虫——Appuim+夜神模拟器爬取得到APP课程数据
一.背景介绍 随着生产力和经济社会的发展,温饱问题基本解决,人们开始追求更高层次的精神文明,开始愿意为知识和内容付费.从2016年开始,内容付费渐渐成为时尚. 罗辑思维创始人罗振宇全力打造" ...
随机推荐
- leetcode 【 Linked List Cycle 】 python 实现
题目: Given a linked list, determine if it has a cycle in it. Follow up:Can you solve it without using ...
- 服务过美国总统竞选的非传统投票UI【demo已放出】
=============================== 更新:DEMO和分析已经放出,地址在这里 http://www.cnblogs.com/arfeizhang/p/faceoffde ...
- windows下Tomcat安装
环境Windows 64位 jdk1.8 1.Tomcat安装 官网地址:http://tomcat.apache.org/download-90.cgi 下载安装包,安装之后进行解压 2.修改htt ...
- 四 Android Capabilities讲解
本文转自:http://www.cnblogs.com/sundalian/p/5629429.html Android Capabilities讲解 1.Capabilities介绍 可以看下之 ...
- Java基础-8构造方法
一).构造方法: 在之前我们提到对象的概念以及对象的实例化等,在这里简单回顾下: Man man = new Man(); 语句创建一个对象,new可以理解成创建一个对象的关键字,通过new关键字为对 ...
- 2.0 python+appium环境搭建
Python下载地址:链接:https://pan.baidu.com/s/1Z3H8tw8AiBVwpxdcABC7XQ 密码:z66t Pycharm下载地址: 链接:https://pan.ba ...
- win10 64位 C# 连接oracle 32位, 遇到的问题及解决
首次 本机电脑是win10系统 64位的:安装的oracle数据库也是64位的: 服务器端的oracle 是32位的: 第一次安装的pl/sql 也是64位的, 配置完 F:\app\ln_qi\p ...
- [g2o]C++图优化库
g2o以图模型表达上述最小二乘问题:比较适合解决SLAM问题 http://openslam.org http://wiki.ros.org/g2o
- 如何将查询到的数据显示在DataGridView中
背景介绍: 数据库中的T_Line_Info表中存放着学生上机的记录,也就是我们需要查询上机记录的表,其中具体内容为: 界面设计如下: 右击DataGridView控件,选择编辑列,设计它的列名. 代 ...
- hdu 1811 Rank of Tetris (拓扑 & 并查集)
Rank of Tetris Time Limit: 1000/1000 MS (Java/Others) Memory Limit: 32768/32768 K (Java/Others)To ...