
吴裕雄 python 机器学习——模型选择参数优化随机搜索寻优RandomizedSearchCV模型
import scipy

from sklearn.datasets import load_digits

from sklearn.metrics import classification_report

from sklearn.linear_model import LogisticRegression

from sklearn.model_selection import train_test_split

from sklearn.model_selection import GridSearchCV,RandomizedSearchCV

#模型选择参数优化随机搜索寻优RandomizedSearchCV模型

def test_RandomizedSearchCV():

    '''

    测试 RandomizedSearchCV 的用法。使用 LogisticRegression 作为分类器,主要优化 C、multi_class 等参数。其中 C 的分布函数为指数分布

    '''

    ### 加载数据

    digits = load_digits()

    X_train,X_test,y_train,y_test=train_test_split(digits.data, digits.target,test_size=0.25,random_state=0,stratify=digits.target)

    #### 参数优化 ######

    tuned_parameters ={  'C': scipy.stats.expon(scale=100), # 指数分布

                        'multi_class': ['ovr','multinomial']}

    clf=RandomizedSearchCV(LogisticRegression(penalty='l2',solver='lbfgs',tol=1e-6),tuned_parameters,cv=10,scoring="accuracy",n_iter=100)

    clf.fit(X_train,y_train)

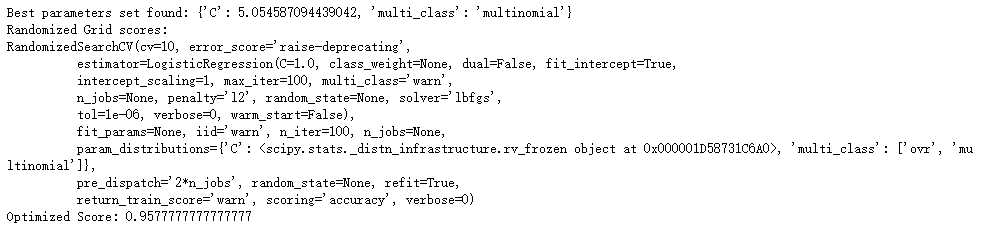
    print("Best parameters set found:",clf.best_params_)

    print("Randomized Grid scores:")

#     for params, mean_score, scores in clf.fit_params,clf.mean_score,clf.score:

#         print("\t%0.3f (+/-%0.03f) for %s" % (mean_score, scores() * 2, params))

#     print("\t%0.3f (+/-%0.03f) for %s" % (clf.mean_score,clf.score * 2, clf.fit_params))

    print(clf)

    print("Optimized Score:",clf.score(X_test,y_test))

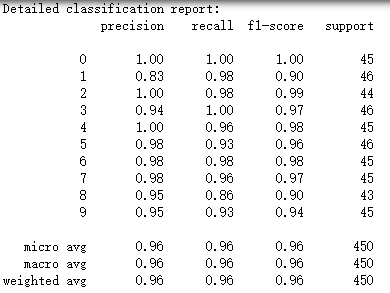
    print("Detailed classification report:")

    y_true, y_pred = y_test, clf.predict(X_test)

    print(classification_report(y_true, y_pred))

#调用RandomizedSearchCV()

test_RandomizedSearchCV()
吴裕雄 python 机器学习——模型选择参数优化随机搜索寻优RandomizedSearchCV模型的更多相关文章
- 吴裕雄 python 机器学习——模型选择参数优化暴力搜索寻优GridSearchCV模型
import scipy from sklearn.datasets import load_digits from sklearn.metrics import classification_rep ...
- 吴裕雄 python 机器学习——模型选择验证曲线validation_curve模型
import numpy as np import matplotlib.pyplot as plt from sklearn.svm import LinearSVC from sklearn.da ...
- 吴裕雄 python 机器学习——模型选择学习曲线learning_curve模型
import numpy as np import matplotlib.pyplot as plt from sklearn.svm import LinearSVC from sklearn.da ...
- 吴裕雄 python 机器学习——模型选择回归问题性能度量
from sklearn.metrics import mean_absolute_error,mean_squared_error #模型选择回归问题性能度量mean_absolute_error模 ...
- 吴裕雄 python 机器学习——模型选择分类问题性能度量
import numpy as np import matplotlib.pyplot as plt from sklearn.svm import SVC from sklearn.datasets ...
- 吴裕雄 python 机器学习——模型选择数据集切分
import numpy as np from sklearn.model_selection import train_test_split,KFold,StratifiedKFold,LeaveO ...
- 吴裕雄 python 机器学习——模型选择损失函数模型
from sklearn.metrics import zero_one_loss,log_loss def test_zero_one_loss(): y_true=[1,1,1,1,1,0,0,0 ...
- 吴裕雄 python 机器学习——分类决策树模型
import numpy as np import matplotlib.pyplot as plt from sklearn import datasets from sklearn.model_s ...
- 吴裕雄 python 机器学习——K均值聚类KMeans模型
import numpy as np import matplotlib.pyplot as plt from sklearn import cluster from sklearn.metrics ...
随机推荐
- java基础之I/O操作
字节流 直接上代码: import java.io.*; class Test{ public static void main(String[] args){ FileInputStream inp ...
- adb logcat日志抓取
adb命令 logcat日志抓取 一.logcat抓log方法:adb logcat命令,可以加条件过滤 1.安装SDK(参考android sdk环境安装) 2.使用数据线链接手机,在手机助手的sd ...
- 215. 数组中的第K个最大元素(TOP-K问题)
问题: 在未排序的数组中找到第 k 个最大的元素.请注意,你需要找的是数组排序后的第 k 个最大的元素,而不是第 k 个不同的元素. 示例 1: 输入: [3,2,1,5,6,4] 和 k = 2输出 ...
- python3爬取百度知道的问答并存入数据库(MySQL)
一.链接分析: 以"Linux"为搜索的关键字为例: 首页的链接为:https://zhidao.baidu.com/search?lm=0&rn=10&pn=0& ...
- 关于memset....我太难了
众所周知memset是个清空数组的好东西 然而...它慢的要死 直接让我从30ms炸到1045ms 于是快乐tle .... 是我的错 所以以后还是手动清空 (我真快乐)
- pycharm连接mysql5.7
由于加密方式改变 需要在url后增加 ?useUnicode=true&characterEncoding=UTF-8&serverTimezone=UTC
- 格式化输出_python
一.直接使用 +a='chen'b='xiao'c='zan'print(a+b+c) 二.利用占位符 %%s:占位符:%d:整数:%x:十六进制:%f:浮点数(默认6位小数)特别注意浮点数: 指定长 ...
- CentOS 7 1810版本不能使用yum 命令
使用yum install httpd 命令安装Apache 提示错误 annot find a valid baseurl for repobase7x86_64 解决方法: 进入 ls命令寻找类似 ...
- 【资源分享】Gmod动态方框透视脚本
*----------------------------------------------[下载区]----------------------------------------------* ...
- SpringBoot 各层之间的关系
SpringBoot 各层之间的关系 SpringBoot 分为四层:controller层.service层.dao层.entity层. entity层:和 model 层一样,存放的是实体类,属 ...