
Requests库网络爬虫实战
实例一:页面的爬取
>>> import requests
>>> r= requests.get("https://item.jd.com/100003717483.html")
>>> r.status_code
200
>>> r.encoding#说明从HTTP的头部分,已经可以解析出这个页面的编码信息,京东网站提供了页面信息的相关编码
'gbk'
>>> r.text[:1000]
'<!DOCTYPE HTML>\n<html lang="zh-CN">\n<head>\n <!-- shouji -->\n <meta http-equiv="Content-Type" content="text/html; charset=gbk" />\n <title>【华为nova 5 Pro】华为 HUAWEI nova 5 Pro 前置3200万人像超级夜景4800万AI四摄麒麟980芯片8GB+128GB绮境森林全网通双4G手机【行情 报价 价格 评测】-京 东</title>\n <meta name="keywords" content="HUAWEInova 5 Pro,华为nova 5 Pro,华为nova 5 Pro报价,HUAWEInova 5 Pro报价"/>\n <meta name="description" content="【华为nova 5 Pro】京东JD.COM提供华为nova 5 Pro正品行货,并包 括HUAWEInova 5 Pro网购指南,以及华为nova 5 Pro图片、nova 5 Pro参数、nova 5 Pro评论、nova 5 Pro心得、nova 5 Pro技巧等信息,网购华为nova 5 Pro上京东, 放心又轻松" />\n <meta name="format-detection" content="telephone=no">\n <meta http-equiv="mobile-agent" content="format=xhtml; url=//item.m.jd.com/product/100003717483.html">\n <meta http-equiv="mobile-agent" content="format=html5; url=//item.m.jd.com/product/100003717483.html">\n <meta http-equiv="X-UA-Compatible" content="IE=Edge">\n <link rel="canonical" href="//item.jd.com/100003717483.html"/>\n <link rel="dns-prefetch" href="//m'
实例二:页面的爬取
通过headers字段让代码模拟浏览器向亚马逊服务器提供HTTP请求
>>> r=requests.get("https://www.amazon.cn/gp/product/B01M8L5Z3Y")
>>> r.status_code
200
>>> r.request.headers#requests库的response对象包含request请求,可以通过r.request.headers查看发给亚马逊的request信息的头部到底是什么内容
{'User-Agent': 'python-requests/2.18.4', 'Accept-Encoding': 'gzip, deflate', 'Accept': '*/*', 'Connection': 'keep-alive'}
'User-Agent': 'python-requests/2.18.4'说明我们的爬虫真实的告诉了亚马逊服务器这次访问是由python的request库的一个程序产生的,如果亚马逊提供了这样的来源审查,就会使这样的访问变得错误或者不支持这样的访问
更改头部信息,模拟浏览器向亚马逊发送请求
kv={'user-agent':'Mozilla/5.0'}#重新定义了user-agent的内容,使他等于Mozilla/5.0;Mozilla/5.0说明这时候的user-agent可能是个浏览器,可能是火狐,可能是Mozilla,可能是IE10的浏览器,Mozilla/5.0是一个很标准的浏览器的身份标识的字段
>>> url='https://www.amazon.cn/gp/product/B01M8L5Z3Y'
>>> r=requests.get(url,headers=kv)
>>> r.status_code
200
>>> r.request.headers
{'user-agent': 'Mozilla/5.0', 'Accept-Encoding': 'gzip, deflate', 'Accept': '*/*', 'Connection': 'keep-alive'}
>>> r.text[:1000]
'\n\n\n\n\n\n\n\n\n\n\n\n\n\n\n \n \n\n\n\n\n\n\n\n \n\n \n\n\n\n\n\n\n\n\n\n\n\n\n\n\n\n\n\n\n\n\n\n\n\n\n\n\n \n\n\n\n\n\n\n\n\n\n\n\n\n\n\n\n\n \n\n\n\n\n\n\n\n\n\n\n\n\n\n\n\n\n \n\n\n\n\n\n\n\n\n\n\n\n\n\n \n\n\n\n\n\n <!doctype html><html class="a-no-js" data-19ax5a9jf="dingo">\n <head>\n<script type="text/javascript">var ue_t0=ue_t0||+new Date();</script>\n<script type="text/javascript">\nwindow.ue_ihb = (window.ue_ihb || window.ueinit || 0) + 1;\nif (window.ue_ihb === 1) {\nvar ue_hob=+new Date();\nvar ue_id=\'WX4VYSQZVENKQC62DC82\',\nue_csm = window,\nue_err_chan = \'jserr-rw\',\nue = {};\n(function(d){var e=d.ue=d.ue||{},f=Date.now||function(){return+new Date};e.d=function(b){return f()-(b?0:d.ue_t0)};e.stub=function(b,a){if(!b[a]){var c=[];b[a]=function(){c.push([c.slice.call(arguments),e.d(),d.ue_id])};b[a].replay=function(b){for(var a;a=c.shift();)b(a[0],a[1],a[2])};b[a].isStub=1}};e.exec=function(b,a){return function(){if(1==window.ueinit)try{return b.apply(this,arguments)}catch(c){ueLogError(c,{attribution:a||"undefined",logLevel:"WARN"})}}}})(ue_csm);\n\nue.stub(ue,"'
实例三:百度搜索关键词提交
>>> kv ={'wd':'python'}
>>> r = requests.get('http://www.baidu.com/s',params = kv)
>>> r.status_code
200
>>> r.request.url #提交的请求到底是什么,可以使用response对象中包含的request对象信息
'http://www.baidu.com/s?wd=python'
>>> len(r.text)
482773
实例四:网络图片的爬取和存储
>>> path = "E:/test_test_test/abc.jpg"#图片保存在本机的什么位置以及叫什么名字,名字后期会做处理
>>> url = "http://testpic.baojia.com/upfiles/pic/companylogo/2019/0509/aYrBoQZbVGp0DFsEq.jpg"
>>> r = requests.get(url)
>>> r.status_code
200
>>> with open(path,'wb') as f:#打开一个文件,文件是要存储的abc.jpg,并且把它定义为一个文件标识符f
... f.write(r.content)#然后把返回的内容写到这个文件中,r.content表示返回内容的二进制形式
...
96803
>>> f.close()
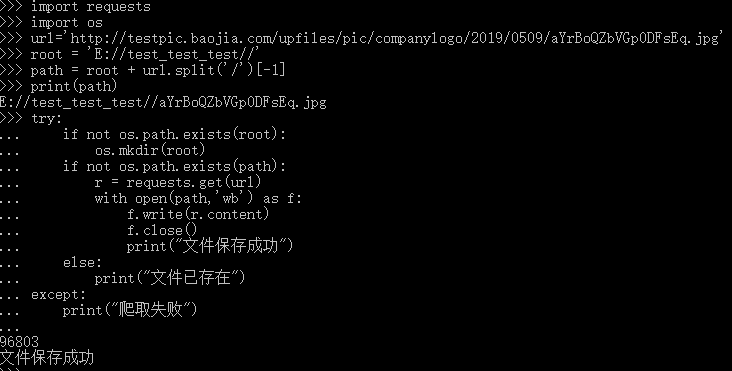
用图片原来的名字存储在本地
图片爬取全代码
>>> import requests
>>> import os
>>> url='http://testpic.baojia.com/upfiles/pic/companylogo/2019/0509/aYrBoQZbVGp0DFsEq.jpg'
>>> root = 'E://test_test_test//'#定义根目录
>>> path = root + url.split('/')[-1]#文件路径,url.split('/')[-1]截取url后面的图片名字
>>> print(path)
E://test_test_test//aYrBoQZbVGp0DFsEq.jpg
>>> try:
... if not os.path.exists(root):#当前根目录是否存在
... os.mkdir(root)#不存在创建
... if not os.path.exists(path):#文件是否存在
... r = requests.get(url)#不存在,通过requests.get方式从网络获取相关文件
... with open(path,'wb') as f:
... f.write(r.content)
... f.close()
... print("文件保存成功")
... else:
... print("文件已存在")
... except:
... print("爬取失败")
...
96803
文件保存成功
实例五:IP地址归属地的自动查询
对于一些网站怎么人工的分析接口并利用接口
>>> url='http://m.ip138.com/ip.asp?ip='
>>> r = requests.get(url+'202.204.80.112')
>>> r.status_code
200
>>> r.text[-500:]
'value="查询" class="form-btn" />\r\n\t\t\t\t\t</form>\r\n\t\t\t\t</div>\r\n\t\t\t\t<div class="query-hd">ip138.com IP查询(搜索IP地址的地理位置)</div>\r\n\t\t\t\t<h1 class="query">您查询的IP:202.204.80.112</h1><p class="result">本站主数据:北京市海淀区 北京理工大学 教育网</p><p class="result">参考数据一:北京市 北京理工大学</p>\r\n\r\n\t\t\t</div>\r\n\t\t</div>\r\n\r\n\t\t<div class="footer">\r\n\t\t\t<a href="http://www.miitbeian.gov.cn/" rel="nofollow" target="_blank">沪ICP备10013467号-1</a>\r\n\t\t</div>\r\n\t</div>\r\n\r\n\t<script type="text/javascript" src="/script/common.js"></script></body>\r\n</html>\r\n'
Requests库网络爬虫实战的更多相关文章
- python网络爬虫实战PDF高清完整版免费下载|百度云盘|Python基础教程免费电子书
点击获取提取码:vg1y python网络爬虫实战帮助读者学习Python并开发出符合自己要求的网络爬虫.网络爬虫,又被称为网页蜘蛛,网络机器人,是一种按照一定的规则,自动地抓取互联网信息的程序或者脚 ...
- 关于Python网络爬虫实战笔记③
Python网络爬虫实战笔记③如何下载韩寒博客文章 Python网络爬虫实战笔记③如何下载韩寒博客文章 target:下载全部的文章 1. 博客列表页面规则 也就是, http://blog.sina ...
- Python简单网络爬虫实战—下载论文名称,作者信息(下)
在Python简单网络爬虫实战—下载论文名称,作者信息(上)中,学会了get到网页内容以及在谷歌浏览器找到了需要提取的内容的数据结构,接下来记录我是如何找到所有author和title的 1.从sou ...
- 关于Python网络爬虫实战笔记①
python网络爬虫项目实战笔记①如何下载韩寒的博客文章 python网络爬虫项目实战笔记①如何下载韩寒的博客文章 1. 打开韩寒博客列表页面 http://blog.sina.com.cn/s/ar ...
- requests库(爬虫)
北京理工大学嵩天老师的课程:http://www.icourse163.org/course/BIT-1001870001 官方文档:http://docs.python-requests.org/e ...
- 自己动手,丰衣足食!Python3网络爬虫实战案例
本教程是崔大大的爬虫实战教程的笔记:网易云课堂 Python3+Pip环境配置 Windows下安装Python: http://www.cnblogs.com/0bug/p/8228378.html ...
- Python爬虫:HTTP协议、Requests库(爬虫学习第一天)
HTTP协议: HTTP(Hypertext Transfer Protocol):即超文本传输协议.URL是通过HTTP协议存取资源的Internet路径,一个URL对应一个数据资源. HTTP协议 ...
- Python网络爬虫实战(一)快速入门
本系列从零开始阐述如何编写Python网络爬虫,以及网络爬虫中容易遇到的问题,比如具有反爬,加密的网站,还有爬虫拿不到数据,以及登录验证等问题,会伴随大量网站的爬虫实战来进行. 我们编写网络爬虫最主要 ...
- python网络爬虫实战之快速入门
本系列从零开始阐述如何编写Python网络爬虫,以及网络爬虫中容易遇到的问题,比如具有反爬,加密的网站,还有爬虫拿不到数据,以及登录验证等问题,会伴随大量网站的爬虫实战来进行. 我们编写网络爬虫最主要 ...
随机推荐
- Python自定义任务发邮件提醒
前言 在工作中,有时会有一些定期需要执行的任务或在将来某一天需要执行的任务,为避免疏漏,设计个小工具,发邮件提醒自己去处理. 方案简介 1.建立一个Excel文件,里面定义好待提醒的任务 2.建立一个 ...
- [JSOI2016]最佳团体 DFS序/树形DP
题目 洛谷 P4322 [JSOI2016]最佳团体 Description 茜茜的舞蹈团队一共有\(N\)名候选人,这些候选人从\(1\)到\(N\)编号.方便起见,茜茜的编号是\(0\)号.每个候 ...
- OrCAD 16.6 自建仿真模型
今天仿真用到一个三极管,NXP的MMBT2222A,OdCAD自带的库里没找到,于是打算学着自己建立一个仿真模型 http://www.nxp.com/documents/spice_model/MM ...
- jmeter 登陆--查询存在否-->新建客户-->查询存在否 + 压测
1.登陆 正则表达式提取器和json提取器,都是后置处理器提取token(都可以在响应中以regexp tester 和 json path tester查看提取的对不对) beanshell 后置处 ...
- js基础 之 引用类型
引用类型的值(对象)是引用类型的一个实例.引用类型是一种数据结构,用于将数据和功能组织在一起 对象是某个特定引用类型的实例.新对象是使用new操作符后跟一个构造函数来创建的.构造函数本身就是一个函数, ...
- hyper-v 80070057
微软官网搜索MediaCreation tool进行升级.
- C++-HDU1000,1001,1002-格式是真的坑
#include <cstdio> int main(){ for(int a,b;~scanf("%d%d",&a,&b);printf(" ...
- AtCoder Beginner Contest 144
https://atcoder.jp/contests/abc144/tasks/abc144_c #include<bits/stdc++.h> using namespace std; ...
- 修正_typora文档复制到博客图片失效
开始 今天开始尝试使用 Typora 写markdown 然后复制到博客园,不过会有一个问题 那就是 typroa 插入的图片都是本地的,md文档复制到博客园之后,图片都失效了 通过百度,有工具可以直 ...
- Go_MySQL查询插入删除
什么是预处理? 普通SQL语句执行过程: 客户端对SQL语句进行占位符替换得到完整的SQL语句. 客户端发送完整SQL语句到MySQL服务端 MySQL服务端执行完整的SQL语句并将结果返回给客户端. ...