
Spark源码剖析 - SparkContext的初始化(九)_启动测量系统MetricsSystem
9. 启动测量系统MetricsSystem
MetricsSystem使用codahale提供的第三方测量仓库Metrics。MetricsSystem中有三个概念:
- Instance:指定了谁在使用测量系统;
- Source:指定了从哪里收集测量数据;
- Sink:指定了从哪里输出测量数据;
Spark按照Instance的不同,区分为Master、Worker、Application、Driver和Executor。
Spark目前提供的Sink有ConsoleSink、CsvSink、JmxSink、MetricsServlet、GraphiteSink等。
Spark中使用MetricsServlet作为默认的Sink。
MetricsSystem在SparkEnv执行环境创建的过程中创建,代码如下:

MetricsSystem的启动代码如下:
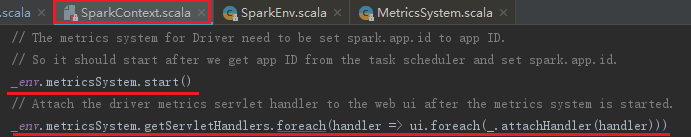

MetricsSystem的启动过程包括以下步骤:
1) 注册Sources;
2) 注册Sinks;
3) 给Sinks增加Jetty的ServletContextHandler。
MetricsSystem启动完毕后,会遍历与Sinks有关的ServletContextHandler,并调用attachHandler将它们绑定到Spark UI上。代码如上图
9.1 注册Sources
registerSources方法用于注册Sources,告诉测量系统从哪里收集测量数据。注册Sources的过程分为以下步骤:
1) 从metricsConfig获取Driver的Properties,默认为创建MetricsSystem的过程中解析的{sink.servlet.class=org.apache.spark.metrics.sink.MetricsServlet,sink.servlet.path=/metrics/json}。
2) 用正则匹配Driver的Properties中以source.开头的属性。然后将属性中的Source发射得到的实例加入ArrayBuffer[Source]。
3) 将每个source的metricRegistry(也是MetricSet的子类型)注册到ConcurrentMap<String, Metric>metrics。

9.2 注册Sinks
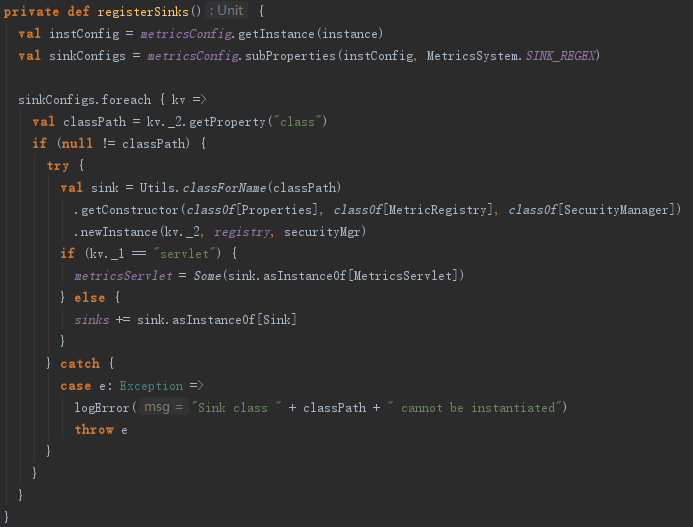
registerSinks方法用于注册Sinks,即告诉测量系统MetricsSystem往哪里输出测量数据。注册Sinks的步骤如下:
1) 从Driver的Properties中用正则匹配以sink.开头的属性,如{sink.servlet.class=org.apache.spark.metrics.sink.MetricsServlet,sink.servlet.path=/metrics/json},将其转换为Map(servlet->{class=org.apache.spark.metrics.sink.MetricsServlet,path=/metrics/json})。
2) 将子属性class对应的类metricsServlet发射得到MetricsServlet实例。如果属性的key是serlvet,将其设置为metricsServlet;如果是Sink,则加入到ArrayBuffer[Sink]中。
9.3 给Sinks增加Jetty的ServletContextHandler
为了能够在SparkUI(网页)访问到测量数据,所以需要给Sinks增加Jetty的ServletContextHandler,这里主要用到MetricsSystem的getServletHandlers方法实现如下:

可以看到调用了metricsServlet的getHandlers,其实现如下:

最终生成处理/metrics/json请求的ServletContextHandler,而请求的真正处理由getMetricsSnapshot方法,利用fastjson解析。生成的ServletContextHandler通过SparkUI。最终我们可以使用以下这些地址来访问测量数据。
http://localhost:4040/metrics/applications/json

http://localhost:4040/metrics/json

http://localhost:4040/metrics/master/json
Spark源码剖析 - SparkContext的初始化(九)_启动测量系统MetricsSystem的更多相关文章
- Spark源码剖析 - SparkContext的初始化(二)_创建执行环境SparkEnv
2. 创建执行环境SparkEnv SparkEnv是Spark的执行环境对象,其中包括众多与Executor执行相关的对象.由于在local模式下Driver会创建Executor,local-cl ...
- Spark源码剖析 - SparkContext的初始化(三)_创建并初始化Spark UI
3. 创建并初始化Spark UI 任何系统都需要提供监控功能,用浏览器能访问具有样式及布局并提供丰富监控数据的页面无疑是一种简单.高效的方式.SparkUI就是这样的服务. 在大型分布式系统中,采用 ...
- Spark源码剖析 - SparkContext的初始化(五)_创建任务调度器TaskScheduler
5. 创建任务调度器TaskScheduler TaskScheduler也是SparkContext的重要组成部分,负责任务的提交,并且请求集群管理器对任务调度.TaskScheduler也可以看作 ...
- Spark源码剖析 - SparkContext的初始化(八)_初始化管理器BlockManager
8.初始化管理器BlockManager 无论是Spark的初始化阶段还是任务提交.执行阶段,始终离不开存储体系.Spark为了避免Hadoop读写磁盘的I/O操作成为性能瓶颈,优先将配置信息.计算结 ...
- Spark源码剖析 - SparkContext的初始化(六)_创建和启动DAGScheduler
6.创建和启动DAGScheduler DAGScheduler主要用于在任务正式交给TaskSchedulerImpl提交之前做一些准备工作,包括:创建Job,将DAG中的RDD划分到不同的Stag ...
- Spark源码剖析 - SparkContext的初始化(一)
1. SparkContext概述 注意:SparkContext的初始化剖析是基于Spark2.1.0版本的 Spark Driver用于提交用户应用程序,实际可以看作Spark的客户端.了解Spa ...
- Spark源码剖析 - SparkContext的初始化(十)_Spark环境更新
12. Spark环境更新 在SparkContext的初始化过程中,可能对其环境造成影响,所以需要更新环境,代码如下: SparkContext初始化过程中,如果设置了spark.jars属性,sp ...
- Spark源码剖析 - SparkContext的初始化(七)_TaskScheduler的启动
7. TaskScheduler的启动 第五节介绍了TaskScheduler的创建,要想TaskScheduler发挥作用,必须要启动它,代码: TaskScheduler在启动的时候,实际调用了b ...
- Spark源码剖析 - SparkContext的初始化(四)_Hadoop相关配置及Executor环境变量
4. Hadoop相关配置及Executor环境变量的设置 4.1 Hadoop相关配置信息 默认情况下,Spark使用HDFS作为分布式文件系统,所以需要获取Hadoop相关配置信息的代码如下: 获 ...
随机推荐
- FLAG区
以下是一些flag(倒了我也不会怎么样): 更博客(对不起 您呼叫的flag是空号 请稍后再拨) CTS/APIO2019 Cu+ NOI2019 Ag+
- 用c#查询各快递物流信息
前面介绍过<用快递100接口查询各快递物流信息>,里面用的是API接口,但有些快递不支持这种方式,本文介绍的HtmlAPI支持所有快递公司. 支持包括EMS.邮政.顺丰和申通在内的所有公司 ...
- ES6中箭头函数与普通函数this的区别
普通函数中的this: 1. this总是代表它的直接调用者, 例如 obj.func ,那么func中的this就是obj 2.在默认情况(非严格模式下,未使用 'use strict'),没找到直 ...
- 诶西,JavaScript学习记录。。。。。。
由于大学课程缘故,老师巨爱叫人问问题,还记分呢,随便记录一下Js的学习情况,以后复习什么的也比较方便吧...... 开始咯,就按照C语言学习那样的方法来吧! ===================== ...
- 不裸缩点》。。。POJ2186受欢迎的牛
不裸缩点>...POJ2186受欢迎的牛 :first-child { margin-top: 0; } blockquote > :last-child { margin-bottom: ...
- centos7搭建ELK Cluster集群日志分析平台(一):Elasticsearch
应用场景: ELK实际上是三个工具的集合,ElasticSearch + Logstash + Kibana,这三个工具组合形成了一套实用.易用的监控架构, 很多公司利用它来搭建可视化的海量日志分析平 ...
- htmlunit 导致高cup占用,一老内存溢出的解决办法
原文:http://blog.csdn.net/qq_28384353/article/details/52974432#reply 将爬虫部署到服务器上运行后,在查看服务器的状态监控时发现,天猫爬虫 ...
- Why I don't want use JPA anymore
转自:https://dev.to/alagrede/why-i-dont-want-use-jpa-anymore-fl Great words for what is considered by ...
- hibernate 5的二级缓存案例讲解
hibernate 5的二级缓存案例讲解 本帖最后由 鱼丸儿 于 2018-1-20 11:44 编辑 大家好,今天来记录讲解一下磕磕绊绊的hibernate5 的二级缓存配置,一条路摸到黑 那么在这 ...
- java 数组转字符串 字符串转数组
字符串转数组 使用Java split() 方法 split() 方法根据匹配给定的正则表达式来拆分字符串. 注意: . . | 和 * 等转义字符,必须得加 \\.多个分隔符,可以用 | 作为连字符 ...