
Python实例---爬取下载喜马拉雅音频文件
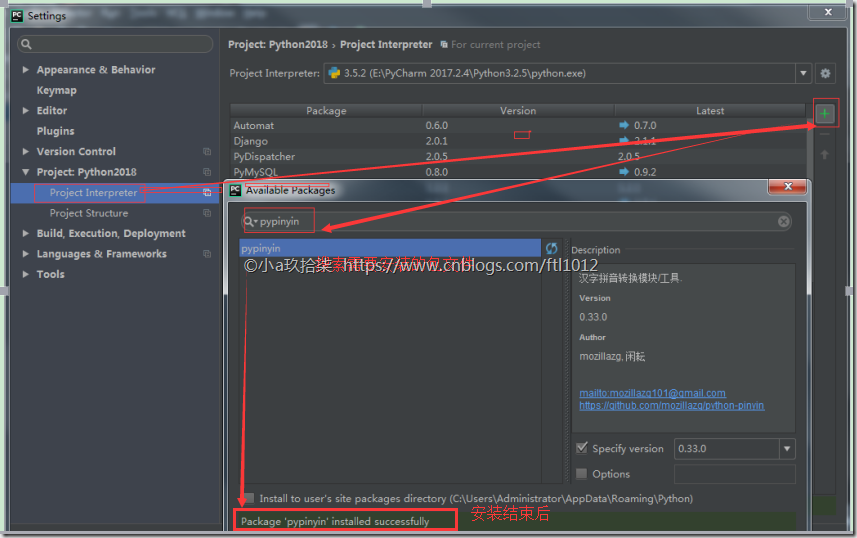
PyCharm下python爬虫准备
打开pycharm
点击设置
点击项目解释器,再点击右边+号
搜索相关库并添加,例如:requests
喜马拉雅全网递归下载
打开谷歌/火狐浏览器,按F12打开开发者工具—>选择【网络】
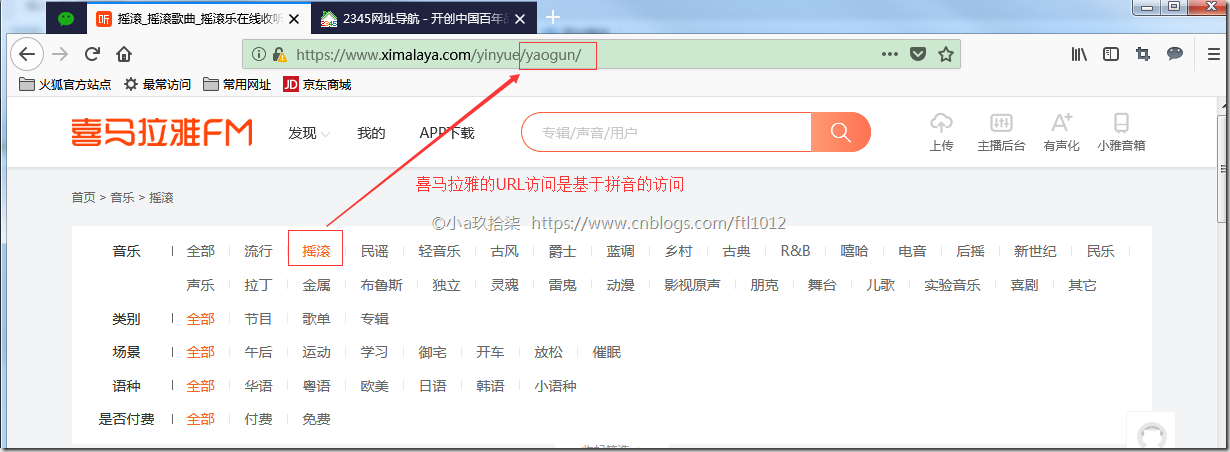
编辑器浏览器输入: https://www.ximalaya.com/yinyue/ 点击【摇滚】
发现弹出新的URL:https://www.ximalaya.com/yinyue/yaogun/ [汉字转换拼音后的URL访问]
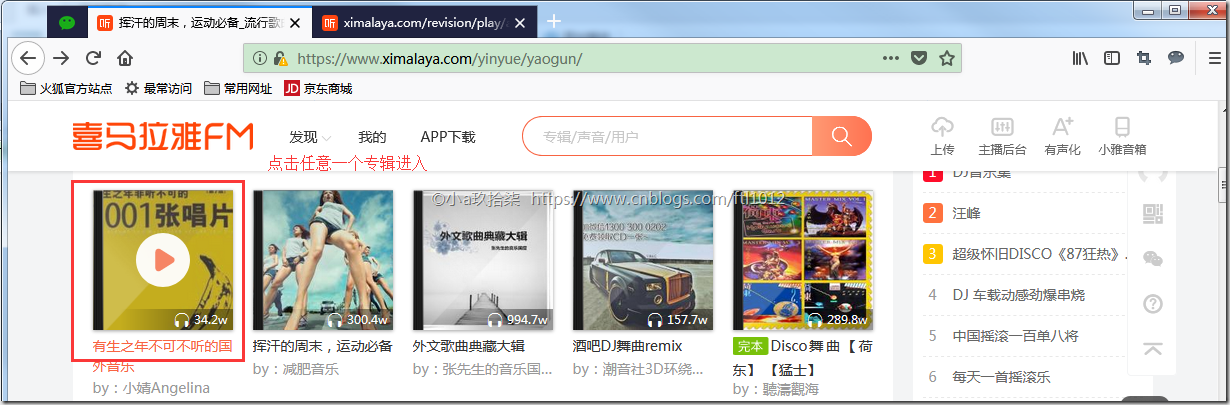
点击进入任意一个专辑[未播放]
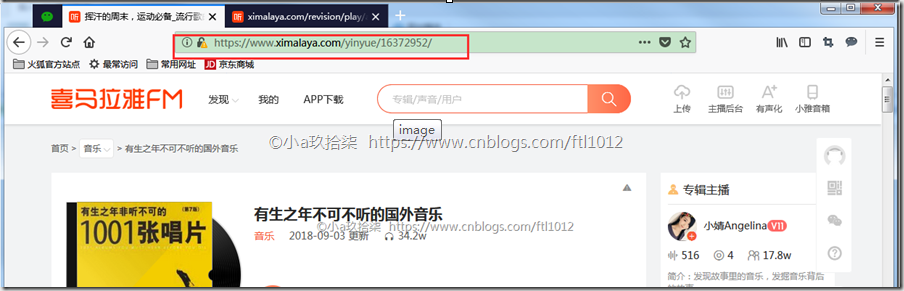
点击播放音乐[播放中]
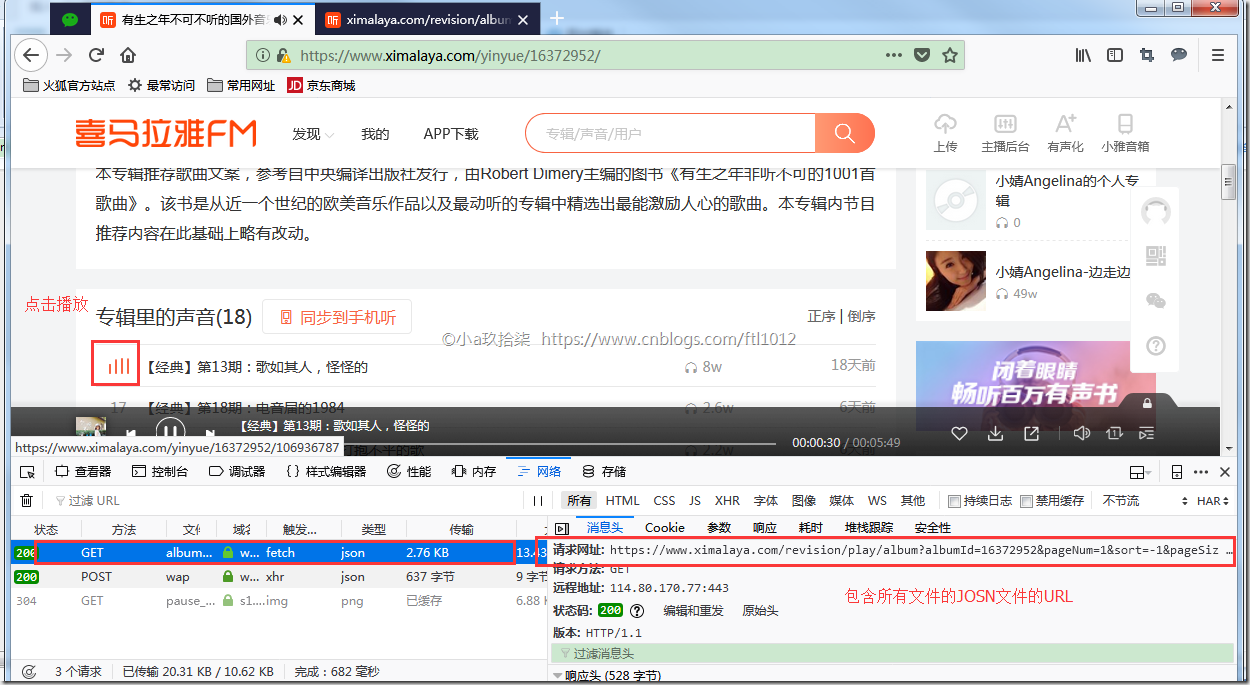
[是一个json格式的URL]访问搜索界面的源代码,查找albumId,通过这些albumid获取音频文件的url
https://www.ximalaya.com/revision/play/album?albumId=16372952&pageNum=1&sort=-1&pageSize=30

最后使用函数urllib.request.urlretrieve()下载音乐即可
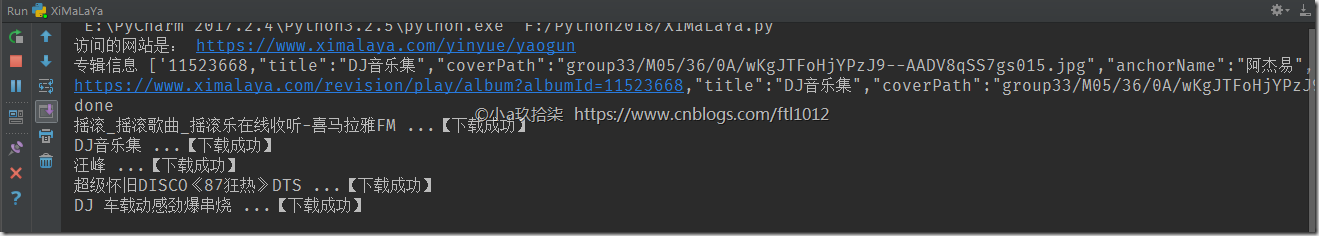
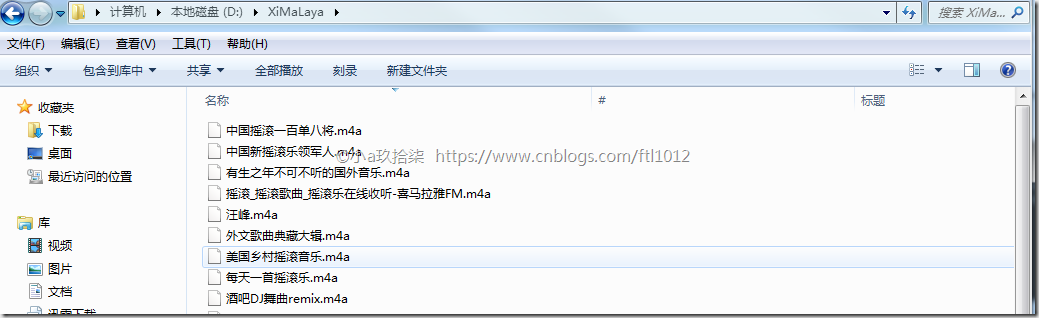
附源码:
import re

import os

import json

import requests

import urllib

from urllib import request

from pypinyin import lazy_pinyin

class XimaLaya(object):

    # 模拟浏览器操作

    def __init__(self):

        self.header = {

            "User-Agent": 'Mozilla/5.0 (Windows NT 10.0; Win64; x64; rv:60.0) Gecko/20100101 Firefox/60.0'

        }

    # 第一步: 根据输入的汉字转换为拼音

    def han_pinyin(self, hanzi):

        pin = lazy_pinyin(hanzi)   # 汉转拼音

        pin = "".join(pin)       # 去除空格

        return pin               # 返回拼音

    # 第二步: 根据REST格式去访问喜马拉雅,获取页面的HTML

    def getHtml(self, pinyin):

        url = 'https://www.ximalaya.com/yinyue/' + pinyin

        print("访问的网站是: " + url)

        html = requests.get(url, headers=self.header)

        # apparent_encoding通过调用chardet.detect()来识别文本编码,有些消耗计算资源

        html.encoding = html.apparent_encoding

        # html.encoding = 'utf8'  --> 直接改为UTF8也行

        with open('D:\XiMaLaya\html\\' + str(pinyin + '.html'), 'a', encoding='utf-8') as f:

            f.write(html.text)

        return html

    # 第三步:根据页面的内容获取对应歌单的albumId的值

    def getAlbumId(self, html):

        albumIdAll = re.findall(r'"albumId":(.*)', (html).text)  # 利用正则进行匹配,获取专辑ID

        print("专辑信息", albumIdAll)

        with open('D:\XiMaLaya\\albumIdAll\\' + str('albumIdAll.txt'), 'a', encoding='utf-8') as f:

            for x in albumIdAll:

                f.write(str(x))

        myList = []

        url3 = []

        for i in (albumIdAll[:1]):

            # 获取对应专辑ID的首页

            url2 = 'https://www.ximalaya.com/revision/play/album?albumId=' + i

            print(url2)

            # 进入对应专辑ID的首页信息

            html2 = requests.get(url2.split(',')[0], headers=self.header)

            # 含有下载URL的集合

            # src   "http://audio.xmcdn.com/group12/M03/2C/AA/wKgDW1WJ7GqxuItqAB8e1LXvuds895.m4a"

            url3 = (re.findall(r'"src":"(.*?)"', (html2).text))

            # 记录信息用的

            myList.append('获取对应专辑ID的首页\r\n' + url2 + '\n---------------------------------------')

            myList.append('含有下载URL的集合\r\n' + html2.text + '\n---------------------------------------')

            myList.append('下载专辑的URL集合\r\n' + str(url3) + '\n---------------------------------------')

            with open('D:\XiMaLaya\\albumIdAll\\' + str('hhh.txt'), 'a', encoding='utf-8') as f:

                f.write(json.dumps(myList))

        print('done')

        return url3    # 下载专辑的URL集合

    # 第四步: 获取专辑名

    def getTitle(self, html):

        t = re.findall(r'"title":"(.*?)"', (html).text)  # 获取titile(歌名)的值

        with open('D:\XiMaLaya\\albumIdAll\\' + str('albumId_Name.txt'), 'a', encoding='utf-8') as f:

            f.write(str(t))

        return t

    # 第五步: 下载歌曲

    def downLoad(self, url, title):

        n = 0

        for i in url:

            try:

                urllib.request.urlretrieve(i, 'D:\XiMaLaya\\'+str(title[n]+'.m4a'))

                print(str(title[n]), '...【下载成功】')

                n = n + 1

            except:

                print(str(title[n]) + "...【下载失败】")

if __name__ == '__main__':

    fm = XimaLaya()

    # 输入需要下载的歌曲类型

    str1 = fm.han_pinyin("摇滚")

    # 获取对应歌曲类型的首页信息

    html = fm.getHtml(str1)

    # 获取歌曲类型的首页里面的专辑名称

    title = fm.getTitle(html)

    # 获取歌曲类型的首页里面的专辑ID

    url3 = fm.getAlbumId(html)

    # 下载对应曲目

    fm.downLoad(url3, title)
喜马拉雅单一专辑的下载
打开谷歌/火狐浏览器,按F12打开开发者工具—>选择【网络】
编辑器浏览器输入: https://www.ximalaya.com/yinyue/12521114/
点击计入音乐[未播放前]
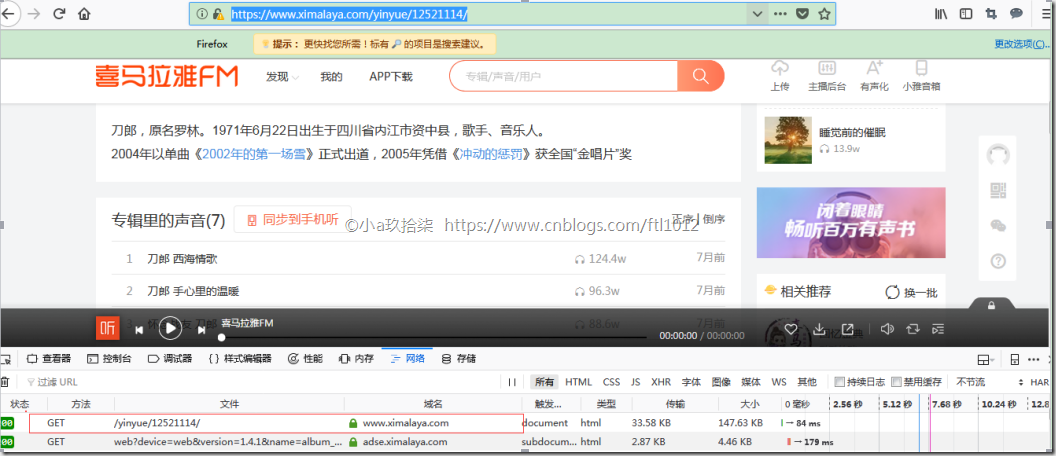
点击进入音乐[播放中]
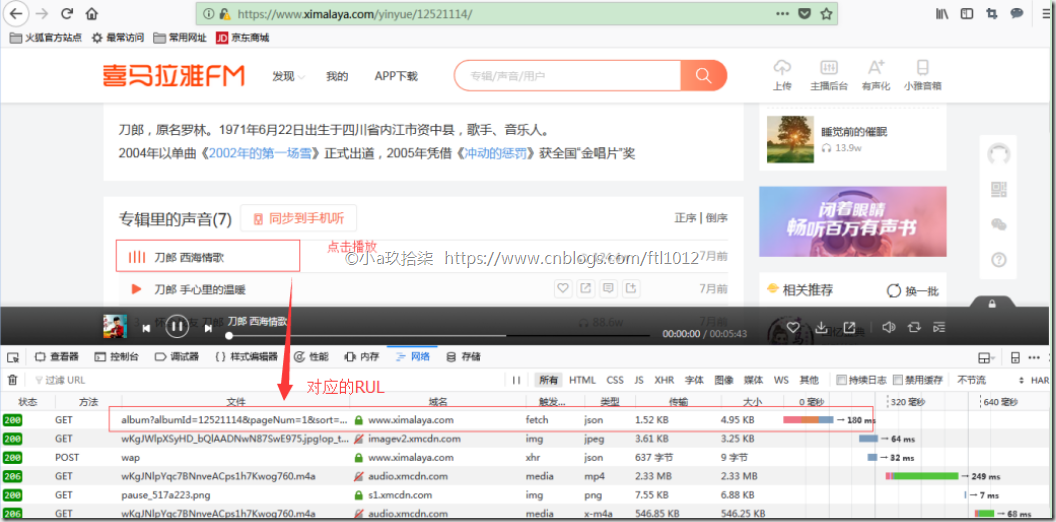
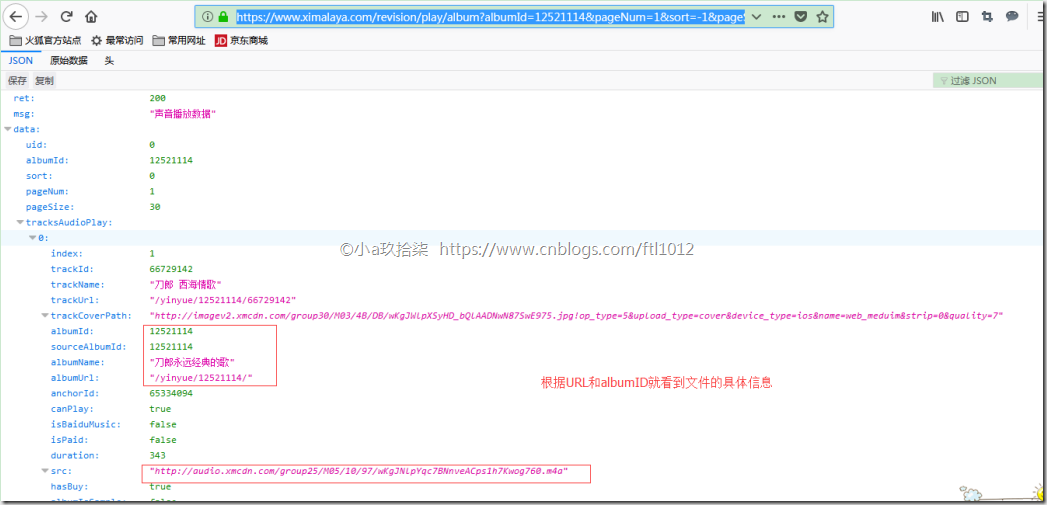
[是一个json格式的URL]访问搜索界面的源代码,查找albumId,通过这些albumid获取音频文件的url
https://www.ximalaya.com/revision/play/album?albumId=12521114&pageNum=1&sort=-1&pageSize=30
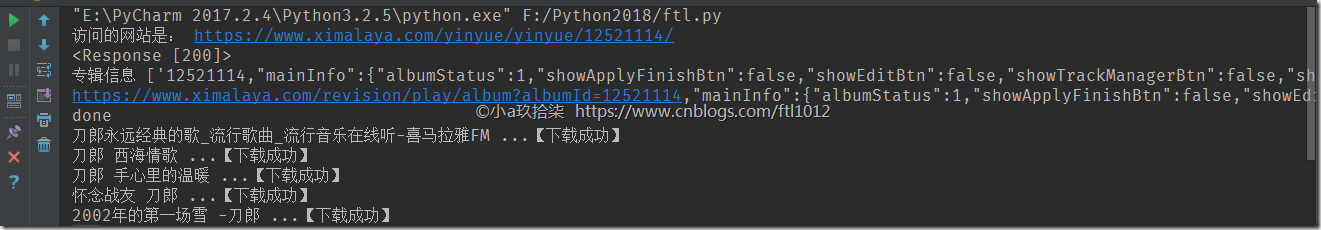
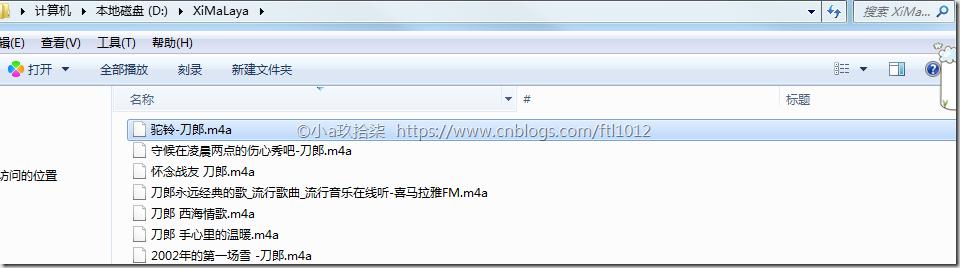
最后使用函数urllib.request.urlretrieve()下载音乐即可
附源码:
import re

import json

import requests

import urllib

from urllib import request

class XimaLaya(object):

    # 模拟浏览器操作

    def __init__(self):

        self.header = {

            "User-Agent": 'Mozilla/5.0 (Windows NT 10.0; Win64; x64; rv:60.0) Gecko/20100101 Firefox/60.0'

        }

    # 第一步:根据REST格式去访问喜马拉雅,获取页面的HTML

    def getHtml(self, pinyin):

        url = 'https://www.ximalaya.com/yinyue/' + pinyin

        print("访问的网站是: " + url)

        html = requests.get(url, headers=self.header)

        # apparent_encoding通过调用chardet.detect()来识别文本编码,有些消耗计算资源

        html.encoding = html.apparent_encoding

        # html.encoding = 'utf8'  --> 直接改为UTF8也行

        print(html)

        return html

    # 第二步:根据页面的内容获取对应歌单的albumId的值

    def getAlbumId(self, html):

        albumIdAll = re.findall(r'"albumId":(.*)', (html).text)  # 利用正则进行匹配,获取专辑ID

        print("专辑信息", albumIdAll)

        with open('D:\XiMaLaya\\albumIdAll\\' + str('albumIdAll.txt'), 'a', encoding='utf-8') as f:

            for x in albumIdAll:

                f.write(str(x))

        myList = []

        url3 = []

        for i in (albumIdAll[:1]):

            # 获取对应专辑ID的首页

            url2 = 'https://www.ximalaya.com/revision/play/album?albumId=' + i

            print(url2)

            # 进入对应专辑ID的首页信息

            html2 = requests.get(url2.split(',')[0], headers=self.header)

            # 含有下载URL的集合

            # src   "http://audio.xmcdn.com/group12/M03/2C/AA/wKgDW1WJ7GqxuItqAB8e1LXvuds895.m4a"

            url3 = (re.findall(r'"src":"(.*?)"', (html2).text))

            # 记录信息用的

            myList.append('获取对应专辑ID的首页\r\n' + url2 + '\n---------------------------------------')

            myList.append('含有下载URL的集合\r\n' + html2.text + '\n---------------------------------------')

            myList.append('下载专辑的URL集合\r\n' + str(url3) + '\n---------------------------------------')

            with open('D:\XiMaLaya\\albumIdAll\\' + str('hhh.txt'), 'a', encoding='utf-8') as f:

                f.write(json.dumps(myList))

        print('done')

        return url3    # 下载专辑的URL集合

    # 第三步: 获取专辑名

    def getTitle(self, html):

        t = re.findall(r'"title":"(.*?)"', (html).text)  # 获取titile(歌名)的值

        with open('D:\XiMaLaya\\albumIdAll\\' + str('albumId_Name.txt'), 'a', encoding='utf-8') as f:

            f.write(str(t))

        return t

    # 第四步: 下载歌曲

    def downLoad(self, url, title):

        n = 0

        for i in url:

            try:

                urllib.request.urlretrieve(i, 'D:\XiMaLaya\\'+str(title[n]+'.m4a'))

                print(str(title[n]), '...【下载成功】')

                n = n + 1

            except:

                print(str(title[n]) + "...【下载失败】")

if __name__ == '__main__':

    fm = XimaLaya()

    # 输入需要下载的歌曲URL

    str1 = "yinyue/12521114/"

    # 获取对应歌曲类型的首页信息

    html = fm.getHtml(str1)

    # 获取歌曲类型的首页里面的专辑名称

    title = fm.getTitle(html)

    # 获取歌曲类型的首页里面的专辑ID

    url3 = fm.getAlbumId(html)

    # 下载对应曲目

    fm.downLoad(url3, title)
Python实例---爬取下载喜马拉雅音频文件的更多相关文章
- Python疫情爬取输出到txt文件
在网上搬了一个代码,现在不适用了,改了改 import requestsimport jsondef Down_data(): url = 'https://view.inews.qq.com/g2/ ...
- Python爬虫|爬取喜马拉雅音频
"GOOD Python爬虫|爬取喜马拉雅音频 喜马拉雅是知名的专业的音频分享平台,用户规模突破4.8亿,汇集了有声小说,有声读物,儿童睡前故事,相声小品等数亿条音频,成为国内发展最快.规模 ...
- Python Scrapy 爬取煎蛋网妹子图实例(一)
前面介绍了爬虫框架的一个实例,那个比较简单,这里在介绍一个实例 爬取 煎蛋网 妹子图,遗憾的是 上周煎蛋网还有妹子图了,但是这周妹子图变成了 随手拍, 不过没关系,我们爬图的目的是为了加强实战应用,管 ...
- python连续爬取多个网页的图片分别保存到不同的文件夹
python连续爬取多个网页的图片分别保存到不同的文件夹 作者:vpoet mail:vpoet_sir@163.com #coding:utf-8 import urllib import ur ...
- Python爬虫 - 爬取百度html代码前200行
Python爬虫 - 爬取百度html代码前200行 - 改进版, 增加了对字符串的.strip()处理 源代码如下: # 改进版, 增加了 .strip()方法的使用 # coding=utf-8 ...
- Python+Selenium爬取动态加载页面(1)
注: 最近有一小任务,需要收集水质和水雨信息,找了两个网站:国家地表水水质自动监测实时数据发布系统和全国水雨情网.由于这两个网站的数据都是动态加载出来的,所以我用了Selenium来完成我的数据获取. ...
- 使用Python爬虫爬取网络美女图片
代码地址如下:http://www.demodashi.com/demo/13500.html 准备工作 安装python3.6 略 安装requests库(用于请求静态页面) pip install ...
- Python爬虫爬取全书网小说,程序源码+程序详细分析
Python爬虫爬取全书网小说教程 第一步:打开谷歌浏览器,搜索全书网,然后再点击你想下载的小说,进入图一页面后点击F12选择Network,如果没有内容按F5刷新一下 点击Network之后出现如下 ...
- Scrapy教程——搭建环境、创建项目、爬取内容、保存文件
1.创建项目 在开始爬取之前,您必须创建一个新的Scrapy项目.进入您打算存储代码的目录中,运行新建命令. 例如,我需要在D:\00Coding\Python\scrapy目录下存放该项目,打开命令 ...
随机推荐
- Nhibernate + MySQL 类型映射
用SQLyog工具创建表 然后用自动映射工具NHibernate Mapping Generator对表做自动映射,得到 这个是可视化界面,后面有对应的代码. using System; using ...
- Java 容器源码分析之1.8HashMap方法讲解
前言:Java8之后新增挺多新东西,在网上找了些相关资料,关于HashMap在自己被血虐之后痛定思痛决定整理一下相关知识方便自己看.图和有些内容参考的这个文章:http://www.importnew ...
- Spring事务内方法调用自身事务 增强的三种方式
ServiceA.java文件: 查看Spring Tx的相关日志: 可以看到只创建了一个事物ServiceA.service方法的事务,但是callSelf方法却没有被事务增强; 分析原因:Spr ...
- React 基础实例教程
园子都荒废两个月了,实在是懒呀.. 近段时间用React开发了几个页面,在使用过程中着实碰到了一些问题,估计刚开始学习的伙伴们都会遇到各种各样的坑 总结记录一下,只看文档是碰不上问题的,内容基础也不基 ...
- laravel 数据模型方法
laravel 数据模型方法 作用:提供了数据库操作的方法 <?php namespace App; use Illuminate\Database\Eloquent\Model; class ...
- Docker基础-端口映射与容器互联
1.端口映射实现访问容器 1.从外部访问容器应用 在启动容器的时候,如果不指定对应的参数,在容器外部是无法通过网络来访问容器内部的网络应用和服务的. 当容器中运行一些网络应用,要让外部访问这些应用时, ...
- 自动加载的iframe高度自适应
动态产生iframe,自动加载至body中,还有一个功能就是iframe的高度自适应,下面代码测试于IE和Firefox,Chrome:
- 虚方法virtual详解(转载)
从C#的程序编译的角度来看,它和其它一般的函数有什么区别呢?一般函数在编译时就静态地编译到了执行文件中,其相对地址在程序运行期间是不发生变化的,也就是写死了的!而虚函数在编译期间是不被静态编译的,它的 ...
- CSS 分类 选择器
CSS:层叠样式表(英文全称:Cascading Style Sheets) 后缀名:css 标志 style 对网页中元素位置的排版进行像素级精 ...
- css span宽度和css span高度成功设置经验篇
我们介绍两种情况下的对span宽度高度样式成功设置. 为了观察和实践CSS SPAN宽度和span高度成功设置,DIVCSS5新建一个css命名为“.divcss5”的盒子,设置css宽度为150px ...