
Scrapy爬虫框架补充内容一(Linux环境)
Scrapy爬虫框架结构及工作原理详解
scrapy框架的框架结构如下:
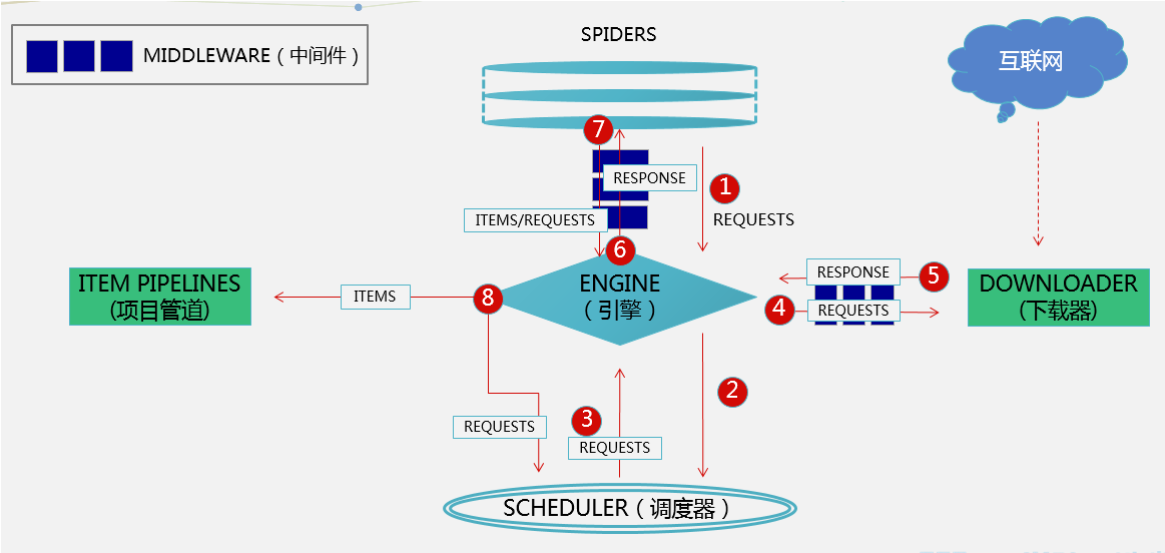
组件分析:
ENGINE:(核心):处理整个框架的数据流,各个组件在其控制下协同工作
SCHEDULER(调度器):负责接收引擎发送来的请求,并压入队列,在引擎再次请求时返回
SPIDER(蜘蛛):负责从网页中提取指定的信息,即item并产生对新页面的下载请求
DOWNLOADER(下载器):用于下载网页内容(即发送HTTP请求/接受HTTP请求)并将内容返回给ENGINE
ITEM PIPELINES(项目管道):主要对爬取到的数据进行处理(去重、过滤、清洗),最终保存数据
DOWNLOADER MIDDLEWARES(下载中间件):位于ENGINE和DOWNLOADER中间,处理请求和响应(该组件是反反爬虫的重点)
SPIDER MIDDLEWARES(爬虫中间件):位于SPIDER和ENGINE中间,处理蜘蛛的请求和响应
数据流对象分析:(主要有三)
(1)REQUEST:scrapy中的hettp请求对象
(2)RESPONSE:scrapy中的http响应对象
(3)ITEM:页面爬取到的数据
工作原理:
(1)、Spiders发送第一个URL给引擎
(2)、引擎从Spider中获取到第一个要爬取的URL后,在调度器(Scheduler)以Request调度
(3)、调度器把需要爬取的request返回给引擎
(4)、引擎将request通过下载中间件发给下载器(Downloader)去互联网下载数据
(5)、一旦数据下载完毕,下载器获取由互联网服务器发回来的Response,并将其通过下载中间件发送给引擎
(6)、引擎从下载器中接收到Response并通过Spider中间件发送给Spider处理
(7)、Spider处理Response并从中返回匹配到的Item及(跟进的)新的Request给引擎
(8)、引擎将(Spider返回的)爬取到的Item给Item Pipeline做数据处理或者入库保存,将(Spider返回的)Request给调度器入队列
(9)、重复第(3)步循环运行直至SCHCULAR中没有REQUEST为止
总结:这章我们学习了整个scrapy框架的结构及工作原理,小伙伴们清楚了吗?(刚全宿舍去看了复联3,突然发现灭霸并没有那么坏!雷神真tm叼!)

Scrapy爬虫框架补充内容一(Linux环境)的更多相关文章
- Scrapy爬虫框架第三讲(linux环境)
下面我们来学习下Spider的具体使用: 我们已上节的百度阅读爬虫为例来进行分析: 1 # -*- coding: utf-8 -*- 2 import scrapy 3 from scrapy.li ...
- Scrapy爬虫框架第五讲(linux环境)【download middleware用法】
DOWNLOAD MIDDLEWRE用法详解 通过上面的Scrapy工作架构我们对其功能进行下总结: (1).在Scheduler调度出队列时的Request送给downloader下载前对其进行修改 ...
- Scrapy爬虫框架第四讲(Linux环境)
下面我们来学习Selector的具体使用:(参考文档:http://scrapy-chs.readthedocs.io/zh_CN/1.0/topics/selectors.html) Selecto ...
- Scrapy爬虫框架补充内容三(代理及其基本原理介绍)
前言:(本文参考维基百科及百度百科所写) 当我们使用爬虫抓取数据时,有时会产生错误比如:突然跳出来了403 Forbidden 或者网页上出现以下提示:您的ip访问频率太高 或者时不时跳出一个验证码需 ...
- Python之Scrapy爬虫框架安装及简单使用
题记:早已听闻python爬虫框架的大名.近些天学习了下其中的Scrapy爬虫框架,将自己理解的跟大家分享.有表述不当之处,望大神们斧正. 一.初窥Scrapy Scrapy是一个为了爬取网站数据,提 ...
- scrapy爬虫框架教程(二)-- 爬取豆瓣电影TOP250
scrapy爬虫框架教程(二)-- 爬取豆瓣电影TOP250 前言 经过上一篇教程我们已经大致了解了Scrapy的基本情况,并写了一个简单的小demo.这次我会以爬取豆瓣电影TOP250为例进一步为大 ...
- Python爬虫教程-31-创建 Scrapy 爬虫框架项目
本篇是介绍在 Anaconda 环境下,创建 Scrapy 爬虫框架项目的步骤,且介绍比较详细 Python爬虫教程-31-创建 Scrapy 爬虫框架项目 首先说一下,本篇是在 Anaconda 环 ...
- Python-S9-Day126——Scrapy爬虫框架
01 今日内容概要 02 内容回顾和补充:scrapy 03 内容回顾和补充:网络和并发编程 04 Scrapy爬虫框架:pipeline做持久化(一) 05 Scrapy爬虫框架:pipeline做 ...
- 手把手教你如何新建scrapy爬虫框架的第一个项目(上)
前几天给大家分享了如何在Windows下创建网络爬虫虚拟环境及如何安装Scrapy,还有Scrapy安装过程中常见的问题总结及其对应的解决方法,感兴趣的小伙伴可以戳链接进去查看.关于Scrapy的介绍 ...
随机推荐
- java的hashcode(结合hashset讲解)
equals()跟hashcode()都可以用来比较对象.hashcode通过不同对象有不同的散列码来比较两个对象. hashcode方法把对象放到一个对象容器进行查找,算法好坏直接影响容器的存取效率 ...
- vs2010 单文档MFC 通过加载位图文件作为客户区背景
实现效果: 这个其实是一个非常常见的功能,大家都会考虑给自己简单的工程做一个背景界面.其实只要在view类中重载OnEraseBkgnd()这个函数就好了. 代码如下: BOOL CdddView:: ...
- 【算法导论】八皇后问题的算法实现(C、MATLAB、Python版)
八皇后问题是一道经典的回溯问题.问题描述如下:皇后可以在横.竖.斜线上不限步数地吃掉其他棋子.如何将8个皇后放在棋盘上(有8*8个方格),使它们谁也不能被吃掉? 看到这个问题,最容易想 ...
- Ubuntu_ROS中应用kinect v2笔记
Ubuntu_ROS中应用kinect v2笔记 个人觉得最重要的资料如下: 1. Microsoft Kinect v2 Driver Released http://www.ros.org/new ...
- 【翻译】在Ext JS集成第三方库
原文地址:http://www.sencha.com/blog/integrating-ext-js-with-3rd-party-libraries/ 作者:Kevin Kazmierczak Ke ...
- C#数据库连接操作大全
一:数据库连接代码: SqlConnection objSqlConnection = new SqlConnection ("server = 127.0.0.1;uid = sa; pw ...
- Linux下简易线程池
线程池简介 线程池是可以用来在后台执行多个任务的线程集合. 这使主线程可以自由地异步执行其他任务.线程池通常用于服务器应用程序. 每个传入请求都将分配给线程池中的一个线程,因此可以异步处理请求,而不会 ...
- C++语言之析构函数与构造函数
#include <iostream> using namespace std ; class Dog { //默认情况下定义变量为私有 int a ; public: //两个函数都只能 ...
- C# 操作Excel数据透视表
一.概述 数据透视表(Pivot Table)是一种交互式的表,可以进行某些计算,如求和与计数等,可动态地改变透视表版面布置,也可以重新安排行号.列标和页字段.当改变版面布置时,数据透视表也会按照新的 ...
- css左侧固定宽度右侧自适应
左侧固定宽,右侧自适应屏幕宽: 左右两列,等高布局: 左右两列要求有最小高度,例如:200px;(当内容超出200时,会自动以等高的方式增高) 要求不用JS或CSS行为实现: 仔细分析试题要求,要达到 ...