
linux安装spark-2.3.0集群
(安装spark集群的前提是服务器已经配置了jdk并且安装hadoop集群(主要是hdfs)并正常启动,hadoop集群安装可参考《hadoop集群搭建(hdfs)》)
1、配置scala环境
详细配置过程可参考《linux安装scala环境》,此处就不在详细描述
2、下载spark安装包
因为我之前安装的hadoop是3.0版本的,所以spark我使用的是spark-2.3.0版本
wget https://www.apache.org/dyn/closer.lua/spark/spark-2.3.0/spark-2.3.0-bin-hadoop2.7.tgz
3、解压安装包
tar zxvf spark-2.3.0-bin-hadoop2.7.tgz
4、修改配置文件
1、spark-env.sh
复制spark-env.sh.template文件成spark-env.sh(cp spark-env.sh.template spark-env.sh)
在spark-env.sh末尾增加以下配置:
export JAVA_HOME=/usr/java/jdk1.8.0_11

export SCALA_HOME=${SCALA_HOME}

export HADOOP_HOME=/home/hadoop/hadoop-3.0.0

export STANDALONE_SPARK_MASTER_HOST=node101

export SPARK_MASTER_IP=$STANDALONE_SPARK_MASTER_HOST

export SPARK_LAUNCH_WITH_SCALA=0

export SPARK_LIBRARY_PATH=${SPARK_HOME}/lib

export SCALA_LIBRARY_PATH=${SPARK_HOME}/lib

export SPARK_MASTER_WEBUI_PORT=18080

if [ -n "$HADOOP_HOME" ]; then

  export SPARK_LIBRARY_PATH=$SPARK_LIBRARY_PATH:${HADOOP_HOME}/lib/native

fi

export HADOOP_CONF_DIR=/home/hadoop/hadoop-3.0.0/etc/hadoop
2、slaves
复制slaves.template文件成slaves(cp slaves.template slaves)
修改slave是文件的内容为:
#

# Licensed to the Apache Software Foundation (ASF) under one or more

# contributor license agreements.  See the NOTICE file distributed with

# this work for additional information regarding copyright ownership.

# The ASF licenses this file to You under the Apache License, Version 2.0

# (the "License"); you may not use this file except in compliance with

# the License.  You may obtain a copy of the License at

#

#    http://www.apache.org/licenses/LICENSE-2.0

#

# Unless required by applicable law or agreed to in writing, software

# distributed under the License is distributed on an "AS IS" BASIS,

# WITHOUT WARRANTIES OR CONDITIONS OF ANY KIND, either express or implied.

# See the License for the specific language governing permissions and

# limitations under the License.

#

# A Spark Worker will be started on each of the machines listed below.

node101

node102

node103
3、将整个spark解压出来的文件拷贝到另外的两台机器上
5、启动spark集群
cd /home/hadoop/spark/sbin
./start-all.sj
启动成功后会有如下的信息

6、检查各节点spark启动情况
分别在三台服务器上使用jps命令查看Master进程和worker进程是否存在,一下是分别是三台服务器的情况
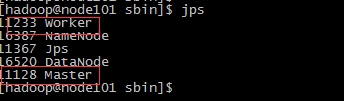
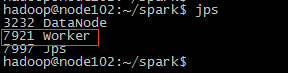
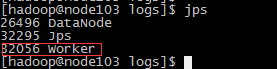
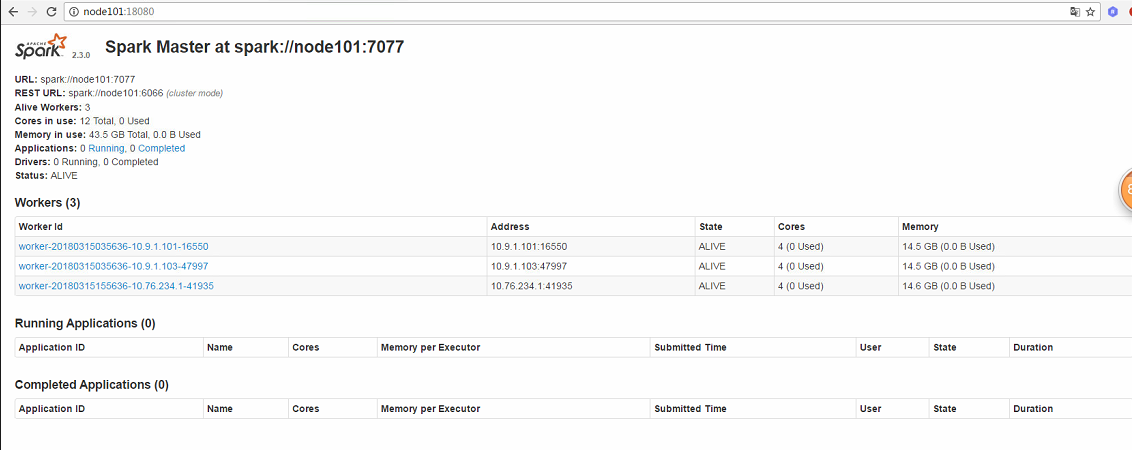
7、使用spark-web在浏览器上查看spark集群的运行情况(之前在配置文件里面配置的端口是18080)
linux安装spark-2.3.0集群的更多相关文章
- spark 2.1.0 集群安装
jdk安装 http://www.cnblogs.com/xiaojf/p/6568426.html scala2.11 安装 http://www.cnblogs.com/xiaojf/p/6568 ...
- CentOS 7.4 安装 K8S v1.11.0 集群所遇到的问题
0.引言 最近打算将现有项目的 Docker 部署到阿里云上面,但是之前是单机部署,现在阿里云上面有 3 台机器,所以想做一个 Docker 集群.之前考虑是用 Docker Swarm 来做这个事情 ...
- Linux安装ElasticSearch与MongoDB分布式集群环境下数据同步
ElasticSearch有一个叫做river的插件式模块,可以将外部数据源中的数据导入elasticsearch并在上面建立索引.River在集群上是单例模式的,它被自动分配到一个节点上,当这个节点 ...
- hadoop 2.6.0 分布式 + Spark 1.1.0 集群环境
配置jdk 执行 sudo apt-get install openjdk-7-jdk jdk被安装到了 /usr/lib/jvm/ 目录 配置hosts 使用 vim 打开 /etc/hosts, ...
- Linux安装MYSQL并部署主从复制集群
主节点部署 安装数据库 Ubuntu apt-get install mysql-server -y systemctl start mysql systemctl enabled mysql Cen ...
- kubeadm安装kubernetes V1.11.1 集群
之前测试了离线环境下使用二进制方法安装配置Kubernetes集群的方法,安装的过程中听说 kubeadm 安装配置集群更加方便,因此试着折腾了一下.安装过程中,也有一些坑,相对来说操作上要比二进制方 ...
- Linux基于Hadoop2.8.0集群安装配置Hive2.1.1及基础操作
前言 安装Apache Hive前提是要先安装hadoop集群,并且hive只需要在hadoop的namenode节点集群里安装即可,安装前需保证Hadoop已启(动文中用到了hadoop的hdfs命 ...
- hadoop2.20.0集群安装教程
一.安装的需要软件及集群描述 1.软件: Vmware9.0:虚拟机 Hadoop2.2.0:Apache官网原版稳定版本 JDK1.7.0_07:Oracle官网版本 Ubuntu12.04LTS: ...
- hadoop 2.2.0集群安装详细步骤(简单配置,无HA)
安装环境操作系统:CentOS 6.5 i586(32位)java环境:JDK 1.7.0.51hadoop版本:社区版本2.2.0,hadoop-2.2.0.tar.gz 安装准备设置集群的host ...
随机推荐
- javascript的构造函数和实例对象、prototype和__proto__的区别,原型对象及构造器的理解
一.前言 我们先通过代码来分别打印出实例对象.构造函数,以及修改了原型对象的构造函数,通过对比内部结构来看看他们之间的区别. //定义构造函数 function Person(name, age){ ...
- leetcode 235 236 二叉树两个节点的最近公共祖先
描述: 给定二叉树两个节点,求其最近公共祖先.最近即所有公共祖先中深度最深的. ps:自身也算自身的祖先. 235题解决: 这是二叉搜索树,有序的,左边小右边大. TreeNode* lowestCo ...
- Django基础学习六之渲染
今天简单的介绍一下Django的template的渲染和Django的template的基本的语法 首先我们先启动一个django的shell,首先需要进入django的工程目录下启动django的s ...
- mybatis框架入门程序:演示通过mybatis实现数据库的添加操作
1.mybatis的基本配置准备在我的这篇博文中可以找到:https://www.cnblogs.com/wyhluckdog/p/10149480.html 2. 映射文件: 在User.xml中添 ...
- UX设计案例研究:建立更好的用户体验(重新设计Air Peace Airline网站)
以下内容由Mockplus团队翻译整理,仅供学习交流,Mockplus是更快更简单的原型设计工具. 坐飞机旅行总是能给人带来很棒的体验,但我认为应该考虑预订航班时给用户带来的压力.在如今的数字世界,我 ...
- iOS7中的多任务I
[改变了后台任务的运行方式] 在iOS6和之前的系统中,系统在用户退出应用后,如果应用正在执行后台任务的话,系统会保持活跃状态直到后台任务完成或者是超时以后,才会进入真正的低功耗休眠状态. 而在iOS ...
- android studio使用真机测试时点击Debug调试模式时报Error running app:No target device found,点击运行模式却是启动正常的
原因是adb没检测到设备(包括真机和虚拟机). 在Terminal执行adb devices命令,查看有没有连接到的设备. 如果没有设备,确认虚拟机是否正确打开,真机是否连接打开USB调试并安装驱动. ...
- 让Asp.Net WebAPI支持OData查询,排序,过滤。(转)
出处:http://www.cnblogs.com/liuzhendong/p/4233380.html 让Asp.Net WebAPI支持OData后,就能支持在url中直接输入排序,过滤条件了. ...
- Android 一些注意
半年没碰android,想给一个按钮写个click,硬是想不起来怎么搞,哎! 1.编码问题调整 2.引用框架问题 3.界面设计无法显示问题,需要调整设计界面的API Level 4.任意输入自动提示 ...
- CSS —— line-height详解
本文导读:“行高“指一行文子的高度,具体来说是指两行文子间基线间的距离.在CSS,line-height被用来控制行与行之间的垂直距离.line-height 属性会影响行框的布局.在应用到一个块级元 ...