
Pipeline和FeatureUnion
注:本文是人工智能研究网的学习笔记
Pipeline:chaining(链接)estimators
Pipeline可以用于把多个estimators级联合成一个estimator。这么做的原因是考虑了数据处理过程的一系列前后相继的固定流程,比如:feature selection --> normalization --> classification。
在这里,Pipeline提供了两种服务:
- Convenience: 你只需要一次fit和predict就可以在数据集上训练一组estimators。
- Join parameter selection: 可以把grid search用在pipeline中所有的estimators的参数组合上面。
注意: pineline中除了最后一个之外的所有的estimators都必须是变换器(transformers)(也就是说必须要有一个transform方法)。最后一个estimator可以是任意的类型(transformer, classifier, regresser, etc)。
调用pipeline estimator的fit方法,就等于是轮流调用每一个estimator的fit函数一样,不断地变换输入,然后把结果传递到下一个阶段(step)的estimator。Pipeine对象实例拥有最后一个estimator的所有的方法。也就是说,如果最后一个estimator是一个分类器,则整个pipeline就可以作为一个分类器使用,如果最后一个eatimator是一个聚类器,则整个pipeline就可以作为一个聚类器使用。
Pipeline用法:
Pipeline对象使用(key, value)列表来构建,其中key是一个标识步骤的名称字符串,值是一个estimator对象:
from sklearn.pipeline import Pipeline

from sklearn.svm import SVC

from sklearn.decomposition import PCA  # 主成分分析

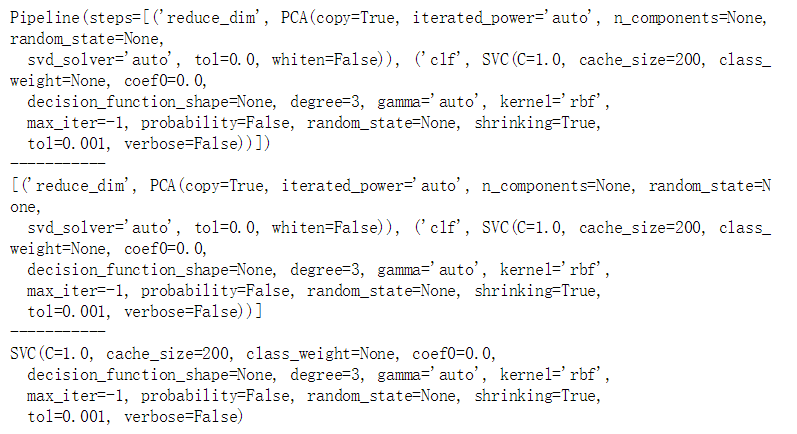
estimators = [('reduce_dim', PCA()), ('clf', SVC()) ]

pipe = Pipeline(estimators)

print(pipe)

print('-----------')

print(pipe.steps)

print('-----------')

print(pipe.named_steps['clf'])
Pipeline中estimators的参数通过__语法来获取
pipe.set_params(clf__C=10)
上面的方式在网格搜索中尤其好用
from sklearn.model_selection import GridSearchCV

params = dict(reduce_dim__n_components=[2, 5, 10],

              clf__C=[0.1, 10, 100])

grid_search = GridSearchCV(pipe, param_grid=params)
单个的阶段(Step)可以使用参数替换,而且非最后阶段(non-final steps)还可以将其设置为None来忽略。
from sklearn.linear_model import LogisticRegression

params = dict(reduce_dim=[None, PCA(5), PCV(10)],

              clf=[SVC(), LogisticRegression()],

              clf__C=[0.1, 10, 100])

grid_search = GridSearchCV(pipe, param_grid=params)
函数make_pipeline是一个构造pipeline的简短的工具,它可以接受可变数量的estimators并且返回一个pipeline,每个estimator的名称是自动填充的,他不需要指定name。
from sklearn.pipeline import make_pipeline

from sklearn.naive_bayes import MultinomialNB

from sklearn.preprocessing import Binarizer

make_pipeline(Binarizer(), MultinomialNB())

FeatureUnion: composite(组合)feature spaces
FeatureUnion把若干个transformer object组合成一个新的estimators。这个新的transformer组合了他们的输出,一个FeatureUnion对象接受一个transformer对象列表。
在训练阶段,每一个transformer都在数据集上独立的训练。在数据变换阶段,多有的训练好的Trandformer可以并行的执行。他们输出的样本特征向量被以end-to-end的方式拼接成为一个更大的特征向量。
在这里,FeatureUnion提供了两种服务:
- Convenience: 你只需要调用一次fit和transform就可以在数据集上训练一组estimators。
- Joint parameter selection: 可以把grid search用在FeatureUnion中所有的estimators的参数这上面。
FeatureUnion和Pipeline可以组合使用来创建更加复杂的模型。
注意:FeatureUnion无法检查两个transformers是否产生了相同的特征输出,它仅仅产生了一个原来互相分离的特征向量的集合。确保其产生不一样的特征输出是调用者的事情。
用法:
FeatureUnion对象实例使用(key, value)构成的list来构造,key是你自己起的transformation的名称,value是一个estimator对象。
from sklearn.pipeline import FeatureUnion

from sklearn.decomposition import PCA

from sklearn.decomposition import KernelPCA

estimators = [('linear_pca', PCA()), ('kernel_pca', KernelPCA())]

combined = FeatureUnion(estimators)

combined
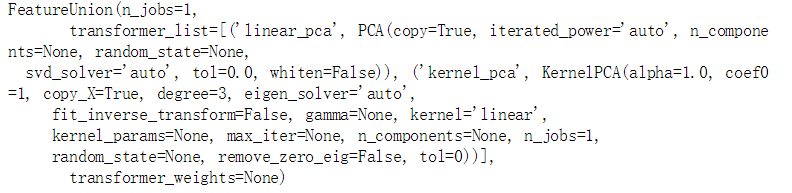
与pipeline类似,feature unions也有一个比较简单地构造方法make_union,不需要显式的给出name。
Pipeline和FeatureUnion的更多相关文章
- sklearn 中的 Pipeline 机制 和FeatureUnion
一.pipeline的用法 pipeline可以用于把多个estimators级联成一个estimator,这么 做的原因是考虑了数据处理过程中一系列前后相继的固定流程,比如feature selec ...
- sklearn中pipeline的用法和FeatureUnion
一.pipeline的用法 pipeline可以用于把多个estimators级联成一个estimator,这么 做的原因是考虑了数据处理过程中一系列前后相继的固定流程,比如feature selec ...
- [Machine Learning with Python] My First Data Preprocessing Pipeline with Titanic Dataset
The Dataset was acquired from https://www.kaggle.com/c/titanic For data preprocessing, I firstly def ...
- [Feature] Final pipeline: custom transformers
有视频:https://www.youtube.com/watch?v=BFaadIqWlAg 有代码:https://github.com/jem1031/pandas-pipelines-cust ...
- [Feature] Build pipeline
准备数据集 一.数据集 Ref: 6. Dataset loading utilities[各种数据集选项] 第一部分,加载原始iris数据集的数据: 第二部分,先增加一行,再增加一列: #%% pa ...
- pipeline和baseline是什么?
昨天和刚来项目的机器学习小白解释了一边什么baseline 和pipeline,今天在这里总结一下什么是baseline和pipeline. 1.pipeline 1.1 从管道符到pipeline ...
- [占位-未完成]scikit-learn一般实例之十一:异构数据源的特征联合
[占位-未完成]scikit-learn一般实例之十一:异构数据源的特征联合 Datasets can often contain components of that require differe ...
- 使用sklearn优雅地进行数据挖掘【转】
目录 1 使用sklearn进行数据挖掘 1.1 数据挖掘的步骤 1.2 数据初貌 1.3 关键技术2 并行处理 2.1 整体并行处理 2.2 部分并行处理3 流水线处理4 自动化调参5 持久化6 回 ...
- 使用sklearn优雅地进行数据挖掘
目录 1 使用sklearn进行数据挖掘 1.1 数据挖掘的步骤 1.2 数据初貌 1.3 关键技术2 并行处理 2.1 整体并行处理 2.2 部分并行处理3 流水线处理4 自动化调参5 持久化6 回 ...
随机推荐
- sql 通过分数字段倒排获取名次的方法
row_number() over(order by sort desc) 应用场景: 比如学员成绩表中有userid,username,sorce登字段,需要取出学员成绩的名次:表中没有名次字段,只 ...
- JavaScript 实用技巧和写法建议
1.前言 从大学到现在,接触前端已经有几年了,感想方面,就是对于程序员而言,想要提高自己的技术水平和编写易于阅读和维护的代码,我觉得不能每天都是平庸的写代码,更要去推敲,去摸索和优化代码,总结当中的技 ...
- UNIX环境高级编程 第16章 网络IPC:套接字
上一章(15章)中介绍了UNIX系统所提供的多种经典进程间通信机制(IPC):管道PIPE.命名管道FIFO.消息队列Message Queue.信号量Semaphore.共享内存Shared Mem ...
- iframe测试
iframe类似于frameset,iframe 和 frameset 都用于html页面的框架布局.(都可用于后台管理界面,iframe放于body标签内,frameset不能放在body标签) 1 ...
- solr后台界面介绍——(十一)
1.加一个collection的方法 复制solr-home下的collection1,修改名字为collection2.并且修改collection2文件夹中配置文件core.properties中 ...
- oracle字符集查看、修改、版本查看
.1.先查服务端的字符集 或者 2.再查客户端的字符集 两个字符集(不是语言)一致的话就不会乱码了 详细资料 一.什么是Oracle字符集 Oracle字符集是一个字节数据的解释的符号集合,有 ...
- Django中六个常用的自定义装饰器
装饰器作用 decorator是当今最流行的设计模式之一,很多使用它的人并不知道它是一种设计模式.这种模式有什么特别之处? 有兴趣可以看看Python Wiki上例子,使用它可以很方便地修改对象行为, ...
- 系统架构之负载均衡【F5\nginx\LVS\DNS轮询\】
在做系统架构规划的时候,负载均衡,HA(高可用性集群,是保证业务连续性的有效解决方案,一般有两个或两个以上的节点,且分为活动节点及备用节点,当活动节点出现故障的时候,由备用节点接管)都是经常需要考虑的 ...
- git clone直接提交用户名和密码
git使用用户名密码clone的方式: git clone http://username:password@remote 例如:我的用户名是abc@qq.com,密码是abc123456,git地址 ...
- 002_IO磁盘深入理解
一.如何测试云硬盘 https://www.ustack.com/blog/how-benchmark-ebs/#fio