
从RDD创建DataFrame
0.前次作业:从文件创建DataFrame
1.pandas df 与 spark df的相互转换 df_s=spark.createDataFrame(df_p) df_p=df_s.toPandas()
# 从数组创建pandas dataframe

import pandas as pd

import numpy as np

arr = np.arange(6).reshape(-1,3)

arr

df_p = pd.DataFrame(arr)

df_p

df_p.columns = ['a','b','c']

df_p

# pandas df 转为spark df

df_s = spark.createDataFrame(df_p)

df_s.show()

df_s.collect()

# spark df 转为pandas df

df_s.show()

df_s.toPandas()

2. Spark与Pandas中DataFrame对比
http://www.lining0806.com/spark%E4%B8%8Epandas%E4%B8%ADdataframe%E5%AF%B9%E6%AF%94/
3.1 利用反射机制推断RDD模式
- sc创建RDD
spark.sparkContext.textFile("file:///D:/Spark/spark-2.4.7-bin-hadoop2.7/examples/src/main/resources/people.txt").first()

spark.sparkContext.textFile("file:///D:/Spark/spark-2.4.7-bin-hadoop2.7/examples/src/main/resources/people.txt")\

.map(lambda line:line.split(',')).first()

- 转换成Row元素,列名=值
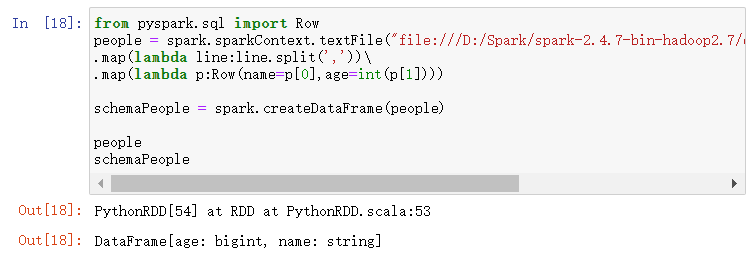
from pyspark.sql import Row

people = spark.sparkContext.textFile("file:///D:/Spark/spark-2.4.7-bin-hadoop2.7/examples/src/main/resources/people.txt")\

.map(lambda line:line.split(','))\

.map(lambda p:Row(name=p[0],age=int(p[1])))
- spark.createDataFrame生成df
schemaPeople = spark.createDataFrame(people)
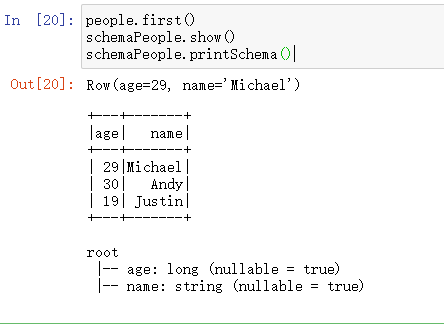
- df.show(), df.printSchema()
schemaPeople.show()

schemaPeople.printSchema()
3.2 使用编程方式定义RDD模式
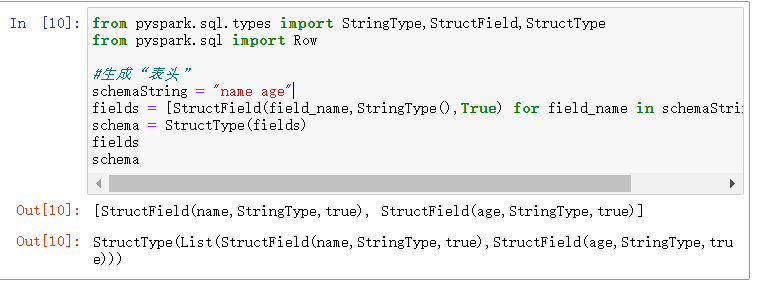
- 生成“表头”
- fields = [StructField(field_name, StringType(), True) ,...]
- schema = StructType(fields)
from pyspark.sql.types import StringType,StructField,StructType

from pyspark.sql import Row

#生成“表头”

schemaString = "name age"

fields = [StructField(field_name,StringType(),True) for field_name in schemaString.split(" ")]

schema = StructType(fields)
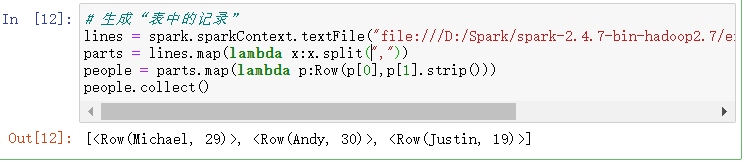
- 生成“表中的记录”
- 创建RDD
- 转换成Row元素,列名=值
# 生成“表中的记录”

lines = spark.sparkContext.textFile("file:///D:/Spark/spark-2.4.7-bin-hadoop2.7/examples/src/main/resources/people.txt")

parts = lines.map(lambda x:x.split(","))

people = parts.map(lambda p:Row(p[0],p[1].strip()))

people.collect()
- 把“表头”和“表中的记录”拼装在一起
- = spark.createDataFrame(RDD, schema)
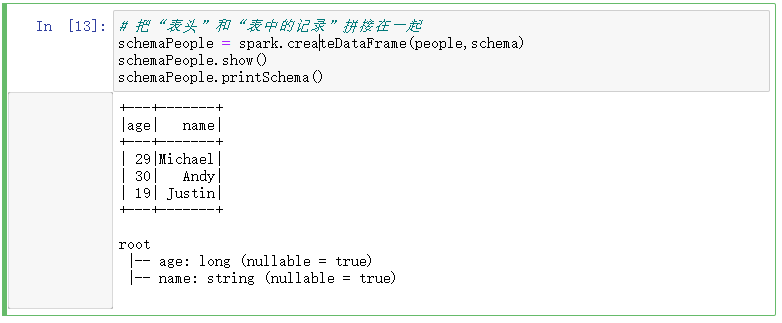
# 把“表头”和“表中的记录”拼接在一起

schemaPeople = spark.createDataFrame(people,schema)

schemaPeople.show()

schemaPeople.printSchema()
4. DataFrame保存为文件
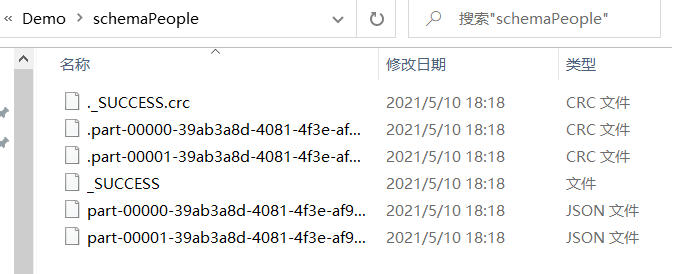
df.write.json(dir)
schemaPeople.write.json("file:///D:/Demo/schemaPeople")
预练习:
读 学生课程分数文件chapter4-data01.txt,创建DataFrame。并尝试用DataFrame的操作完成实验三的数据分析要求。
1.利用反射机制推断RDD模式
from pyspark.sql import Row

people = spark.sparkContext.textFile("file:///D:/chapter4-data01.txt")\

.map(lambda line:line.split(','))\

.map(lambda p:Row(name=p[0],course=p[1],score=int(p[2])))

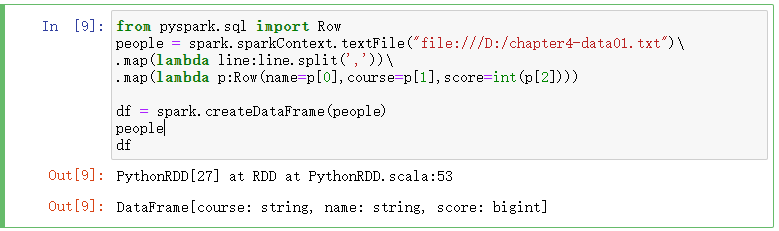
df = spark.createDataFrame(people)

people

df
people.first()

df.show()

df.printSchema()

2.使用编程方式定义RDD模式
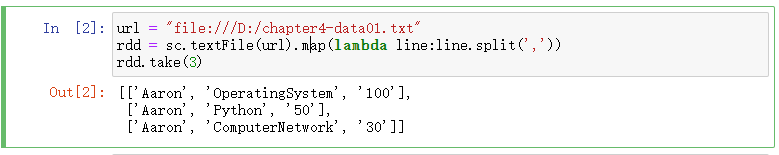
url = "file:///D:/chapter4-data01.txt"

rdd = sc.textFile(url).map(lambda line:line.split(','))

rdd.take(3)
from pyspark.sql.types import IntegerType,StringType,StructField,StructType

from pyspark.sql import Row

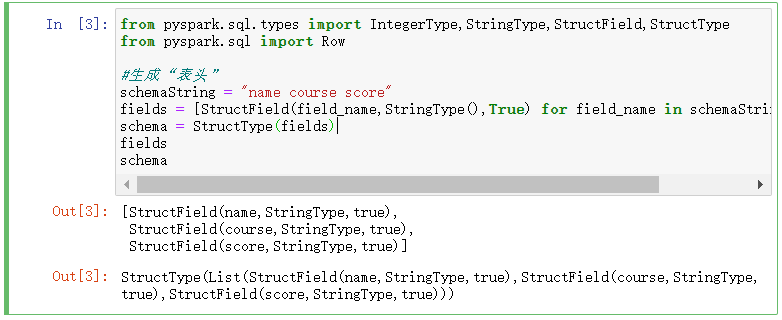
#生成“表头”

schemaString = "name course score"

fields = [StructField(field_name,StringType(),True) for field_name in schemaString.split(" ")]

schema = StructType(fields)

fields

schema
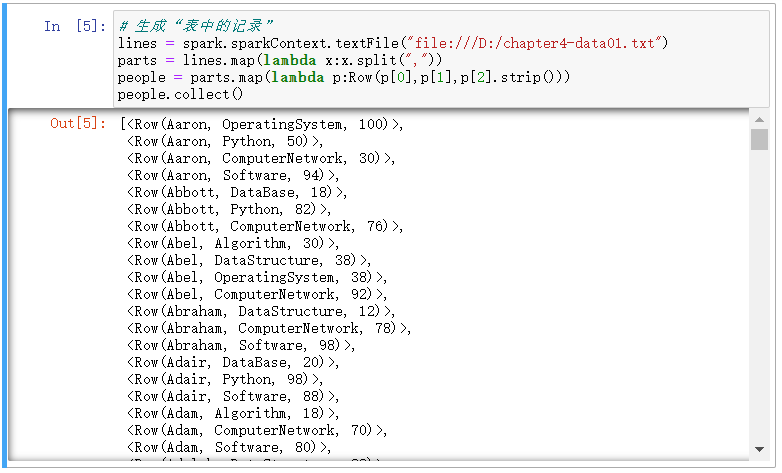
# 生成“表中的记录”

lines = spark.sparkContext.textFile("file:///D:/chapter4-data01.txt")

parts = lines.map(lambda x:x.split(","))

people = parts.map(lambda p:Row(p[0],p[1],p[2].strip()))

people.collect()
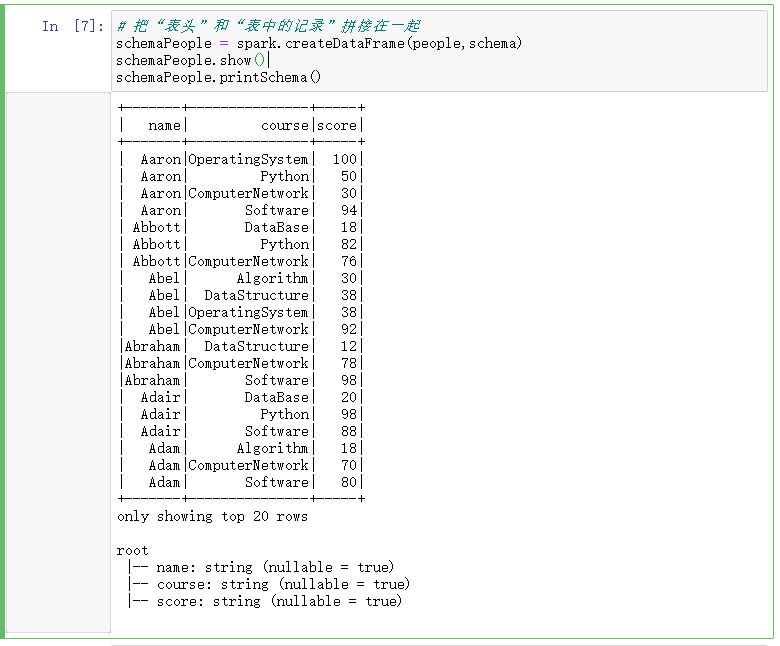
# 把“表头”和“表中的记录”拼接在一起

schemaPeople = spark.createDataFrame(people,schema)

schemaPeople.show()

schemaPeople.printSchema()
从RDD创建DataFrame的更多相关文章
- 07 从RDD创建DataFrame
1.pandas df 与 spark df的相互转换 df_s=spark.createDataFrame(df_p) df_p=df_s.toPandas() 2. Spark与Pandas中Da ...
- 【Spark篇】---SparkSQL初始和创建DataFrame的几种方式
一.前述 1.SparkSQL介绍 Hive是Shark的前身,Shark是SparkSQL的前身,SparkSQL产生的根本原因是其完全脱离了Hive的限制. SparkSQL支持查询原 ...
- Spark SQL初始化和创建DataFrame的几种方式
一.前述 1.SparkSQL介绍 Hive是Shark的前身,Shark是SparkSQL的前身,SparkSQL产生的根本原因是其完全脱离了Hive的限制. SparkSQL支持查询原 ...
- JAVA SparkSQL初始和创建DataFrame的几种方式
建议参考SparkSQL官方文档:http://spark.apache.org/docs/latest/sql-programming-guide.html 一.前述 1.SparkSQ ...
- 大数据学习day25------spark08-----1. 读取数据库的形式创建DataFrame 2. Parquet格式的数据源 3. Orc格式的数据源 4.spark_sql整合hive 5.在IDEA中编写spark程序(用来操作hive) 6. SQL风格和DSL风格以及RDD的形式计算连续登陆三天的用户
1. 读取数据库的形式创建DataFrame DataFrameFromJDBC object DataFrameFromJDBC { def main(args: Array[String]): U ...
- RDD、DataFrame和DataSet的区别
原文链接:http://www.jianshu.com/p/c0181667daa0 RDD.DataFrame和DataSet是容易产生混淆的概念,必须对其相互之间对比,才可以知道其中异同. RDD ...
- RDD与DataFrame的转换
RDD与DataFrame转换1. 通过反射的方式来推断RDD元素中的元数据.因为RDD本身一条数据本身是没有元数据的,例如Person,而Person有name,id等,而record是不知道这些的 ...
- 谈谈RDD、DataFrame、Dataset的区别和各自的优势
在spark中,RDD.DataFrame.Dataset是最常用的数据类型,本博文给出笔者在使用的过程中体会到的区别和各自的优势 共性: 1.RDD.DataFrame.Dataset全都是spar ...
- spark RDD,DataFrame,DataSet 介绍
弹性分布式数据集(Resilient Distributed Dataset,RDD) RDD是Spark一开始就提供的主要API,从根本上来说,一个RDD就是你的数据的一个不可变的分布式元素集合,在 ...
- Spark提高篇——RDD/DataSet/DataFrame(二)
该部分分为两篇,分别介绍RDD与Dataset/DataFrame: 一.RDD 二.DataSet/DataFrame 该篇主要介绍DataSet与DataFrame. 一.生成DataFrame ...
随机推荐
- kubernetes(k8s)安装命令行自动补全功能
Ubuntu下安装命令 root@master1:~# apt install -y bash-completion Reading package lists... Done Building de ...
- Semantic Kernel 入门系列:🛸LLM降临的时代
不论你是否关心,不可否认,AGI的时代即将到来了. 在这个突如其来的时代中,OpenAI的ChatGPT无疑处于浪潮之巅.而在ChatGPT背后,我们不能忽视的是LLM(Large Language ...
- 一文吃透Elasticsearch
本文已经收录到Github仓库,该仓库包含计算机基础.Java基础.多线程.JVM.数据库.Redis.Spring.Mybatis.SpringMVC.SpringBoot.分布式.微服务.设计模式 ...
- 华为云 OpenTiny 跨端、跨框架企业级开源组件库项目落地实践直播即将开启!
大家好,我是 Kagol,公众号:前端开源星球. "你们这个产品怎么只能在电脑上适配呀?我想在手机上看都不行,太麻烦了!!" "你们这个产品看起来太简单了,我想要@@功能 ...
- ts中报错信息收集
1. 错误代码 参考:https://www.mmbyte.com/article/92849.html 1 state.localuserInfo = JSON.parse(localStorage ...
- Python 列表的修改、添加和删除元素
列表修改.添加和删除元素 大多数创建的列表都是动态的,随程序的运行增删元素 修改列表元素 指定列表名和要修改的元素的索引,再指定要修改元素的新值 # 修改列表元素案例 motorcycles = [' ...
- Python-tomorrow应用于UI自动化的简单使用
一.简介 tomorrow属于第三方的一个模块,使用threads方法作为装饰器去修饰一个普通的函数,使其可以达到并发效果.使用起来非常简单. 二.安装 pip install tomorrow 使用 ...
- P1980 [NOIP2013 普及组] 计数问题
题目链接:https://www.luogu.com.cn/problem/P1980 术语 以下的英文术语均可以翻译为数字. digit: 一个数字字符,十进制就是 0-9 之间的一个字符: num ...
- Llinux系统(Centos/Ubuntu/Debian)弹性云系统盘扩容方法
警告: 1.调整过分区管理方式的,例如lvm管理方式,请忽略此教程. 2.ubuntu18系统暂不支持脚本扩容,请手动扩容,参看下面ubuntu18部分,用parted操作 脚本自动处理(推荐) SS ...
- SpringBoot自定义注解+AOP+redis实现防接口幂等性重复提交,从概念到实战
本文为千锋教育技术团独家创作,更多技术类知识干货,点个关注持续追更~ 接口幂等性是Web开发中非常重要的一个概念,它可以保证多次调用同一个接口不会对结果产生影响.如果你想了解更多关于接口幂等性的知识, ...