
013 MapReduce八股文的wordcount应用
一:Mapreduce编程模型
1.介绍
解决海量数据的计算问题。
》map:映射
处理不同机器上的块的数据,一个map处理一个块。
》reduce:汇总
将map的结果进行汇总合并
2.一个简单的MR程序
map
reduce
input
output
3.在处理中,格式的流向
《key,value》
4.需要思考的问题
处理的数据是什么样的
map的输出格式
reduce的输出数据格式
二:完成Wordcount的程序
1.数据的输入格式说明(默认方式)
Hadoop Yarn
》key:代表偏移量
》value:这一行的值
》<0,Hadoop Yarn>
2.map处理的数据格式
Hadoop Yarn
Hadoop Spark
分割单词
每出现一次就这样处理一下
<Hadoop,1> <Yarn,1>
<Hadoop,1> <Spark,1>
3.reduce处理的数据格式
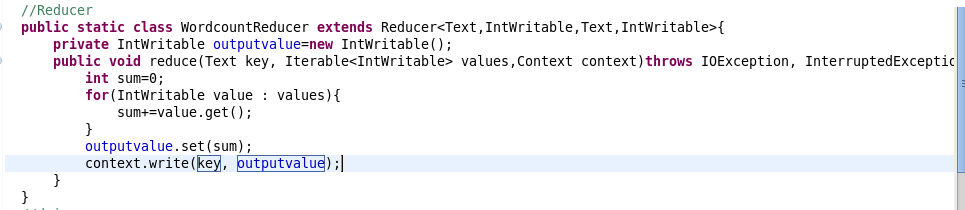
将相同key的value值加在一起就是单词出现的次数
4.新建包以及类

5.将程序分成三块的框架
Mapper类,Reducer类,Driver的run方法
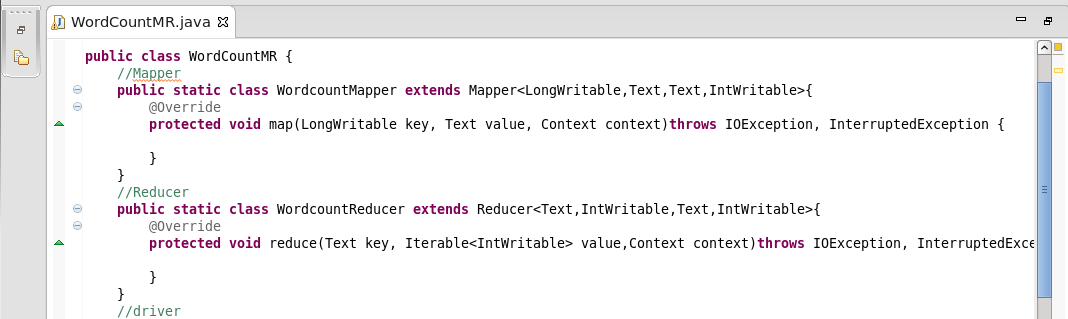
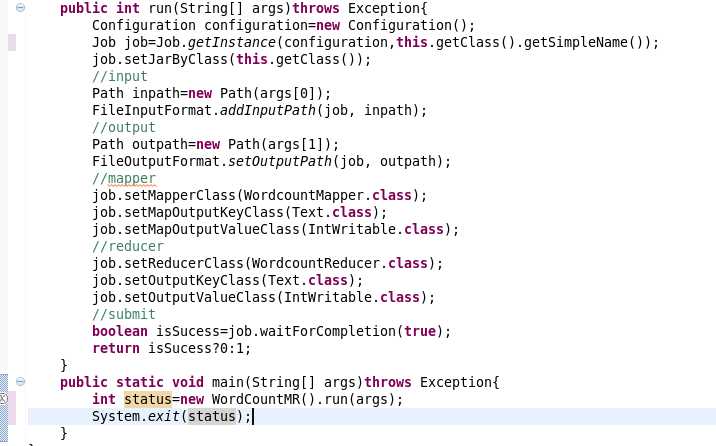
3.将map与reduce相结合,并在main中运行
分为四大部分:input,output,mapper,reducer
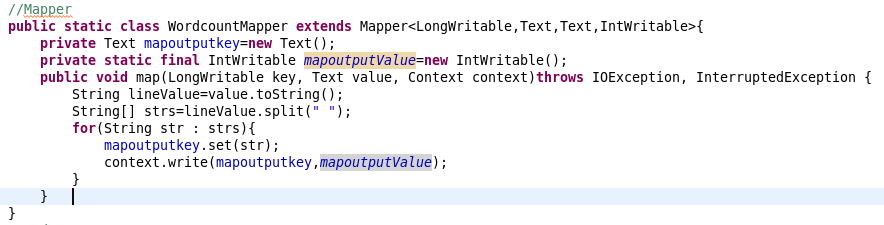
4.Mapper类
将value转化为字符串
使用空格分隔
使用context输出键值对。
5.Reducer类
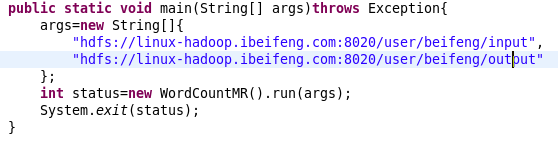
6.在main()中写入文件操作系统的路径。
7.结果
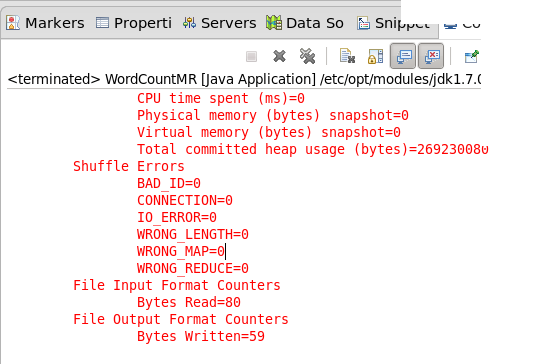
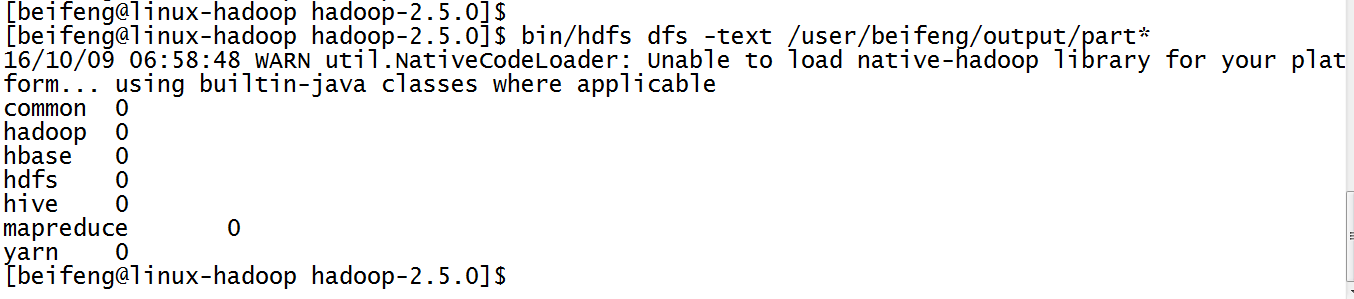
8.出现的结果有些问题,因为没有计数。

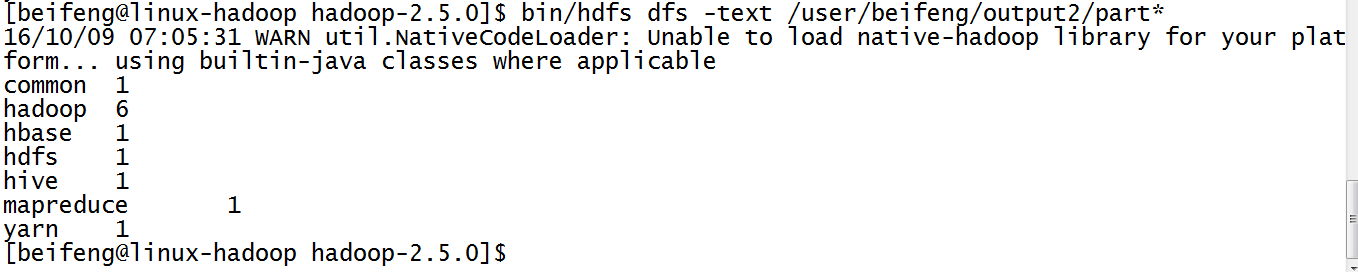
IntWritable(1),其参数为1.表示每出现一次就记录一次。
9.最新的结果
三:打包在yarn上运行
10.因为需要把jar分发到节点上,所以需要修改

11.打jar包
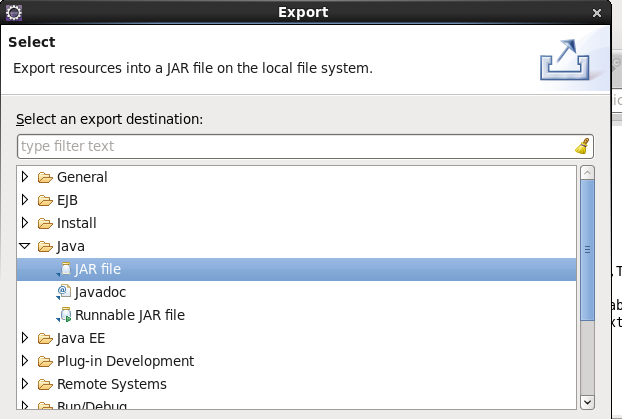
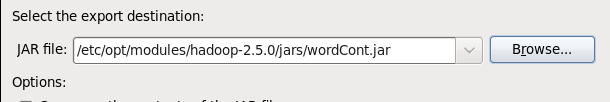
12.选择jar包的路径
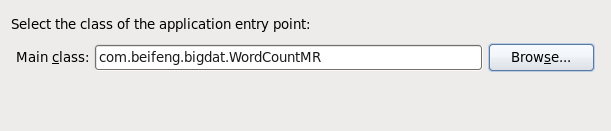
13.选择jar运行的主类
14.运行jar在yarn上
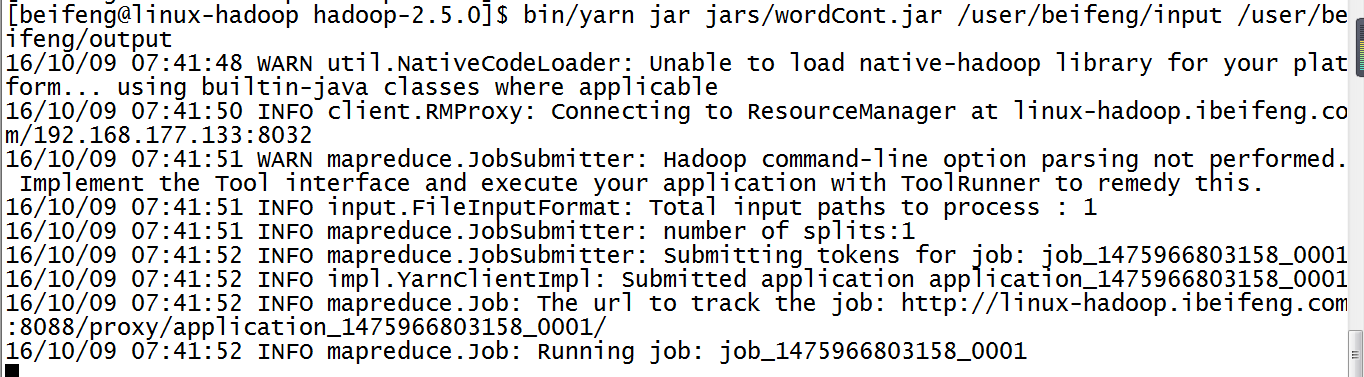
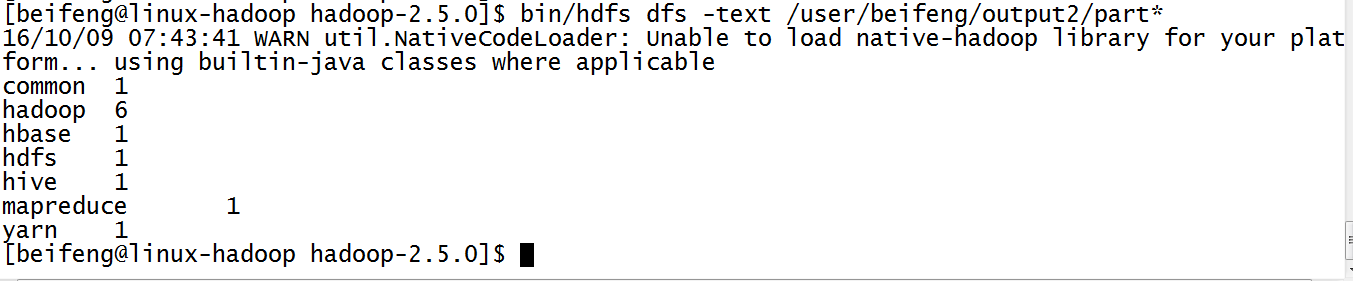
15.运行结果
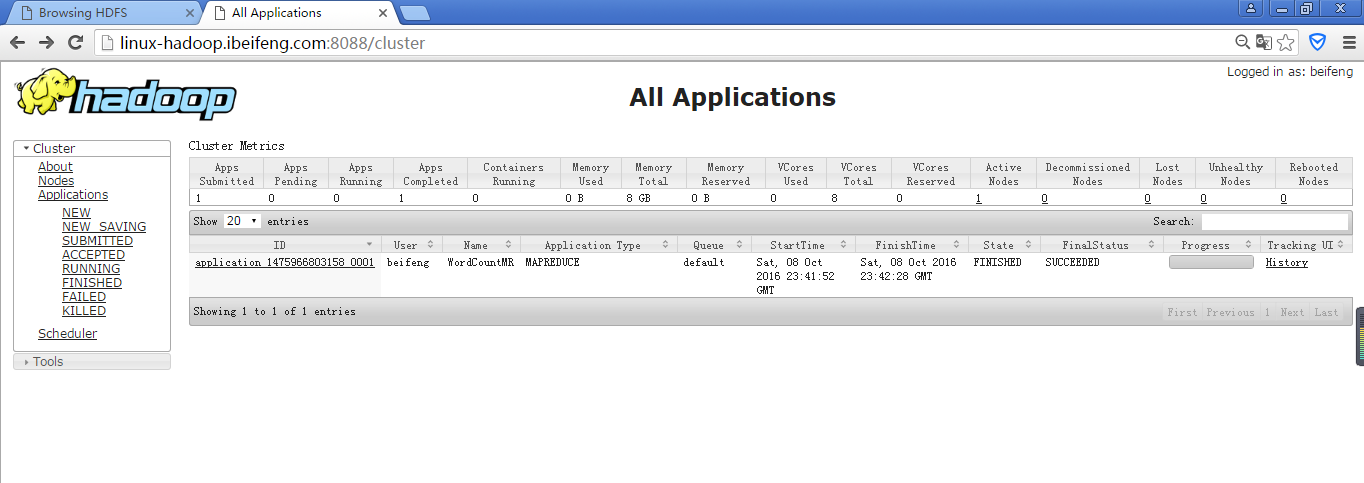
16.在yarn的管理界面上看
17.在Configuration中search一下mapper
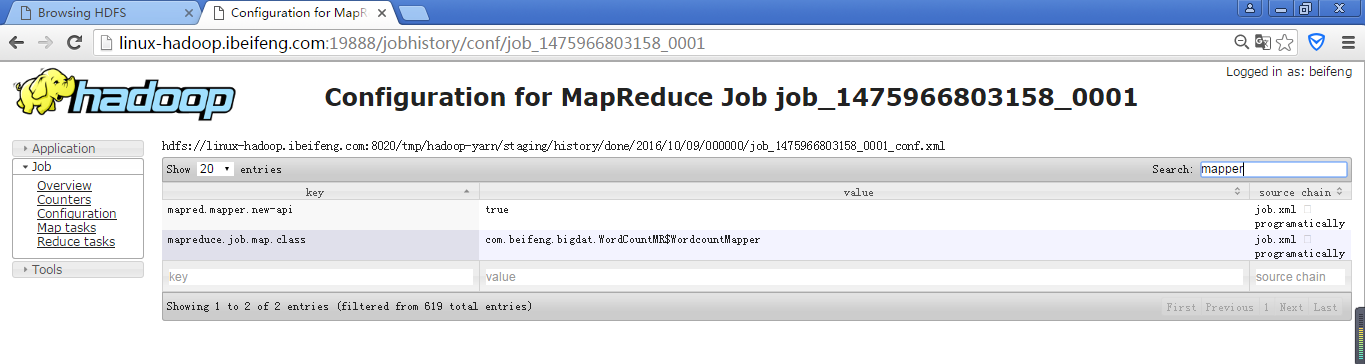
同样可以reduce,或者fileoutput等查阅一些参数。
013 MapReduce八股文的wordcount应用的更多相关文章
- MapReduce编程之wordcount
实践 MapReduce编程之wordcount import org.apache.hadoop.conf.Configuration; import org.apache.hadoop.fs.Fi ...
- mapreduce入门之wordcount注释详解
mapreduce版本:0.2.0之前 说明: 该注释为之前学习时找到的一篇,现在只是在入门以后对该注释做了一些修正以及添加. 由于版本问题,该代码并没有在集群环境中运行,只将其做为理解mapredu ...
- mapreduce程序编写(WordCount)
折腾了半天.终于编写成功了第一个自己的mapreduce程序,并通过打jar包的方式运行起来了. 运行环境: windows 64bit eclipse 64bit jdk6.0 64bit 一.工程 ...
- 2 weekend110的mapreduce介绍及wordcount + wordcount的编写和提交集群运行 + mr程序的本地运行模式
把我们的简单运算逻辑,很方便地扩展到海量数据的场景下,分布式运算. Map作一些,数据的局部处理和打散工作. Reduce作一些,数据的汇总工作. 这是之前的,weekend110的hdfs输入流之源 ...
- Mapreduce概述和WordCount程序
一.Mapreduce概述 Mapreduce是分布式程序编程框架,也是分布式计算框架,它简化了开发! Mapreduce将用户编写的业务逻辑代码和自带默认组合整合成一个完整的分布式运算程序,并发的运 ...
- 运行第一个MapReduce程序,WordCount
1.安装Eclipse 安装后如果无法启动重新配置Java路径(如果之前配置了Java) 2.下载安装eclipse的hadoop插件 注意版本对应,放到/uer/lib/eclipse/plugin ...
- MapReduce 编程模型 & WordCount 示例
学习大数据接触到的第一个编程思想 MapReduce. 前言 之前在学习大数据的时候,很多东西很零散的做了一些笔记,但是都没有好好去整理它们,这篇文章也是对之前的笔记的整理,或者叫输出吧.一来是加 ...
- Hadoop学习之路(5)Mapreduce程序完成wordcount
程序使用的测试文本数据: Dear River Dear River Bear Spark Car Dear Car Bear Car Dear Car River Car Spark Spark D ...
- 用python写MapReduce函数——以WordCount为例
尽管Hadoop框架是用java写的,但是Hadoop程序不限于java,可以用python.C++.ruby等.本例子中直接用python写一个MapReduce实例,而不是用Jython把pyth ...
随机推荐
- golang string int int64转换
#string到int int,err:=strconv.Atoi(string) #string到int64 int64, err := strconv.ParseInt(string, 10, 6 ...
- Linux之目录结构解析
/ /bin 存放[二进制可执行命令]目录,与usr/bin相比,它是系统性的.主要放置一些系统的必备执行档.例如:cat.cp.chmod df.dmesg.gzip.kill.ls. mkd ...
- P3806 【模板】点分治1(CDQ分治)
题目链接:https://www.luogu.org/problemnew/show/P3806 题目大意:中文题目 具体思路:直接dfs好像会超时,然后我们就开始想优化的方法,然后就是一个CDQ入门 ...
- 简单透彻理解JSONP原理及使用
首先提一下JSON这个概念,JSON是一种轻量级的数据传输格式,被广泛应用于当前Web应用中.JSON格式数据的编码和解析基本在所有主流语言中都被实现,所以现在大部分前后端分离的架构都以JSON格式进 ...
- WPF开发中的多线程的问题
今天帮助同事做了一个WPF版的多线程demo,分享给大家. 要实现的问题就是非主线程thread1 去后台不停的取新数据,当有新数据的时候就会展示到前台. 我给他做的demo实现一个按秒的计数器,随着 ...
- WEBSHELL恶意代码批量提取清除工具
场景 使用D盾扫描到WEBSHELL后可以导出有路径的文本文件. 最后手动去把WEBSHELL复制到桌面然后以文件路径命名,挨个删除. D盾界面是这样的. 手动一个个找WEBSHELL并且改名效率太低 ...
- 如何在linux下检测内存泄漏(转)
本文转自:http://www.ibm.com/developerworks/cn/linux/l-mleak/ 本文针对 linux 下的 C++ 程序的内存泄漏的检测方法及其实现进行探讨.其中包括 ...
- openssl版本升级操作记录【转】
需要部署nginx的https环境,之前是yum安装的openssl,版本比较低,如下: [root@nginx ~]# yum install -y pcre pcre-devel openss ...
- zabbix3.0.4使用shell脚本和zabbix自带模板两种方法添加对指定进程和端口的监控
zabbix3.0.4添加对进程的监控: 方法一:通过自定义命令进行监控 主要思路: 通过 ps -ef|grep sdk-push-1.0.0.jar |grep -v grep|wc -l 这个命 ...
- AndroidStudio、gradle、buildToolsVersion关系
使用AndroidStudio 开发也已经2年了,每次gradle 或者studio 有推荐更新后,项目重新sync后都会报错,提示更新相应的其他版本,比如AndroidStudio.gradle.b ...