
Python——初识网络爬虫(网页爬取)
网络爬虫(又称为网页蜘蛛,网络机器人,在FOAF社区中间,更经常的称为网页追逐者),是一种按照一定的规则,自动地抓取万维网信息的程序或者脚本。另外一些不常使用的名字还有蚂蚁、自动索引、模拟程序或者蠕虫。爬虫实在是计算机从业者的福音,它大大的缩减了我们的工作量。今天,我们就来尝试一下网页的爬取。
首先,我们需要安装两个基本的库,requests和beautifulsoup4。
requests:requests是Python中一个第三方库,基于 urllib,采用 Apache2 Licensed 开源协议的 HTTP 库。它比 urllib 更加方便,可以节约我们大量的工作,完全满足 HTTP 测试需求。
beautifulsoup4:Beautiful Soup 是用Python写的一个HTML/XML的解析器,它可以很好的处理不规范标记并生成剖析树(parse tree)。 它提供简单又常用的导航(navigating),搜索以及修改剖析树的操作。它可以大大节省你的编程时间。
我们安装这两个库的最简单的方法当然是通过pip指令。首先打开控制台,输入cmd,然后输入指令:
pip install requests/beautifulsoup4
即可自动安装。(关于pip的基本用法请见上一篇博客:https://www.cnblogs.com/Chen-K/p/11785161.html)
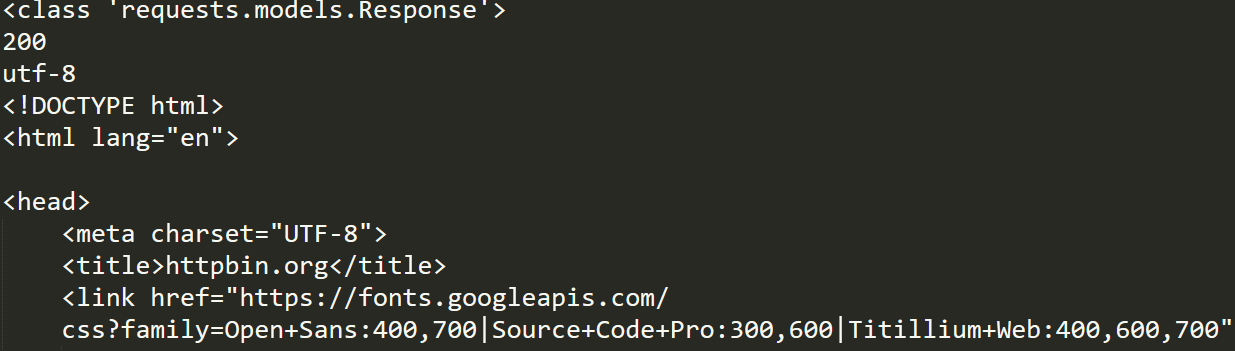
接下来,我们尝试着爬取一个网页的代码:
import requests

r=requests.get("https://httpbin.org")

print(type(r))

print(r.status_code)

print(r.encoding)

print(r.text)

print(r.cookies)
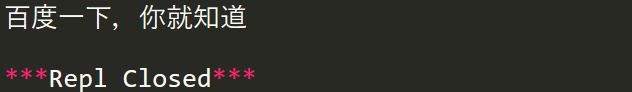
那么,当我们只想爬取网页上的某一个标签时,又该如何操作呢?
import requests

from bs4 import BeautifulSoup

r=requests.get("https://www.baidu.com")

r.encoding='utf-8'

result=r.text

# print(result)

soup=BeautifulSoup(result,'html.parser')

name=soup.find_all('head')

for i in name:

	print(i.text)
Python——初识网络爬虫(网页爬取)的更多相关文章
- Python和BeautifulSoup进行网页爬取
在大数据.人工智能时代,我们通常需要从网站中收集我们所需的数据,网络信息的爬取技术已经成为多个行业所需的技能之一.而Python则是目前数据科学项目中最常用的编程语言之一.使用Python与Beaut ...
- 【Python】【爬虫】爬取酷狗TOP500
好啦好啦,那我们来拉开我们的爬虫之旅吧~~~ 这一只小爬虫是爬取酷狗TOP500的,使用的爬取手法简单粗暴,目的是帮大家初步窥探爬虫长啥样,后期会慢慢变得健壮起来的. 环境配置 在此之前需要下载一个谷 ...
- Python网络爬虫_爬取Ajax动态加载和翻页时url不变的网页
1 . 什么是 AJAX ? AJAX = 异步 JavaScript 和 XML. AJAX 是一种用于创建快速动态网页的技术. 通过在后台与服务器进行少量数据交换,AJAX 可以使网页实现异步更新 ...
- python网络爬虫《爬取get请求的页面数据》
一.urllib库 urllib是python自带的一个用于爬虫的库,其主要作用就是可以通过代码模拟浏览器发送请求.其常被用到的子模块在python3中的为urllib.request和urllib. ...
- Python实战项目网络爬虫 之 爬取小说吧小说正文
本次实战项目适合,有一定Python语法知识的小白学员.本人也是根据一些网上的资料,自己摸索编写的内容.有不明白的童鞋,欢迎提问. 目的:爬取百度小说吧中的原创小说<猎奇师>部分小说内容 ...
- python网络爬虫--简单爬取糗事百科
刚开始学习python爬虫,写了一个简单python程序爬取糗事百科. 具体步骤是这样的:首先查看糗事百科的url:http://www.qiushibaike.com/8hr/page/2/?s=4 ...
- Python网络爬虫 | Scrapy爬取妹子图网站全站照片
根据现有的知识,写了一个下载妹子图(meizitu.com)Scrapy脚本,把全站两万多张照片下载到了本地. 网站的分析 网页的网址分析 打开网站,发现网页的网址都是以 http://www.mei ...
- python3编写网络爬虫19-app爬取
一.app爬取 前面都是介绍爬取Web网页的内容,随着移动互联网的发展,越来越多的企业并没有提供Web页面端的服务,而是直接开发了App,更多信息都是通过App展示的 App爬取相比Web端更加容易 ...
- python学习之爬虫(一) ——————爬取网易云歌词
接触python也有一段时间了,一提到python,可能大部分pythoner都会想到爬虫,没错,今天我们的话题就是爬虫!作为一个小学生,关于爬虫其实本人也只是略懂,怀着"Done is b ...
随机推荐
- PHP 类属性
属性 (Properties) 类的变量成员叫做“属性”,或者叫“字段”.“特征”,在本文档统一称为“属性”.属性声明是由关键字 public,protected或者 private 开头,然后跟一个 ...
- 字典树(查找树) leetcode 208. Implement Trie (Prefix Tree) 、211. Add and Search Word - Data structure design
字典树(查找树) 26个分支作用:检测字符串是否在这个字典里面插入.查找 字典树与哈希表的对比:时间复杂度:以字符来看:O(N).O(N) 以字符串来看:O(1).O(1)空间复杂度:字典树远远小于哈 ...
- AS的常见问题
版本问题 a.Gradle的版本 用于将代码和资源打包生成apk的编译脚本.此版本号究竟是啥得去studio的安装目录下查看b.Gradle插件的版本 com.android.tools.build: ...
- 从0开始学爬虫10之urllib和requests库与github/api的交互
urllib库的使用 # coding=utf-8 import urllib2 import urllib # htpbin模拟的环境 URL_IP="http://10.11.0.215 ...
- JQuery中formSerialize()报错:对象不支持"formSerialize"属性或方法
formSerialize()是jQuery的表单插件中提供的方法. formSerialize()的核心方法是:$.param(data); Form表单经过formSerialize(),被序列化 ...
- java-mybaits-016-mybatis知识点StatementType
1.statementType 在mapper文件中可以使用statementType标记使用什么的对象操作SQL语句. statementType:标记操作SQL的对象 要实现动态传入表名.列名,需 ...
- Zabbix 3.2.6-Mysql多实例监控-Percona Monitoring Plugins自动发现
mysql多实例监控实录 系统环境: cat /etc/redhat-release CentOS Linux release 7.3.1611 (Core) 内核版本: uname -r 3.1 ...
- 【444】Data Analysis (shp, arcpy)
ABS suburbs data of AUS 1. Dissolve Merge polygons with the same attribute of "SA2_NAME16&quo ...
- iOS App Store网址的命名规则
App Store 命名规则:https://itunes.apple.com/cn/app/ + 拼音(最多6个,全部小写,空格要-) + /id +appID 一些参考实例: http:// ...
- EasyRTMP结合海康HCNetSDK获取海康摄像机H.264实时流并转化成为RTMP直播推流(附源码)
最近一家深耕于南方电网的科技公司同事找到我们,咨询关于调用海康HCNetSDK取流,并进行互联网转化的方案,经过反复的沟通以及自身在EasyDSS和EasyNVR方面的经验,我们推荐了海康HCNetS ...