
python爬取网业信息案例
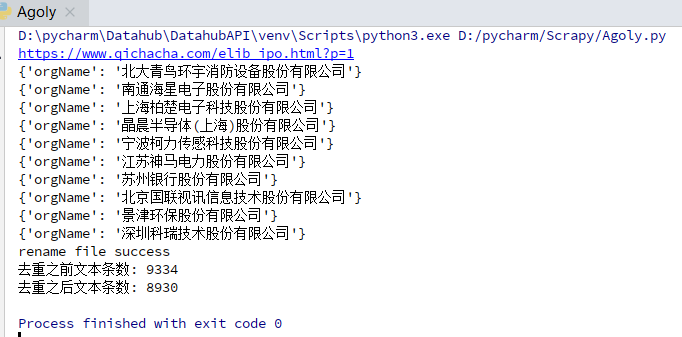
需求:爬取网站上的公司信息

代码如下:
import json

import os

import shutil

import requests

import re

import time

requests.packages.urllib3.disable_warnings()

#通过url请求接口,获取返回数据

def getPage(url,headers):

    try:

        response = requests.get(url=url, headers=headers, verify=False)

        response.encoding = 'utf-8'

        if response.status_code == 200:

            #print (response.text)

            return response.text

        else:

            print('请求异常:{} status:{}'.format(url, response.status_code))

    except Exception as e:

            print('请求异常: {} error: {}'.format(url, e))

            return None

#删除文件的重复行

def file2uniq(file,destpath):

    sum = 0

    sum_pre = 0

    addrs = set()

    with open(file, 'r',encoding='utf8') as scan_file:

        for line in scan_file.readlines():

            sum_pre += 1

            # addr = get_addr(line)

            # line.decode('utf8')

            addrs.add(line)

    scan_file.close()

    with open(destpath, 'w',encoding='utf8') as infile:

        while len(addrs) > 0:

            sum += 1

            infile.write(addrs.pop())

    infile.close()

    if (os.path.exists(file)):

        os.remove(file)

    try:

        os.rename(destpath, file)

    except Exception as e:

        print (e)

        print ('rename file fail\r')

    else:

        print ('rename file success\r')

    #print(addrs)

    print("去重之前文本条数: "+str(sum_pre))

    print("去重之后文本条数: "+str(sum))

    return sum_pre,sum

#通过正则表达式提取页面内容

def parseHtml(html):

    #pattern = re.compile(r'<tr> <td class="tx">.+\s(.+)', re.I)  # 不区分大小写 匹配股票名称

    # 不区分大小写  获取完整公司名

    pattern = re.compile(r'<td class="text-center">.+</td> <td> <a href="/firm_.+">\s(.+)', re.I)

    # 获取证券公司

    #pattern = re.compile(r'\t(.+)[\s]+</a> </td> <td class="text-center">.+</td> <td class="text-center">.+</td> </tr>', re.I)

    #pattern = re.compile(r'\t(.+)\s\t\t\t\t\t\t\t  </a> </td> <td class="text-center">.+</td> <td class="text-center">.+</td> </tr> <tr> <td class="tx">', re.I)  # 不区分大小写

    #pattern = re.compile(r'</a>\s</td>\s<td class="text-center">.+</td> <td> <a href="/firm_.+.html">\s(.+)[\s]+</a> </td> <td> <a href="/firm_.+.html">\s(.+)', re.I)  # 不区分大小写 匹配股票名称

    items = re.findall(pattern, html)

    #print (items)

    for item in items:

        yield {

            'orgName': item.strip(),

        }

def write2txt(content):

    with open(file, 'a', encoding='utf-8') as f:

        f.write(json.dumps(content, ensure_ascii=False) + '\n')

def removeStr(old_str,new_str):

    """

    with open('sanban.txt', 'a', encoding='utf-8') as fpr:

        content = fpr.read()

    content = content.replace(r'{"orgName": "', '')

    content = content.replace(r'"}', '')

    """

    file_data = ""

    with open(file, 'r', encoding='utf-8') as f:

        for line in f:

            if old_str in line:

                line = line.replace(old_str,new_str)

            file_data += line

    with open(file, 'w', encoding='utf-8') as f:

        f.write(file_data)

def main(page):

    #url = 'https://www.qichacha.com/elib_sanban.html?p=' + str(page)

    url = 'https://www.qichacha.com/elib_ipo.html?p=' + str(page)  # https://www.qichacha.com/elib_ipo.html?p=2

    headers = {

        'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/75.0.3770.100 Safari/537.36',

    }

    print (url)

    html = getPage(url,headers)

    #print (html)

    for item in parseHtml(html):

        print(item)

        write2txt(item)

    removeStr(r'{"orgName": "','')

    removeStr(r'"}', '')

    file2uniq(file, destpath)

if __name__ == '__main__':

    file = r'orgName.txt'

    #file = r'midOrg.txt'

    #sourcepath = r'sanban.txt'

    destpath = r'temp.txt'

    for page in range(1,2):

        main(page)

        time.sleep(1)
python爬取网业信息案例的更多相关文章
- Python爬取网易云音乐歌手歌曲和歌单
仅供学习参考 Python爬取网易云音乐网易云音乐歌手歌曲和歌单,并下载到本地 很多人学习python,不知道从何学起.很多人学习python,掌握了基本语法过后,不知道在哪里寻找案例上手.很多已经做 ...
- 用Python爬取网易云音乐热评
用Python爬取网易云音乐热评 本文旨在记录Python爬虫实例:网易云热评下载 由于是从零开始,本文内容借鉴于各种网络资源,如有侵权请告知作者. 要看懂本文,需要具备一点点网络相关知识.不过没有关 ...
- Python爬取网易云热歌榜所有音乐及其热评
获取特定歌曲热评: 首先,我们打开网易云网页版,击排行榜,然后点击左侧云音乐热歌榜,如图: 关于如何抓取指定的歌曲的热评,参考这篇文章,很详细,对小白很友好: 手把手教你用Python爬取网易云40万 ...
- Python 爬取网易云歌手的50首热门作品
使用 requests 爬取网易云音乐 Python 代码: import json import os import time from bs4 import BeautifulSoup impor ...
- Python爬取网易云歌单
目录 1. 关键点 2. 效果图 3. 源代码 1. 关键点 使用单线程爬取,未登录,爬取网易云歌单主要有三个关键点: url为https://music.163.com/discover/playl ...
- 爬虫实战(二) 用Python爬取网易云歌单
最近,博主喜欢上了听歌,但是又苦于找不到好音乐,于是就打算到网易云的歌单中逛逛 本着 "用技术改变生活" 的想法,于是便想着写一个爬虫爬取网易云的歌单,并按播放量自动进行排序 这篇 ...
- Python爬取拉勾网招聘信息并写入Excel
这个是我想爬取的链接:http://www.lagou.com/zhaopin/Python/?labelWords=label 页面显示如下: 在Chrome浏览器中审查元素,找到对应的链接: 然后 ...
- python爬取豆瓣视频信息代码
目录 一:代码 二:结果如下(部分例子) 这里是爬取豆瓣视频信息,用pyquery库(jquery的python库). 一:代码 from urllib.request import quote ...
- python爬取网易云音乐歌曲评论信息
网易云音乐是广大网友喜闻乐见的音乐平台,区别于别的音乐平台的最大特点,除了“它比我还懂我的音乐喜好”.“小清新的界面设计”就是它独有的评论区了——————各种故事汇,各种金句频出.我们可以透过歌曲的评 ...
随机推荐
- tp5.1 无限极分类前台展示
商城前台的多级分类展示,如图所示,一般是三级.所以代码只组装到第三级. 数据库设计,共5个字段.level字段是方便用来显示级别的.pid是父级分类id,pid等于0说明它是一级分类.path字段,举 ...
- 解决在IE11浏览器下,JQuery的AJAX方法不响应问题
在项目的时候一直都是在使用谷歌浏览器在调试,后来在现场部署到服务器上的时候,客户使用的是IE浏览器,版本是11 在测试的过程中,出现几个问题,虽然是几个问题,但是问题的原因就是AJAX第一次响应,第二 ...
- sshfs 相关材料索引
这两天简单看了 sshfs 缓存相关的内容,下面对一些好的链接进行索引,防止以后忘了: OpenSSH: Difference between internal-sftp and sftp-serve ...
- Pick of the Week'19 | Nebula 第 45 周看点--Nebula 到底是不是原生存储?
每周五 Nebula 为你播报每周看点,每周看点由本周大事件.用户问答.Nebula 产品动态和推荐阅读构成. 今天是 2019 年第 45 个工作周的周五,来和 Nebula 看看本周有什么图数据库 ...
- C# -- 使用缓冲区进行文件下载操作
C# -- 使用缓冲区进行文件下载操作 1. 为避免下载超大文件占用内存资源,文件下载使用缓冲区,一点一点读取文件资源. string str0 = @"ftp://localhost:21 ...
- NETGEAR R7800路由器TFTP刷回原厂固件方法
前几天因图新鲜将用了一年的R7800刷为dd-wrt固件,结果发现信号覆盖和网络速率相对于原厂固件还有一些差距. 然后从dd-wrt固件刷回原厂,具体操作过程如下: 1.到NETGEAR官网[支持]模 ...
- SQL实用技巧:如何判断一个值是否为数字的方法
检测是不是数字型的数据, 两种方法 1. ISNUMERIC ( expression ) 2. PATINDEX ( ‘%pattern%‘ , expression ) 1. ISNUMERIC ...
- Geodesic 什么是“测地线的”?
确定是使用上椭球体(测地线)还是平地上(平面)的最短路径.强烈建议将 Geodesic 方法用于在不适合进行距离测量的坐标系(例如 Web 墨卡托或任何地理坐标系)中存储的数据,以及任何地理区域跨度较 ...
- 我应该怎么学习SAP?
越来越多的人关注本公众号,在后台留言问我怎么进入SAP行业,应该怎么学习SAP,大部分都是外行想入行SAP的朋友.作为过来人,这些问题我也曾经问过别人,也走过不少弯路.但现在轮到别人问我了,为了让初学 ...
- 在linux环境下重启oracle数据库,解决密码过期的问题
(1) 以oracle身份登录数据库,命令:su – oracle (2) 进入Sqlplus控制台,命令:sqlplus /nolog (3) 以系统管理员登录,命令:connect /as sys ...