
关于千里马招标网知道创宇反爬虫521状态码的解决方案(python代码模拟js生成cookie _clearence值)
一、问题发现
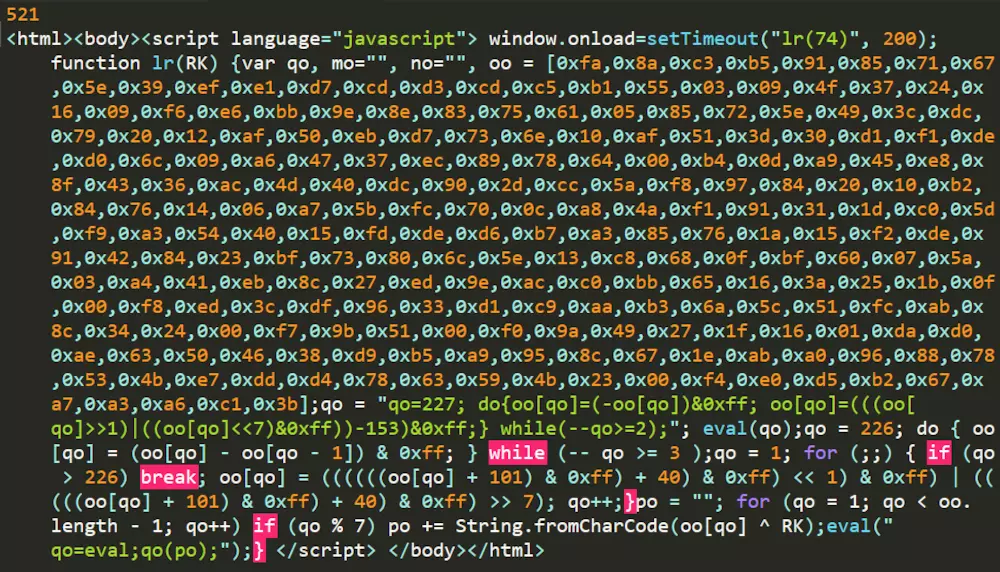
近期我在做代理池的时候,发现了一种以前没有见过的反爬虫机制。当我用常规的requests.get(url)方法对目标网页进行爬取时,其返回的状态码(status_code)为521,这是一种以前没有见过的状态码。再输出它的爬取内容(text),发现是一些js代码。看来是新问题,我们来探索一下。
二、原理分析
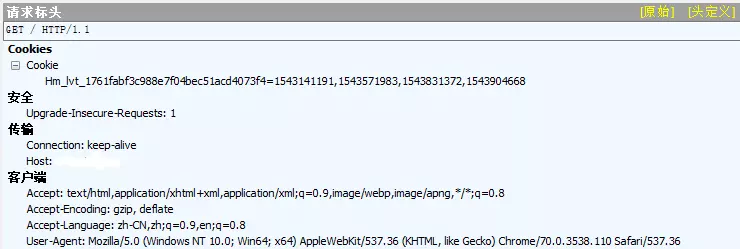
打开Fiddler,抓取访问网站的包,我们发现浏览器对于同一网页连续访问了两次,第一次的访问状态码为521,第二次为200(正常访问)。看来网页加了反爬虫机制,需要两次访问才可返回正常网页。

下面我们来对比两次请求的区别:
521请求:
200请求:
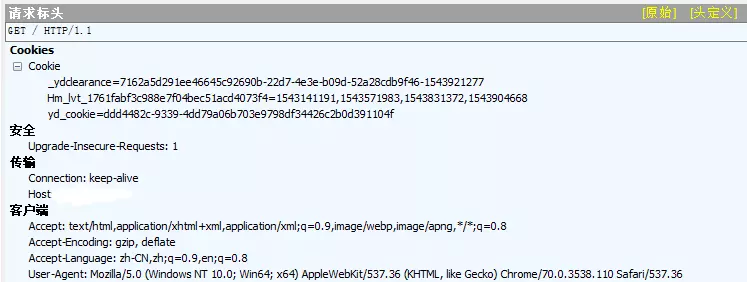
通过对比两次请求头,我们发现第二次访问带了新的cookie值。再考虑上面程序对爬取结果的输出为js代码,可以考虑其操作过程为:第一次访问时服务器返回一段可动态生成cookie值的js代码;浏览器运行js代码生成cookie值,并带cookie重新进行访问;服务器被正常访问,返回页面信息,浏览器渲染加载。
三、解决流程
弄清楚浏览器的执行过程后,我们就可以模拟其行为通过python作网页爬取。操作步骤如下:
用request.get(url)获取js代码
通过正则表达式对代码进行解析,获得JS函数名,JS函数参数和JS函数主体,并将执行函数eval()语句修改为return语句返回cookie值
调用execjs库的executeJS()功能执行js代码获得cookie值
将cookie值转化为字典格式,用request.get(url, cookies = cookie)方法获取得到正确的网页信息
四、代码实现
实现程序所需要用到的库:
import re                  #实现正则表达式

import execjs              #执行js代码

import requests            #爬取网页
第一次爬取获得包含js函数的页面信息后,通过正则表达式对代码进行解析,获得JS函数名,JS函数参数和JS函数主体,并将执行函数eval()语句修改为return语句返回cookie值。
# js_html为获得的包含js函数的页面信息
# 提取js函数名
js_func_name = ''.join(re.findall(r'setTimeout\(\"(\D+)\(\d+\)\"', js_html))
# 提取js函数参数
js_func_param = ''.join(re.findall(r'setTimeout\(\"\D+\((\d+)\)\"', js_html))
# 提取js函数主体
js_func = ''.join(re.findall(r'(function .*?)</script>', js_html))
将执行函数eval()语句修改为return语句返回cookie值
# 修改js函数,返回cookie值

js_func = js_func.replace('eval("qo=eval;qo(po);")', 'return po')
调用execjs库的executeJS()功能执行js代码获得cookie值
# 执行js代码的函数,参数为js函数主体,js函数名和js函数参数

def executeJS(js_func, js_func_name, js_func_param):

 jscontext = execjs.compile(js_func)    # 调用execjs.compile()加载js函数主体内容

 func = jscontext.call(js_func_name,js_func_param)  # 使用call()通过函数名和参数执行该函数

 return func

cookie_str = executeJS(js_func, js_func_name, js_func_param)
将cookie值转化为字典格式
# 将cookie值解析为字典格式,方便后面调用

def parseCookie(string):

 string = string.replace("document.cookie='", "")

 clearance = string.split(';')[0]

 return {clearance.split('=')[0]: clearance.split('=')[1]}

cookie = parseCookie(cookie_str)
获得cookie后,采用带cookie的方式重新进行爬取,即可获得我们需要的网页信息了。
作者:欲摘桃花换酒钱
链接:https://www.jianshu.com/p/37d549a4bf44
来源:简书
关于千里马招标网知道创宇反爬虫521状态码的解决方案(python代码模拟js生成cookie _clearence值)的更多相关文章
- python爬虫遇到状态码304,705
304状态码是什么? 如果客户端发送了一个带条件的GET 请求且该请求已被允许,而文档的内容(自上次访问以来或者根据请求的条件)并没有改变,则服务器应当返回这个304状态码.简单的表达就是:客户端已经 ...
- python爬虫22 | 以后我再讲python「模拟登录」我就是狗
接下来就是 学习python的正确姿势 做爬虫 绕不开模拟登录 为此小帅b给大家支了几招 python爬虫19 | 遇到需要的登录的网站怎么办?用这3招轻松搞定! 有些网站的登录很弱鸡 传个用户名和密 ...
- [Python爬虫]煎蛋网OOXX妹子图爬虫(1)——解密图片地址
之前在鱼C论坛的时候,看到很多人都在用Python写爬虫爬煎蛋网的妹子图,当时我也写过,爬了很多的妹子图片.后来煎蛋网把妹子图的网页改进了,对图片的地址进行了加密,所以论坛里面的人经常有人问怎么请求的 ...
- 配置Nutch模拟浏览器以绕过反爬虫限制
原文链接:http://yangshangchuan.iteye.com/blog/2030741 当我们配置Nutch抓取 http://yangshangchuan.iteye.com 的时候,抓 ...
- Python 爬虫工程师必看,深入解读字体反爬虫
字体反爬虫开篇概述 很多人学习python,不知道从何学起.很多人学习python,掌握了基本语法过后,不知道在哪里寻找案例上手.很多已经做案例的人,却不知道如何去学习更加高深的知识.那么针对这三类人 ...
- seebug的反爬虫技术初探
1.通过request库无法直接爬取,返回521 >>> import requests >>> req = requests.get('https://www.s ...
- 爬虫实例——爬取煎蛋网OOXX频道(反反爬虫——伪装成浏览器)
煎蛋网在反爬虫方面做了不少工作,无法通过正常的方式爬取,比如用下面这段代码爬取无法得到我们想要的源代码. import requests url = 'http://jandan.net/ooxx' ...
- 反反爬虫 IP代理
0x01 前言 一般而言,抓取稍微正规一点的网站,都会有反爬虫的制约.反爬虫主要有以下几种方式: 通过UA判断.这是最低级的判断,一般反爬虫不会用这个做唯一判断,因为反反爬虫非常容易,直接随机UA即可 ...
- 【Python3爬虫】常见反爬虫措施及解决办法(三)
上一篇博客的末尾说到全网代理IP的端口号是经过加密混淆的,而这一篇博客就将告诉你如何破解!如果觉得有用的话,不妨点个推荐哦~ 一.全网代理IP的JS混淆 首先进入全网代理IP,打开开发者工具,点击查看 ...
随机推荐
- [Algorithm] 46. Permutations
Given a collection of distinct integers, return all possible permutations. Example: Input: [1,2,3] O ...
- linux学习9 运维基本功-Linux常用基础命令实战应用
一.文件系统知识回顾 1.Linux文件系统: a.文件名称严格区分字符大小写 b.文件可以使用除/以外任意字符 c.文件名长度不能超过255个字符 d.以.开头的文件为隐藏文件: . :当前目录 . ...
- BZOJ 4459: [Jsoi2013]丢番图 数学推导
之前绝对做过几乎一模一样的题,现在做竟然忘了. code: #include <bits/stdc++.h> #define ll long long #define setIO(s) f ...
- centos 部署的时候安装不上Mariadb,缺少依赖文件
并不存在这个sock文件 使用systemctl status mariadb.service 查看报错信息 提示libsystemd.so.0文件不存在, 安装systemd-libs包,解决问题, ...
- How to Construct the Input Bet String
The purpose of this section is to describe the format of the string which will submitted to the Pyth ...
- 统计学基础知识(一)---描述统计学(Descriptive Statistics)
描述统计学(Descriptive Statistics):将数据的信息以表格, 图形或数值的形式进行汇总. 数据类型:分为定量数据(数值型数据)和定性数据(类别型数据).数值型数据又可以分为连续型和 ...
- webgestalt 通路富集分析
http://www.webgestalt.org/ 通路富集分析 参考 http://www.sci666.com.cn/9596.html
- Zabbix实战-简易教程--中间件RabbitMQ监控
一.环境 zabbix版本:3.0 二.脚本说明 .├── rabbitmq.template.xml 模板文件├── scripts │ └── rabbitmq│ ├── api.p ...
- [Gamma阶段]第五次Scrum Meeting
Scrum Meeting博客目录 [Gamma阶段]第五次Scrum Meeting 基本信息 名称 时间 地点 时长 第五次Scrum Meeting 19/05/31 大运村寝室6楼 30min ...
- 对IT战略的认识
提到战略,我不由想起了战术这个名词.按照我的理解,战术属于短期内的计划,是战略的组成部分,是实施次战略的短期工作计划或行动步骤:而战略是用来帮助我们赢取目标的行动计划(例如为获得更多的潜在客户而制定的 ...