
爬虫实例——爬取煎蛋网OOXX频道(反反爬虫——伪装成浏览器)
煎蛋网在反爬虫方面做了不少工作,无法通过正常的方式爬取,比如用下面这段代码爬取无法得到我们想要的源代码。
import requests

url = 'http://jandan.net/ooxx'

print requests.get(url).text
执行上述代码,你得到的结果应该跟我一样:
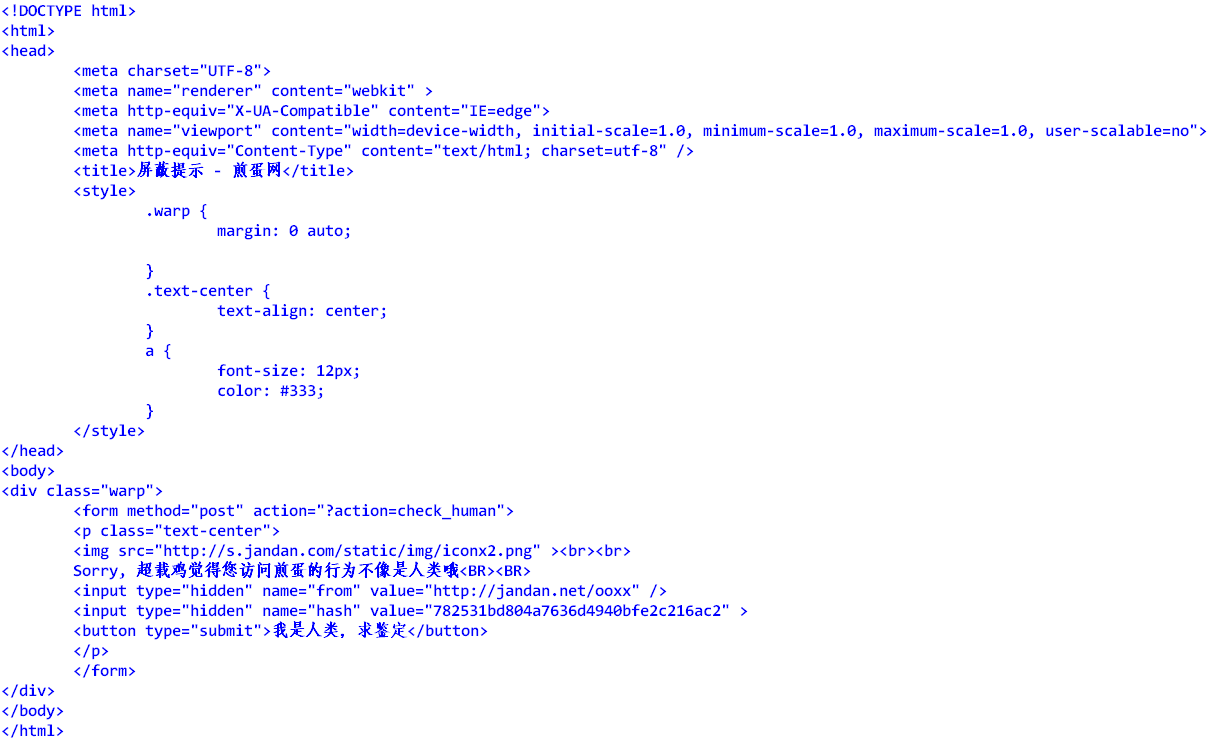
煎蛋网应该是通过检测headers来判断是否爬虫,要想获取正常的源代码,需要伪装成浏览器。
# -*- coding: utf-8 -*-

import re

import requests

from bs4 import BeautifulSoup

import sys

reload(sys)

sys.setdefaultencoding('utf8')

def get_bs(url):

    headers = {'User-Agent': 'Mozilla/5.0 (Windows NT 5.1) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/48.0.2564.82 Safari/537.36'}

    text = requests.post(url, headers=headers).text

    return BeautifulSoup(text)

def download(url):

    fn = re.search(r'.*/(.*)', url).group(1)

    content = requests.get(url).content

    with open(fn, 'wb') as f:

        f.write(content)

if __name__ == '__main__':

    url = 'http://jandan.net/ooxx'

    bs = get_bs(url)

    for code in bs('li', id=re.compile(r'comment-\d+')):

        url = code.find('img')['src']

        download(url)
当然,这个爬虫脚本也不是永久有效,说不定哪天煎蛋就出新招了,所以只能见招拆招。
爬虫实例——爬取煎蛋网OOXX频道(反反爬虫——伪装成浏览器)的更多相关文章
- Python Scrapy 爬取煎蛋网妹子图实例(一)
前面介绍了爬虫框架的一个实例,那个比较简单,这里在介绍一个实例 爬取 煎蛋网 妹子图,遗憾的是 上周煎蛋网还有妹子图了,但是这周妹子图变成了 随手拍, 不过没关系,我们爬图的目的是为了加强实战应用,管 ...
- selenium爬取煎蛋网
selenium爬取煎蛋网 直接上代码 from selenium import webdriver from selenium.webdriver.support.ui import WebDriv ...
- python3爬虫爬取煎蛋网妹纸图片(上篇)
其实之前实现过这个功能,是使用selenium模拟浏览器页面点击来完成的,但是效率实际上相对来说较低.本次以解密参数来完成爬取的过程. 首先打开煎蛋网http://jandan.net/ooxx,查看 ...
- Python 爬虫 爬取 煎蛋网 图片
今天, 试着爬取了煎蛋网的图片. 用到的包: urllib.request os 分别使用几个函数,来控制下载的图片的页数,获取图片的网页,获取网页页数以及保存图片到本地.过程简单清晰明了 直接上源代 ...
- python爬虫–爬取煎蛋网妹子图片
前几天刚学了python网络编程,书里没什么实践项目,只好到网上找点东西做. 一直对爬虫很好奇,所以不妨从爬虫先入手吧. Python版本:3.6 这是我看的教程:Python - Jack -Cui ...
- scrapy从安装到爬取煎蛋网图片
下载地址:https://www.lfd.uci.edu/~gohlke/pythonlibs/pip install wheelpip install lxmlpip install pyopens ...
- Python 爬取煎蛋网妹子图片
#!/usr/bin/env python # -*- coding: utf-8 -*- # @Date : 2017-08-24 10:17:28 # @Author : EnderZhou (z ...
- python3爬虫爬取煎蛋网妹纸图片(下篇)2018.6.25有效
分析完了真实图片链接地址,下面要做的就是写代码去实现了.想直接看源代码的可以点击这里 大致思路是:获取一个页面的的html---->使用正则表达式提取出图片hash值并进行base64解码--- ...
- Python Scrapy 爬取煎蛋网妹子图实例(二)
上篇已经介绍了 图片的爬取,后来觉得不太好,每次爬取的图片 都在一个文件下,不方便区分,且数据库中没有爬取的时间标识,不方便后续查看 数据时何时爬取的,所以这里进行了局部修改 修改一:修改爬虫执行方式 ...
随机推荐
- 【hidden】微信小程序hidden属性使用示例
hidden属性用于隐藏标签,代码示例: <view hidden="{{!statusTag}}">我出来了~</view> <button bin ...
- GET请求的写法-jmeter
第一种写法:可以向post 请求一样写 第二种写法: /pinter/com/getSku?id=${__Random(1,100,rdmNum)}
- git branch 分支与合并
在使用 git 进行分支开发与合并的时候需要用到这些命令.其他基本 git 命令参考 Git 简易食用指南 git branch 查看分支 git branch 查看当前分支情况 创建分支 git b ...
- 【转载】2015Android 面试题 01
1.如何避免ANR? 答:ANR:Application Not Responding,五秒在Android中,活动管理器和窗口管理器这两个系统服务负责监视应用程序的响应. 当出现下列情况时,Andr ...
- 索引值迭代-enumerate
你想在迭代一个序列的同时跟踪正在被处理的元素索引?内置的enumerate() 函数可以很好的解决这个问题: list_c = ['a', 'b', 'c'] for i, c in enumerat ...
- java日期格式处理
继承关系:java.lang.Object->java.text.Format->java.text.DateForm->java.text.SimpleDateFormat 日期代 ...
- lintcode-184-最大数
184-最大数 给出一组非负整数,重新排列他们的顺序把他们组成一个最大的整数. 注意事项 最后的结果可能很大,所以我们返回一个字符串来代替这个整数. #### 样例 给出 [1, 20, 23, 4, ...
- Scala快速入门-基本数据结构
模式匹配 使用用模式匹配实现斐波那契 def fibonacci(in: Any): Int = in match { case 0 => 0 case 1 => 1 case n: In ...
- vs code 自动补全效果不理想的问题
之前一直用webstorm,最近换换口味,改用了VS Code,发现VS Code 智能提示得到的都不是我想要的 就比如 ! + tab ,HTML结构都出不来.经过一番搜索,发现是 VS Code ...
- 【bzoj4736/uoj#274】[清华集训2016]温暖会指引我们前行 语文题+LCT
题目描述 http://uoj.ac/problem/274 题解 语文题+LCT 对于这种语文题建议还是自己读题好一些... 读懂题后发现:由于温度互不相同,最大生成树上的路径必须走(不走的话温度大 ...