
storm并行
Storm并行度
public class WordCountTopology {

    private static final String SENTENCE_SPOUT_ID = "sentence-spout";

    private static final String SPLIT_BOLT_ID = "split-bolt";

    private static final String COUNT_BOLT_ID = "count-bolt";

    private static final String REPORT_BOLT_ID = "report-bolt";

    private static final String TOPOLOGY_NAME = "word-count-topology";

    public static void main(String[] args) throws

            Exception {

        SentenceSpout spout = new SentenceSpout();

        SplitSentenceBolt splitBolt = new

                SplitSentenceBolt();

        WordCountBolt countBolt = new WordCountBolt();

        ReportBolt reportBolt = new ReportBolt();

        TopologyBuilder builder = new TopologyBuilder();

        builder.setSpout(SENTENCE_SPOUT_ID, spout);

        // SentenceSpout --> SplitSentenceBolt

        builder.setBolt(SPLIT_BOLT_ID, splitBolt).shuffleGrouping(SENTENCE_SPOUT_ID);

        // SplitSentenceBolt --> WordCountBolt

        builder.setBolt(COUNT_BOLT_ID, countBolt).fieldsGrouping(

                SPLIT_BOLT_ID, new Fields("word"));

        // WordCountBolt --> ReportBolt

        builder.setBolt(REPORT_BOLT_ID, reportBolt).globalGrouping(COUNT_BOLT_ID);

        Config config = new Config();

        LocalCluster cluster = new LocalCluster();

        cluster.submitTopology(TOPOLOGY_NAME, config,

                builder.createTopology());

        Utils.sleep(10000);

        cluster.killTopology(TOPOLOGY_NAME);

        cluster.shutdown();

    }

}
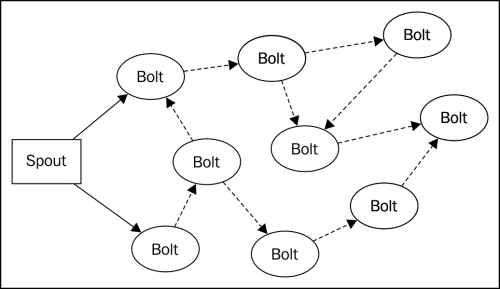
流程:(包括一个spout和三个bolt)
sentence-spout  生成句子

split-bolt      切分句子传入单词

count-bolt     单词统计

report-bolt     结果输出
1、WordCountTopology并行性

2、在拓扑中增加worker
Config config = new Config();

config.setNumWorkers(2);
3、配置executor数和task数
builder.setSpout(SENTENCE_SPOUT_ID, spout, 2);

builder.setBolt(SPLIT_BOLT_ID, splitBolt, 2).setNumTasks(4)

    .shuffleGrouping(SENTENCE_SPOUT_ID);

builder.setBolt(COUNT_BOLT_ID, countBolt, 4)

    .fieldsGrouping(SPLIT_BOLT_ID, newFields("word"));

--- FINAL COUNTS ---

a : 2726

ate : 2722

beverages : 2723

cold : 2723

cow : 2726

dog : 5445

don't : 5444

fleas : 5451

has : 2723

have : 2722

homework : 2722

i : 8175

like : 5449

man : 2722

my : 5445

the : 2727

think : 2722

--------------
原来的结果:
--- FINAL COUNTS ---

a : 1426

ate : 1426

beverages : 1426

cold : 1426

cow : 1426

dog : 2852

don't : 2851

fleas : 2851

has : 1426

have : 1426

homework : 1426

i : 4276

like : 2851

man : 1426

my : 2852

the : 1426

think : 1425

--------------
Storm流分组
public interface CustomStreamGrouping extends Serializable {

    void prepare(WorkerTopologyContext context, GlobalStreamId stream, List<Integer> targetTasks);

    List<Integer> chooseTasks(int taskId, List<Object> values);

}
public void nextTuple() {

    if(index < sentences.length){

        this.collector.emit(new Values(sentences[index]));

        index++;

    }

    Utils.waitForMillis(1);

}
--- FINAL COUNTS ---

a : 2

ate : 2

beverages : 2

cold : 2

cow : 2

dog : 4

don't : 4

fleas : 4

has : 2

have : 2

homework : 2

i : 6

like : 4

man : 2

my : 4

the : 2

think : 2

--------------
原来:
builder.setBolt(COUNT_BOLT_ID, countBolt, 4)

    .fieldsGrouping(SPLIT_BOLT_ID, newFields("word"))
改成:
builder.setBolt(COUNT_BOLT_ID, countBolt, 4)

    .shuffleGrouping(SPLIT_BOLT_ID);
--- FINAL COUNTS ---

a : 1

ate : 2

beverages : 1

cold : 1

cow : 1

dog : 2

don't : 2

fleas : 1

has : 1

have : 1

homework : 1

i : 3

like : 1

man : 1

my : 1

the : 1

think : 1

--------------
我们计算不正确了,因为CountBolt参数是有状态:它保留一个计数为每个收到的单词的。在这种情况下,我们计算的准确性取决于当组件被并行化基于元组的内容分组的能力。引入的错误我们将只显示如果CountBolt参数大于1的并行性。这强调了测试拓扑与各种并行配置的重要性。
1、Tip
2、消息处理保证
3、Spout的可靠性
public interface ISpout extends Serializable {

    void open(Map conf, TopologyContext context, SpoutOutputCollector collector);

    void close();

    void nextTuple();

    void ack(Object msgId);

    void fail(Object msgId);

}
collector.emit(new Values("value1", "value2") ,msgId);
4、bolt可靠性
collector.emit(tuple, new Values(word));
collector.emit(new Values(word));
this.collector.ack(tuple);
this.collector.fail(tuple)
5、可靠的word count(修改后的程序)
public class SentenceSpout extends BaseRichSpout {

    private ConcurrentHashMap<UUID, Values> pending;

    private SpoutOutputCollector collector;

    private String[] sentences = {

            "my dog has fleas",

            "i like cold beverages",

            "the dog ate my homework",

            "don't have a cow man",

            "i don't think i like fleas"

    };

    private int index = 0;

    public void declareOutputFields(OutputFieldsDeclarer declarer) {

        declarer.declare(new Fields("sentence"));

    }

    public void open(Map config, TopologyContext context,

                     SpoutOutputCollector collector) {

        this.collector = collector;

        this.pending = new ConcurrentHashMap<UUID, Values>();

    }

    public void nextTuple() {

        Values values = new Values(sentences[index]);

        UUID msgId = UUID.randomUUID();

        this.pending.put(msgId, values);

        this.collector.emit(values, msgId);

        index++;

        if (index >= sentences.length) {

            index = 0;

        }

        Utils.sleep(1);

    }

    public void ack(Object msgId) {

        this.pending.remove(msgId);

    }

public void fail(Object msgId) {

        this.collector.emit(this.pending.get(msgId), msgId);

    }

}
public class ReliableSplitSentenceBolt extends BaseRichBolt {

    private OutputCollector collector;

    public void prepare(Map config, TopologyContext

            context, OutputCollector collector) {

        this.collector = collector;

    }

    public void execute(Tuple tuple) {

        String sentence = tuple.getStringByField("sentence");

        String[] words = sentence.split(" ");

        for(String word : words){

            this.collector.emit(tuple, new Values(word));

        }

        this.collector.ack(tuple);

    }

    public void declareOutputFields(OutputFieldsDeclarer declarer) {

        declarer.declare(new Fields("word"));

    }

}
storm并行的更多相关文章
- storm的并发
1 storm并行的基本概念 storm集群中的一个机器可以运行一个或者多个worker,对应于一个或者多个topologies. 1个worker进程运行1个或多个excutor线程.每个worke ...
- 【Storm篇】--Storm并发机制
一.前述 为了提高Storm的并行能力,通常需要设置并行. 二.具体原理 1. Storm并行分为几个方面: Worker – 进程一个Topology拓扑会包含一个或多个Worker(每个Worke ...
- 【原】理解Storm拓扑的并行
Storm入门教程 1. Storm基础 Storm Storm主要特点 Storm基本概念 Storm调度器 Storm配置 Guaranteeing Message Processing(消息处理 ...
- Storm集群中执行的各种组件及其并行
一.Storm中执行的组件 我们知道,Storm的强大之处就是能够非常easy地在集群中横向拓展它的计算能力,它会把整个运算过程切割成多个独立的tasks在集群中进行并行计算.在Storm中 ...
- 大数据处理框架之Strom: Storm拓扑的并行机制和通信机制
一.并行机制 Storm的并行度 ,通过提高并行度可以提高storm程序的计算能力. 1.组件关系:Supervisor node物理节点,可以运行1到多个worker,不能超过supervisor. ...
- Storm介绍(一)
作者:Jack47 PS:如果喜欢我写的文章,欢迎关注我的微信公众账号程序员杰克,两边的文章会同步,也可以添加我的RSS订阅源. 内容简介 本文是Storm系列之一,介绍了Storm的起源,Storm ...
- Storm构建分布式实时处理应用初探
最近利用闲暇时间,又重新研读了一下Storm.认真对比了一下Hadoop,前者更擅长的是,实时流式数据处理,后者更擅长的是基于HDFS,通过MapReduce方式的离线数据分析计算.对于Hadoop, ...
- Storm介绍及与Spark Streaming对比
Storm介绍 Storm是由Twitter开源的分布式.高容错的实时处理系统,它的出现令持续不断的流计算变得容易,弥补了Hadoop批处理所不能满足的实时要求.Storm常用于在实时分析.在线机器学 ...
- storm 入门原理介绍
1.hadoop有master与slave,Storm与之对应的节点是什么? 2.Storm控制节点上面运行一个后台程序被称之为什么? 3.Supervisor的作用是什么? 4.Topology与W ...
随机推荐
- JavaScript中数组相关的属性方法
下面的这些方法会改变调用它们的对象自身的值: Array.prototype.copyWithin() 在数组内部,将一段元素序列拷贝到另一段元素序列上,覆盖原有的值. Array.prototype ...
- 如何提高你的移动开发中AS3/AIR性能
Shawn Blais 让我了解到如何在移动平台上对AS3代码进行优化.他的博客(http://esdot.ca/site/category/blog)只有十来篇文章,但都是些很意思的信息,尤其适合我 ...
- APS中生产计划排程模块的基本原理
高级计划系统(APS)作为ERP和MES的补充,用于协调物流.开发瓶颈资源和保证交货日期. APS包括需求和供应计划.运输和生产计划排程等各种供应链计划模块,本文主要介绍APS中生产计划排程模块的基本 ...
- Qemu-4.1 桥接网络设置
参考: [qemu] qemu旧的net参数已经不再可用了,新的这样用. QEMU's new -nic command line option 用Qemu模拟vexpress-a9 --- 配置 q ...
- 大数据技术原理与应用【第五讲】NoSQL数据库:5.4 NoSQL的三大基石
NoSQL的三大基石:cap,Base,最终一致性 5.4.1 cap理论(帽子理论): consistency:一致性availability:可用性partition tolerance: ...
- NLP中的预训练语言模型(一)—— ERNIE们和BERT-wwm
随着bert在NLP各种任务上取得骄人的战绩,预训练模型在这不到一年的时间内得到了很大的发展,本系列的文章主要是简单回顾下在bert之后有哪些比较有名的预训练模型,这一期先介绍几个国内开源的预训练模型 ...
- andrlid 处理大图片思路,未实践
Loading Large Bitmaps Efficiently 先不解码,读取image的宽高,然后降采样显示图片. 参考:http://developer.android.com/trainin ...
- 性能测试:TPS和QPS的区别
做测试,各种ps,jps,tps,qps,rps,hps,你理解几个? 技术群里,问得最多的就是tps和qps,有相似的地方,也有差异的地方,我简单谈下自己的理解.(由于比较忙,下面部分摘抄自网络) ...
- python windows下获取路径时有中文处理
在windows中用os,path.abspath(__file__)时有中文路径时,默认是转成非unicode格式 这会导致,在其它模块使用该路径时,会报 utf8' codec can't dec ...
- Django 购物车模板
url from django.contrib import admin from django.urls import path, re_path from django.urls import i ...