
大数据处理框架之Strom: Storm拓扑的并行机制和通信机制
一、并行机制
Storm的并行度 ,通过提高并行度可以提高storm程序的计算能力。
1.组件关系:
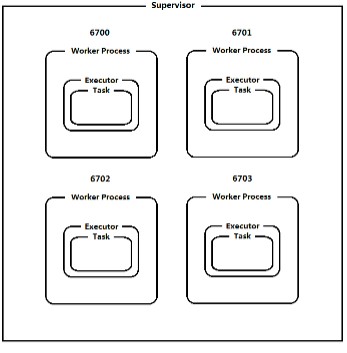
Supervisor node物理节点,可以运行1到多个worker,不能超过supervisor.slots.ports数量;
worker:工作进程,即jvm.为特定拓扑的一个或者多个组件Spout/Bolt产生一个或者多个Executor。默认情况下一个Worker运行一个Executor
Executor:线程Thread,为特定拓扑的一个或者多个组件Spout/Bolt实例运行一个或者多个Task。默认情况下一个Executor运行一个Task。
Task:任务
2.代码配置并行度
//工作进程Worker数量

Config config = new Config();

config.setNumWorkers(3);    //注意此参数不能大于supervisor.slots.ports数量。

//执行器Executor数量 线程数量

TopologyBuilder builder = new TopologyBuilder();

builder.setSpout(id, spout, parallelism_hint);        //设置Spout的Executor数量参数parallelism_hint

builder.setBolt(id, bolt, parallelism_hint);        //设置Bolt的Executor数量参数parallelism_hint

//任务Task数量  指定任务数 会平均分配到执行器里

TopologyBuilder builder = new TopologyBuilder();

builder.setSpout(id, spout, parallelism_hint).setNumTasks(val);      //设置Spout的Executor数量参数parallelism_hint,Task数量参数val

builder.setBolt(id, bolt, parallelism_hint).setNumTasks(val);            //设置Bolt的Executor数量参数parallelism_hint,Task数量参数val
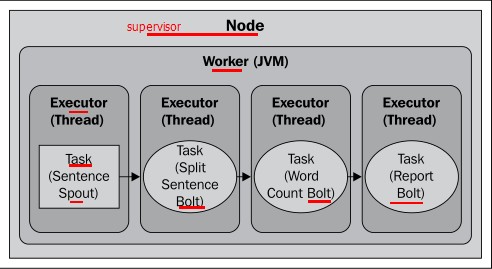
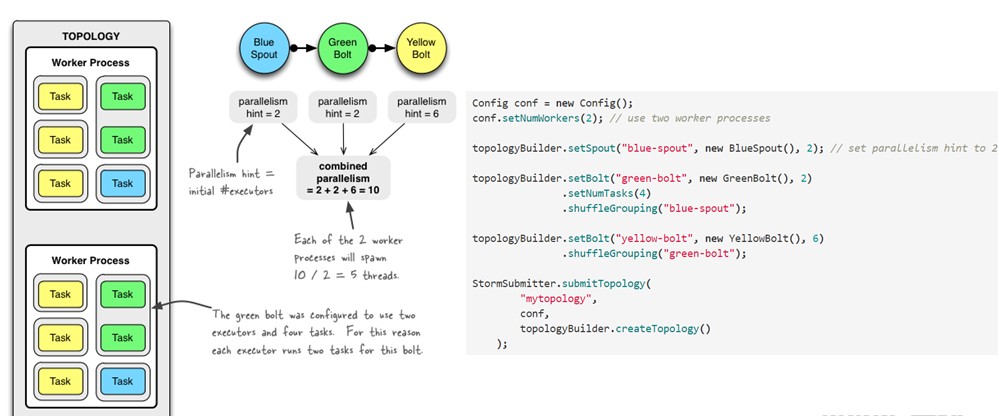
图解并行度:
2.1 默认1个worker,1个Executor,1个task
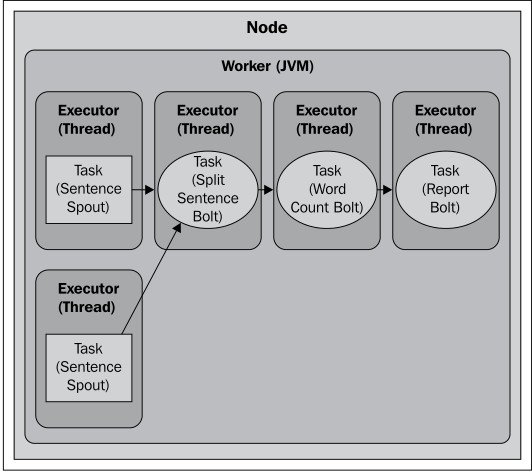
2.2 spout 设置并行度2
builder.setSpout(SENTENCE_SPOUT_ID, spout, 2);
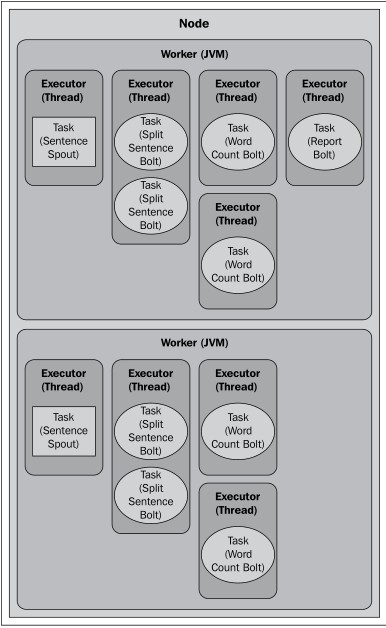
2.3 设置多worker 多并行度,多任务
#设置两个worker
Config config = new Config();
config.setNumWorkers(2);
#splitBolt并行度2,任务数4
builder.setBolt(SPLIT_BOLT_ID, splitBolt, 2).setNumTasks(4).shuffleGrouping(SENTENCE_SPOUT_ID);
#splitBolt并行度4
builder.setBolt(COUNT_BOLT_ID, countBolt, 4).fieldsGrouping(SPLIT_BOLT_ID, newFields("word"));
3.并行度再平衡
使用storm命令或者storm UI 操作
# 重新配置拓扑

# -w  设置10秒超时时间

# -n “myTopology” 拓扑使用5个Worker进程

# -e “blue-spout” Spout使用3个Executor

# -e “yellow-blot” Bolt使用10个Executor

storm rebalance myTopology -w 10 -n  -e blue-spout= -e yellow-blot=
附示例:
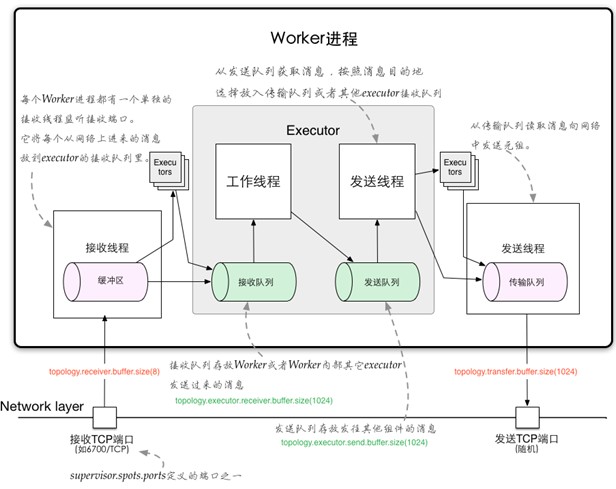
二、通信机制:
1、Worker进程间的数据通信
ZMQ
ZeroMQ 开源的消息传递框架,并不是一个MessageQueue
Netty
Netty是基于NIO的网络框架,更加高效。(之所以Storm 0.9版本之后使用Netty,是因为ZMQ的license和Storm的license不兼容。)
2、Worker内部的数据通信
Disruptor
实现了“队列”的功能。
可以理解为一种事件监听或者消息处理机制,即在队列当中一边由生产者放入消息数据,另一边消费者并行取出消息数据处理。
参考:
Storm拓扑的并行度(parallelism)
大数据处理框架之Strom: Storm拓扑的并行机制和通信机制的更多相关文章
- 大数据处理框架之Strom:Storm集群环境搭建
搭建环境 Red Hat Enterprise Linux Server release 7.3 (Maipo) zookeeper-3.4.11 jdk1.7.0_80 Pyth ...
- 大数据处理框架之Strom: Storm----helloword
大数据处理框架之Strom: Storm----helloword Storm按照设计好的拓扑流程运转,所以写代码之前要先设计好拓扑图.这里写一个简单的拓扑: 第一步:创建一个拓扑类含有main方法的 ...
- 大数据处理框架之Strom:认识storm
Storm是分布式实时计算系统,用于数据的实时分析.持续计算,分布式RPC等. (备注:5种常见的大数据处理框架:· 仅批处理框架:Apache Hadoop:· 仅流处理框架:Apache Stor ...
- 大数据处理框架之Strom:Flume+Kafka+Storm整合
环境 虚拟机:VMware 10 Linux版本:CentOS-6.5-x86_64 客户端:Xshell4 FTP:Xftp4 jdk1.8 storm-0.9 apache-flume-1.6.0 ...
- 大数据处理框架之Strom:redis storm 整合
storm 引入redis ,主要是使用redis缓存库暂存storm的计算结果,然后redis供其他应用调用取出数据. 新建maven工程 pom.xml <project xmlns=&qu ...
- 大数据处理框架之Strom:kafka storm 整合
storm 使用kafka做数据源,还可以使用文件.redis.jdbc.hive.HDFS.hbase.netty做数据源. 新建一个maven 工程: pom.xml <project xm ...
- 大数据处理框架之Strom:DRPC
环境 虚拟机:VMware 10 Linux版本:CentOS-6.5-x86_64 客户端:Xshell4 FTP:Xftp4 jdk1.8 storm-0.9 一.DRPC DRPC:Distri ...
- 大数据处理框架之Strom:容错机制
1.集群节点宕机Nimbus服务器 单点故障,大部分时间是闲置的,在supervisor挂掉时会影响,所以宕机影响不大,重启即可非Nimbus服务器 故障时,该节点上所有Task任务都会超时,Nimb ...
- 大数据处理框架之Strom:事务
环境 虚拟机:VMware 10 Linux版本:CentOS-6.5-x86_64 客户端:Xshell4 FTP:Xftp4 jdk1.8 storm-0.9 apache-flume-1.6.0 ...
随机推荐
- 【PyQt5-Qt Designer】界面布局
PyQt5 界面布局详谈 箱式布局 QHBoxLayout和QVBoxLayout是基本的布局类,它们在水平和垂直方向上排列小部件 效果图: from PyQt5.QtCore import Qt f ...
- 原生js获取子元素、给元素增加div
//鼠标移入移出动画 解决页面闪屏问题 window.onload = function () { var el = document.createElement('div'); el.classNa ...
- (3.16)mysql基础深入——mysql字符集
(3.16)mysql基础深入——mysql字符集 关键字:mysql字符集,mysql编码 目录 1.概念 2.常用的字符编码 3.查看mysql字符集 [3.1]查看服务器支持的字符集 [3.2] ...
- redis缓存和mysql数据库同步
附redis关于缓存雪崩和缓存穿透,热点key 穿透 穿透:频繁查询一个不存在的数据,由于缓存不命中,每次都要查询持久层.从而失去缓存的意义. 解决办法: 持久层查询不到就缓存空结果,查询时先判断缓存 ...
- host文件
# Copyright (c) 1993-2009 Microsoft Corp. # # This is a sample HOSTS file used by Microsoft TCP/IP f ...
- 右键菜单添加git选项
1.jpg 2.jpg 3.jpg 4.jpg 5.jpg 6.jpg 7.jpg
- javascript篇-console.log()打印object却显示为字符串[object object]
console.log打印对象遇到的一个问题,如下截图 打印结果与预期不符,原因是因为字符串‘a’和对象object拼接在一起,拼成了一个字符串
- html与js和php之间实现数据交互
<div class="top3"> <input id="KeyWord" type="text" class=&quo ...
- bcolz的新操作
1.直接修改 eg:把data.bcolz文件中A列为0的数据填充为1000. data = bcolz.open("data.bcolz", "a") #以& ...
- git flow常用命令
https://danielkummer.github.io/git-flow-cheatsheet/index.zh_CN.html https://blog.csdn.net/shu580231/ ...