
Machine Learning for hackers读书笔记(二)数据分析
#均值:总和/长度
mean()
#中位数:将数列排序,若个数为奇数,取排好序数列中间的值.若个数为偶数,取排好序数列中间两个数的平均值
median()
#R语言中没有众数函数
#分位数
quantile(data):列出0%,25%,50%,75%,100%位置处的数据
#可自己设置百分比
quantile(data,probs=0.975)
#方差:衡量数据集里面任意数值与均值的平均偏离程度
var()
#标准差:
sd()
#直方图,binwidth表示区间宽度为1
ggplot(heights.weights, aes(x = Height)) +geom_histogram(binwidth = 1)

#发现上图是对称的,使用直方图时记住:区间宽度是强加给数据的一个外部结构,但是它却同时揭示了数据的内部结构
#把宽度改成5
ggplot(heights.weights, aes(x = Height)) +geom_histogram(binwidth = 5)
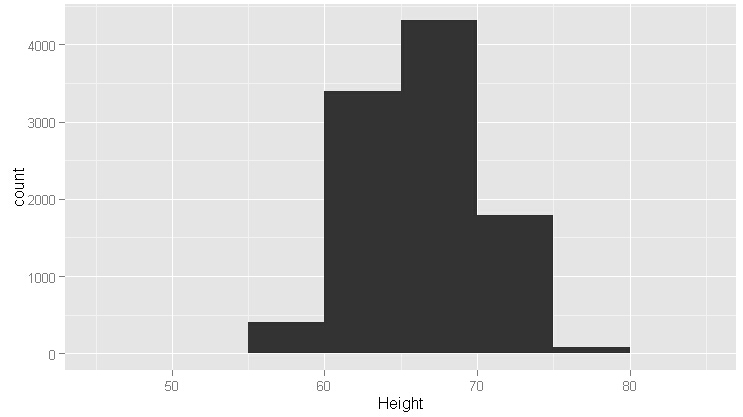
#从上图看,对称性不存在了,这叫过平滑,相反的情况叫欠平滑,如下图
ggplot(heights.weights, aes(x = Height)) +geom_histogram(binwidth = 0.01)

#因此合适的直方图需要调整宽度值.可以选择其他方式进行可视化,即密度曲线图
ggplot(heights.weights, aes(x = Height)) +geom_density()

#如上图,峰值平坦,尝试按性别划分数据
ggplot(heights.weights, aes(x = Height, fill = Gender)) +geom_density()

#混合模型,由两个标准分布混合而形成的一个非标准分布
#正态分布,钟形曲线或高斯分布
#按性别分片
ggplot(heights.weights, aes(x = Weight, fill = Gender)) +geom_density() +facet_grid(Gender ~ .)

#以下代码指定分布的均值和方差,m和s可以调整,只是移动中心或伸缩宽度
m <- 0
s <- 1
ggplot(data.frame(X = rnorm(100000, m, s)), aes(x = X)) +geom_density()
#构建出了密度曲线,众数在钟形的峰值处
#正态分布的众数同时也是均值和中位数
#只有一个众数叫单峰,两个叫双峰,两个以上叫多峰
#从一个定性划分分布有对称(symmetric)分布和偏态(skewed)分布
#对称(symmetric)分布:众数左右两边形状一样,比如正态分布
#这说明观察到小于众数的数据和大于众数的数据可能性是一样的.
#偏态(skewed)分布:说明在众数右侧观察到极值的可能性要大于其左侧,称为伽玛分布
#从另一个定性区别划分两类数据:窄尾分布(thin-tailed)和重尾分布(heavy-tailed)
#窄尾分布(thin-tailed)所产生的值通常都在均值附近,可能性有99%
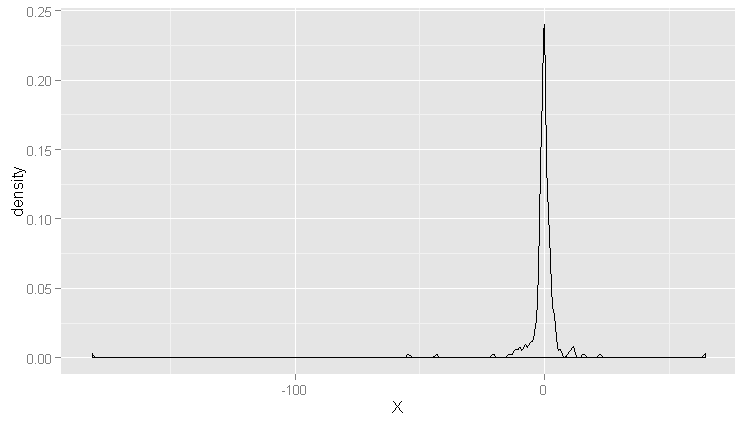
#柯西分布(Cauchy distribution)大约只有90%的值落在三个标准差内,距离均值越远,分布特点越不同
#正态分布几乎不可能产生出距离均值有6个标准差的值,柯西分布有5%的可能性
#产生正态分布及柯西分布随机数
set.seed(1)
normal.values <- rnorm(250, 0, 1)
cauchy.values <- rcauchy(250, 0, 1)
range(normal.values)
range(cauchy.values)
#画图
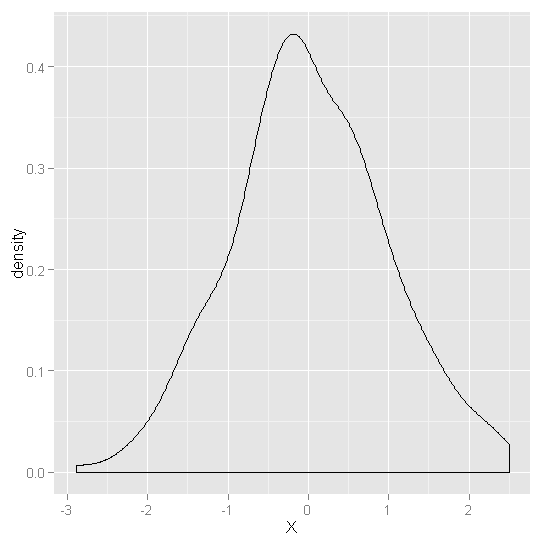
ggplot(data.frame(X = normal.values), aes(x = X)) +geom_density()
ggplot(data.frame(X = cauchy.values), aes(x = X)) +geom_density()
#正态分布:单峰,对称,钟形窄尾
#柯西分布:单峰,对称,钟形重尾
#产生gamma分布随机数
gamma.values <- rgamma(100000, 1, 0.001)
ggplot(data.frame(X = gamma.values), aes(x = X)) +geom_density()

#游戏数据很多都符合伽玛分布
#伽玛分布只有正值
#指数分布:数据集中频数最高是0,并且只有非负值出现
#例如,企业呼叫中心常发现两次收到呼叫请求的间隔时间看上去符合指数分布
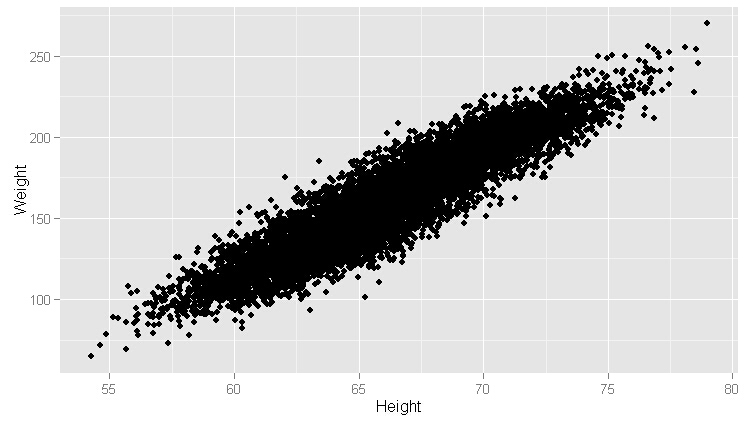
#散点图
ggplot(heights.weights, aes(x = Height, y = Weight)) +geom_point()
#加平滑模式
ggplot(heights.weights, aes(x = Height, y = Weight)) +geom_point() +geom_smooth()
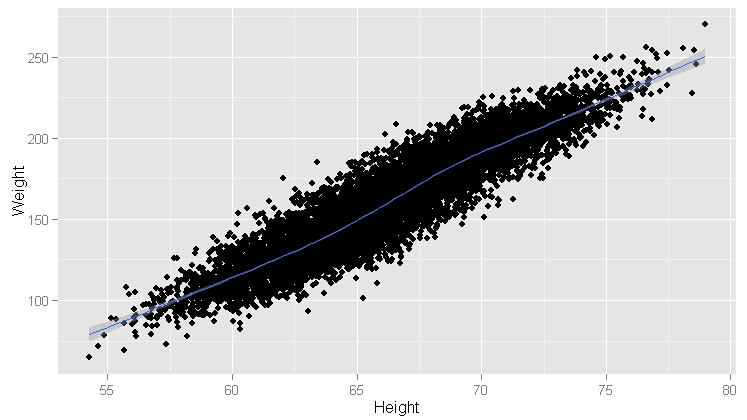
ggplot(heights.weights[1:20, ], aes(x = Height, y = Weight)) +geom_point() +geom_smooth()
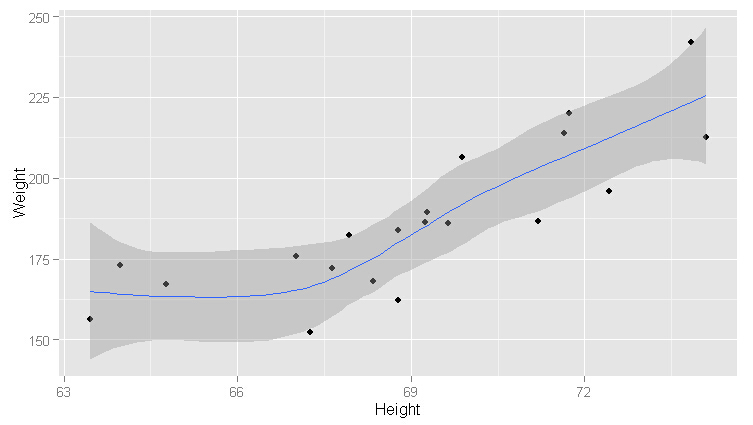
ggplot(heights.weights[1:200, ], aes(x = Height, y = Weight)) +geom_point() +geom_smooth()

ggplot(heights.weights[1:2000, ], aes(x = Height, y = Weight)) +geom_point() +geom_smooth()

ggplot(heights.weights, aes(x = Height, y = Weight)) +
geom_point(aes(color = Gender, alpha = 0.25)) +
scale_alpha(guide = "none") +
scale_color_manual(values = c("Male" = "black", "Female" = "gray")) +
theme_bw()
# An alternative using bright colors.
ggplot(heights.weights, aes(x = Height, y = Weight, color = Gender)) +
geom_point()
#
# Snippet 35
#
heights.weights <- transform(heights.weights,
Male = ifelse(Gender == 'Male', 1, 0))
logit.model <- glm(Male ~ Weight + Height,
data = heights.weights,
family = binomial(link = 'logit'))
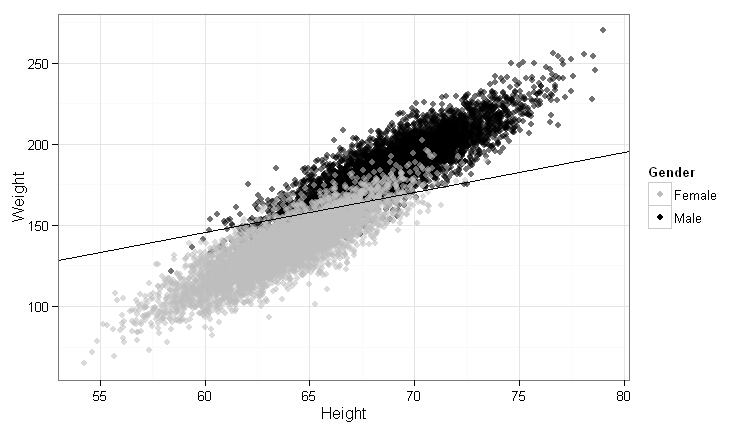
ggplot(heights.weights, aes(x = Height, y = Weight)) +
geom_point(aes(color = Gender, alpha = 0.25)) +
scale_alpha(guide = "none") +
scale_color_manual(values = c("Male" = "black", "Female" = "gray")) +
theme_bw() +
stat_abline(intercept = -coef(logit.model)[1] / coef(logit.model)[2],
slope = - coef(logit.model)[3] / coef(logit.model)[2],
geom = 'abline',
color = 'black')
Machine Learning for hackers读书笔记(二)数据分析的更多相关文章
- Machine Learning for hackers读书笔记(十二)模型比较
library('ggplot2')df <- read.csv('G:\\dataguru\\ML_for_Hackers\\ML_for_Hackers-master\\12-Model_C ...
- Machine Learning for hackers读书笔记(十)KNN:推荐系统
#一,自己写KNN df<-read.csv('G:\\dataguru\\ML_for_Hackers\\ML_for_Hackers-master\\10-Recommendations\\ ...
- Machine Learning for hackers读书笔记(七)优化:密码破译
#凯撒密码:将每一个字母替换为字母表中下一位字母,比如a变成b. english.letters <- c('a', 'b', 'c', 'd', 'e', 'f', 'g', 'h', 'i' ...
- Machine Learning for hackers读书笔记(六)正则化:文本回归
data<-'F:\\learning\\ML_for_Hackers\\ML_for_Hackers-master\\06-Regularization\\data\\' ranks < ...
- Machine Learning for hackers读书笔记(三)分类:垃圾邮件过滤
#定义函数,打开每一个文件,找到空行,将空行后的文本返回为一个字符串向量,该向量只有一个元素,就是空行之后的所有文本拼接之后的字符串 #很多邮件都包含了非ASCII字符,因此设为latin1就可以读取 ...
- Machine Learning for hackers读书笔记_一句很重要的话
为了培养一个机器学习领域专家那样的直觉,最好的办法就是,对你遇到的每一个机器学习问题,把所有的算法试个遍,直到有一天,你凭直觉就知道某些算法行不通.
- Machine Learning for hackers读书笔记(九)MDS:可视化地研究参议员相似性
library('foreign') library('ggplot2') data.dir <- file.path('G:\\dataguru\\ML_for_Hackers\\ML_for ...
- Machine Learning for hackers读书笔记(八)PCA:构建股票市场指数
library('ggplot2') prices <- read.csv('G:\\dataguru\\ML_for_Hackers\\ML_for_Hackers-master\\08-PC ...
- Machine Learning for hackers读书笔记(五)回归模型:预测网页访问量
线性回归函数 model<-lm(Weight~Height,data=?) coef(model):得到回归直线的截距 predict(model):预测 residuals(model):残 ...
随机推荐
- UML教程首页(转载)
UML是一种标准语言,用于指定,可视化,构造和文档的软件系统的文物. UML是OMG在1997年1月提出了创建由对象管理组和UML1.0规范草案. 本教程给出了一个比较完整的学习理解UML,可以方便学 ...
- nodejs的安装和配置
上次我们介绍了nodeJs入门的一些概念包括nodeJs.npm.express,这次我们介绍在linux的安装以及配置过程 目录: 1 如何在 Linux.Windows上通过包或包管理器安装 No ...
- POJ 1961
#include<iostream> #include<stdio.h> #define MAXN 1000001 using namespace std; char c[MA ...
- ExtJs之Field.Trigger和Field.Spinner
作文本框功能的. <!DOCTYPE html> <html> <head> <title>ExtJs</title> <meta h ...
- spring_150803_service
实体类: package com.spring.model; public class DogPet { private int id; private String name; private in ...
- (.iso)光盘镜像文件的打开与安装
直接解压就可以打开,然后就可以安装.exe文件
- 添加dubbo xsd的支持
使用dubbo时遇到问题: org.xml.sax.SAXParseException: schema_reference.4: Failed to read schema document 'htt ...
- iOS开发--storyboard适配pin
- 迷时师度,悟了自度(时间的边际效应),附VC参考书
12年前看过这篇文章,今天又看到了,还是有些感慨的.上课的时间虽然已经永远远去,用整块的时间去学习已经不可能,但道理还是要记着的,没准依然有用,自勉.------------------------- ...
- Android 时间格式的正则表达式
//日期格式yyyy PatternsDict.date_y= /^(\d{4})$/; //日期格式yyyy-mm PatternsDict.date_ym= /^(\d{4})-(0\d{1} ...