
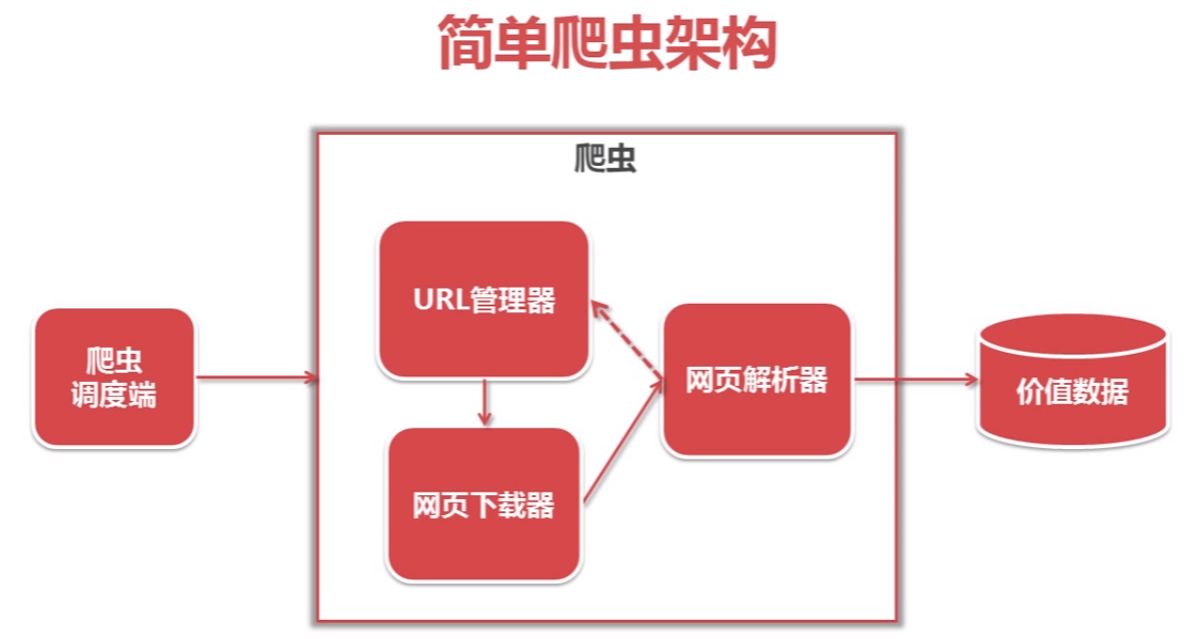
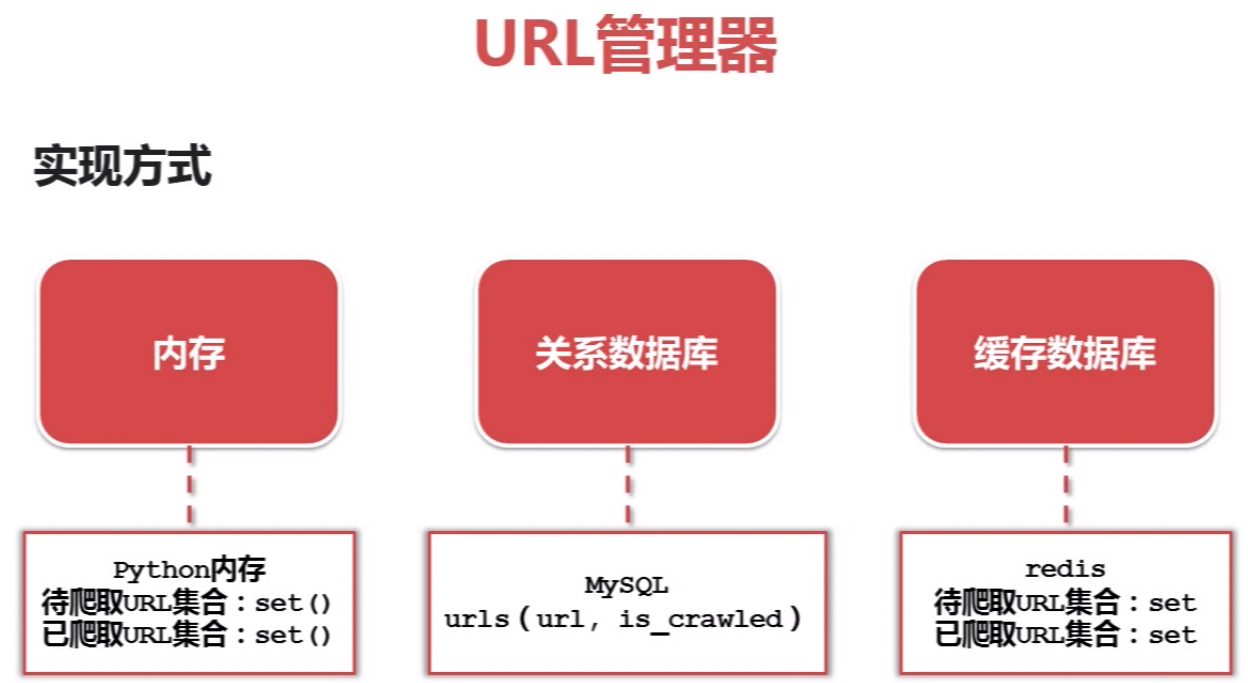
python爬虫简单架构原理及示例


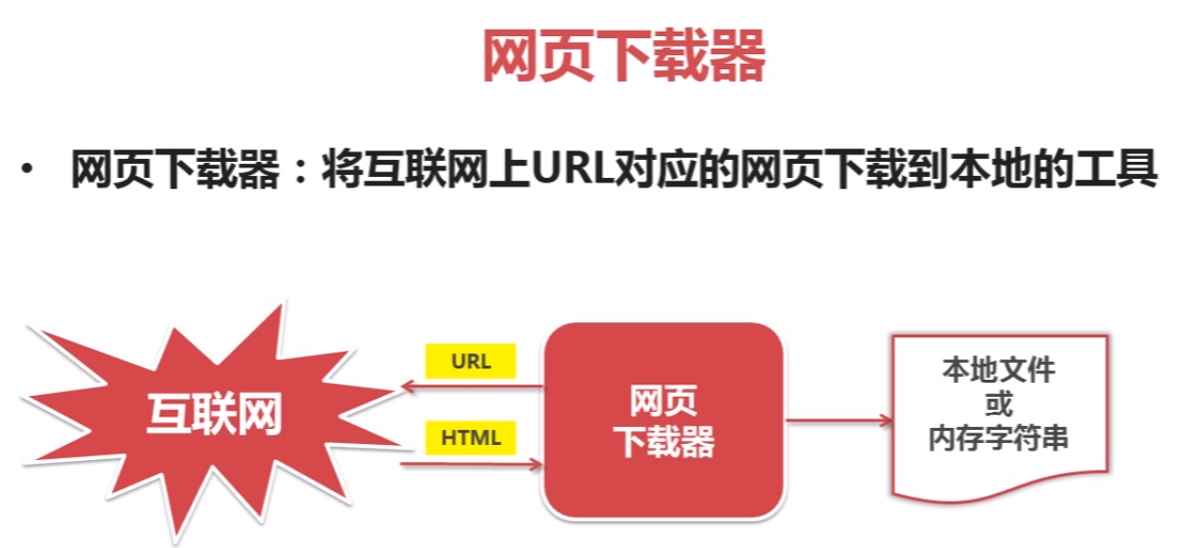

网页下载器示例:
# coding:utf-8

import urllib2

import cookielib

url = "http://www.baidu.com"

print u"第一种方法"

# pip install urllib2

response1 = urllib2.urlopen(url)

print response1.getcode()

print len(response1.read())

print u"第二种方法"

request = urllib2.Request(url)

# 把爬虫伪装成浏览器

request.add_header("user-agent", "Mozilla/5.0")

response2 = urllib2.urlopen(request)

print response2.getcode()

print len(response2.read())

print u"第三种方法"

# pip install cookielib

cj = cookielib.CookieJar()

opener = urllib2.build_opener(urllib2.HTTPCookieProcessor(cj))

urllib2.install_opener(opener)

response3 = urllib2.urlopen(request)

print response3.getcode()

print cj

print len(response3.read())
# 运行结果

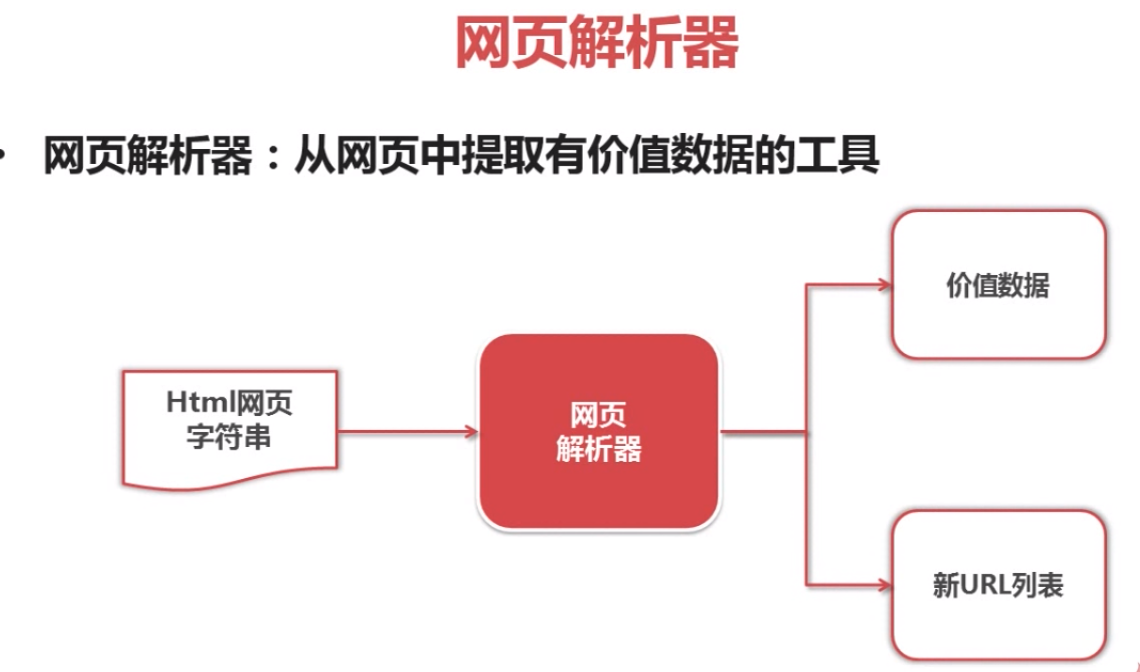

beautifulsoap使用示例
#coding:utf-8

# 安装beautifulsoap4  D:\Python27\Lib>pip install beautifulsoup4

from bs4 import BeautifulSoup

import re

html_doc = """

<html><head><title>The Dormouse's story</title></head>

<body>

<p class="title"><b>The Dormouse's story</b></p>

<p class="story">Once upon a time there were three little sisters; and their names were

<a href="http://example.com/elsie" class="sister" id="link1">Elsie</a>,

<a href="http://example.com/lacie" class="sister" id="link2">Lacie</a> and

<a href="http://example.com/tillie" class="sister" id="link3">Tillie</a>;

and they lived at the bottom of a well.</p>

<p class="story">...</p>

"""

soup = BeautifulSoup(html_doc, 'html.parser', from_encoding='utf-8')

print u'获取所有的链接'

links = soup.find_all('a')

for link in links:

    print link.name,link['href'], link.get_text()

print u'获取lacie的链接'

link_node = soup.find('a', href='http://example.com/lacie')

print link_node.name, link_node['href'],link_node.get_text()

print u'正则匹配'

link_node = soup.find('a', href=re.compile(r"ill"))

print link_node.name, link_node['href'],link_node.get_text()

print u'获取p段落名字'

link_node = soup.find('p', class_="title")

print link_node.name, link_node.get_text()
python爬虫简单架构原理及示例的更多相关文章
- Python爬虫简单实现CSDN博客文章标题列表
Python爬虫简单实现CSDN博客文章标题列表 操作步骤: 分析接口,怎么获取数据? 模拟接口,尝试提取数据 封装接口函数,实现函数调用. 1.分析接口 打开Chrome浏览器,开启开发者工具(F1 ...
- Python爬虫简单入门及小技巧
刚刚申请博客,内心激动万分.于是为了扩充一下分类,随便一个随笔,也为了怕忘记新学的东西由于博主十分怠惰,所以本文并不包含安装python(以及各种模块)和python语法. 目标 前几天上B站时看到一 ...
- [python爬虫]简单爬虫功能
在我们日常上网浏览网页的时候,经常会看到某个网站中一些好看的图片,它们可能存在在很多页面当中,我们就希望把这些图片保存下载,或者用户用来做桌面壁纸,或者用来做设计的素材. 我们最常规的做法就是通过鼠标 ...
- Python爬虫--简单爬取图片
今天晚上弄了一个简单的爬虫,可以爬取网页的图片,现在现在做一下准备工作. 需要的库:urllib 和 re urllib库可以理解为是一个url下载器,其中有三个重要的方法 urllib.urlope ...
- python爬虫简单的添加代理进行访问
在使用python对网页进行多次快速爬取的时候,访问次数过于频繁,服务器不会考虑User-Agent的信息,会直接把你视为爬虫,从而过滤掉,拒绝你的访问,在这种时候就需要设置代理,我们可以给proxi ...
- Python爬虫简单介绍
相关环境: Python3 requests库 BeautifulSoup库 一.requests库简单使用 简单获取一个网页的源代码: import requests sessions = requ ...
- Python爬虫简单实现之Q乐园图片下载
根据需求写代码实现.然而跟我并没有什么关系,我只是打开电脑望着屏幕想着去干点什么,于是有了这个所谓的“需求”. 终于,我发现了Q乐园——到底是我老了还是我小了,这是什么神奇的网站,没听过啊,就是下面酱 ...
- 用python爬虫简单爬取 笔趣网:类“起点网”的小说
首先:文章用到的解析库介绍 BeautifulSoup: Beautiful Soup提供一些简单的.python式的函数用来处理导航.搜索.修改分析树等功能. 它是一个工具箱,通过解析文档为用户提供 ...
- Python爬虫--简单的单词查询
Refer to: https://github.com/gaopu/Python/blob/master/Dict.py 本程序参考自上面Github连接 该程序功能是输入一个单词可以给出这个单词的 ...
随机推荐
- Pycharm中Git、Github的简单使用和配置
Pycharm中Git.Github的使用 PyCharm本身自带了git,稍微配置一下就可以很好的在图形界面下进行Python项目的版本控制 配置Git 在配置前先新建一个项目,当然也可以打开已有的 ...
- linux根据进程名字杀死进程
ps -ef | grep procedure_name | grep -v grep | awk '{print $2}' | xargs kill -9 Linux Shell脚本实现根据进程名杀 ...
- 通过请求接口的办法获得本设备IP以及IP地址
获取本设备IP接口(搜狐) http://pv.sohu.com/cityjson?ie=utf-8 result Content: { "cip": "58.21 ...
- JavaSE 学习笔记之Java语法基础(二)
1,关键字:其实就是某种语言赋予了特殊含义的单词. 保留字:其实就是还没有赋予特殊含义,但是准备日后要使用过的单词. 2,标示符:其实就是在程序中自定义的名词.比如类名,变量名,函数名.包含 0-9. ...
- (10)Spring Boot修改端口号【从零开始学Spring Boot】
Spring boot 默认端口是8080,如果想要进行更改的话,只需要修改applicatoin.properties文件,在配置文件中加入: server.port=9090 常用配置: #### ...
- 0709关于mysql优化思路【何登成】
转自 http://isky000.com/database/mysql-performance-tuning-sql 优化目标 减少 IO 次数IO永远是数据库最容易瓶颈的地方,这是由数据库的职责所 ...
- sikuli类、函数使用参考java doc
sikuli类.函数使用可以参考java dochttp://doc.sikuli.org/javadoc/ http://stackoverflow.com/questions/9568612/s ...
- maven 自建库
maven repository 标签: mavenjarxmlserver工具磁盘 2009-11-26 10:56 42322人阅读 评论(7) 收藏 举报 目录(?)[+] 什么是Mav ...
- 关于PHP浮点数之 intval((0.1+0.7)*10) 为什么是7
PHP是一种弱类型语言, 这样的特性, 必然要求有无缝透明的隐式类型转换, PHP内部使用zval来保存任意类型的数值, zval的结构如下(5.2为例): struct _zval_struct { ...
- PHP统计所有字符在字符串中出现的次数
<?php //统计字符串中出现的字符,出现次数 echo '<pre>'; $str = 'aaabbccqqwweedfghhjffffffffggggggggg';//字符串示 ...