
python爬虫简单的添加代理进行访问
在使用python对网页进行多次快速爬取的时候,访问次数过于频繁,服务器不会考虑User-Agent的信息,会直接把你视为爬虫,从而过滤掉,拒绝你的访问,在这种时候就需要设置代理,我们可以给proxies属性设置一个代理的IP地址,代码如下:
 import requests

 from lxml import etree

 url = "https://www.ip.cn"

 headers = {"User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/70.0.3538.102 Safari/537.36 OPR/57.0.3098.116", }

 pro = {

     # 'https': 'https://118.122.92.252:37901',        #四川省成都市 电信

     'https': 'https://27.17.45.90:43411',         #湖北省武汉市 电信

 }

 try:

     response = requests.get(url, headers=headers, proxies=pro)

     html_str = response.content.decode()

     # print(html_str)

     html = etree.HTML(html_str)

     message = html.xpath("//div[@class='well']//p/text()")

     ip = html.xpath("//div[@class='well']//p/code/text()")

     eng = html.xpath("//div[@class='well']/p/text()")

     print(message[0]+ip[0])

     print(message[1]+ip[1])

     print(eng[2])

 except requests.exceptions.ProxyError as e:

     print("当前代理异常")

 except:

     print("当前请求异常")
在上面的代码中,调用requests库,对一个IP地址查询网页进行访问,随后使用lxml库的xpath对网页进行分析提取,返回用户访问此网页时自己的IP地址,如果代理设置成功,则会返回你的信息和IP地址,如下:
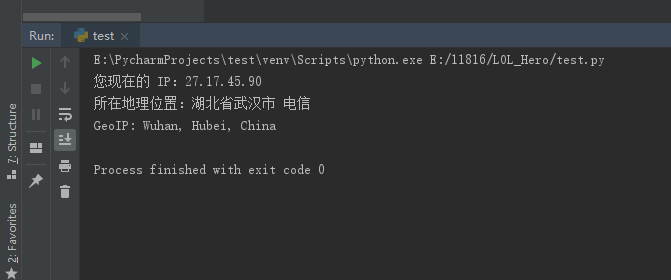
如果代理失败则会返回异常,在代码中使用了捕获异常,则会返回设置的提示信息,"当前代理异常",如果不是代理的错误则是"当前请求异常"
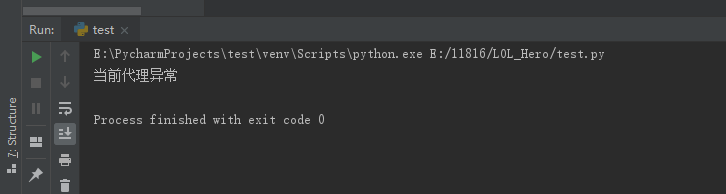
PS:免费的代理不是很稳定,在确认代码无误后,如果仍然返回异常,可尝试更换代理IP...
python爬虫简单的添加代理进行访问的更多相关文章
- Python爬虫简单实现CSDN博客文章标题列表
Python爬虫简单实现CSDN博客文章标题列表 操作步骤: 分析接口,怎么获取数据? 模拟接口,尝试提取数据 封装接口函数,实现函数调用. 1.分析接口 打开Chrome浏览器,开启开发者工具(F1 ...
- Python爬虫简单入门及小技巧
刚刚申请博客,内心激动万分.于是为了扩充一下分类,随便一个随笔,也为了怕忘记新学的东西由于博主十分怠惰,所以本文并不包含安装python(以及各种模块)和python语法. 目标 前几天上B站时看到一 ...
- python爬虫——selenium+chrome使用代理
先看下本文中的知识点: python selenium库安装 chrome webdirver的下载安装 selenium+chrome使用代理 进阶学习 搭建开发环境: selenium库 chro ...
- python爬虫——requests库使用代理
在看这篇文章之前,需要大家掌握的知识技能: python基础 html基础 http状态码 让我们看看这篇文章中有哪些知识点: get方法 post方法 header参数,模拟用户 data参数,提交 ...
- [python爬虫]简单爬虫功能
在我们日常上网浏览网页的时候,经常会看到某个网站中一些好看的图片,它们可能存在在很多页面当中,我们就希望把这些图片保存下载,或者用户用来做桌面壁纸,或者用来做设计的素材. 我们最常规的做法就是通过鼠标 ...
- Python爬虫--简单爬取图片
今天晚上弄了一个简单的爬虫,可以爬取网页的图片,现在现在做一下准备工作. 需要的库:urllib 和 re urllib库可以理解为是一个url下载器,其中有三个重要的方法 urllib.urlope ...
- python爬虫之Scrapy 使用代理配置
转载自:http://www.python_tab.com/html/2014/pythonweb_0326/724.html 在爬取网站内容的时候,最常遇到的问题是:网站对IP有限制,会有防抓取功能 ...
- Python爬虫简单介绍
相关环境: Python3 requests库 BeautifulSoup库 一.requests库简单使用 简单获取一个网页的源代码: import requests sessions = requ ...
- python爬虫之Scrapy 使用代理配置——乾颐堂
在爬取网站内容的时候,最常遇到的问题是:网站对IP有限制,会有防抓取功能,最好的办法就是IP轮换抓取(加代理) 下面来说一下Scrapy如何配置代理,进行抓取 1.在Scrapy工程下新建“middl ...
随机推荐
- Intervals 差分约束
题意:给定n个区间[Li,Ri]以及n个整数vi. 现在要有一个集合,使得这个集合和任意[Li,Ri]都有 至少 vi个元素相同. 问这个集合最少要几个元素. 定义S(x) 表示[1,x]中选择的元素 ...
- PTA L2-001 紧急救援 (带权最短路)
<题目链接> 题目大意: 作为一个城市的应急救援队伍的负责人,你有一张特殊的全国地图.在地图上显示有多个分散的城市和一些连接城市的快速道路.每个城市的救援队数量和每一条连接两个城市的快速道 ...
- Hadoop伪分布式的搭建
主要分为三个步骤:1.安装vmware虚拟机运行软件 2.在vmware虚拟机中安装linux操作系统 3.配置hadoop伪分布式环境 Hadoop环境部署-JDK部分------------ ...
- CF 960 G
难受的1b,怎么会这样 先去学写一发 NTT 大概说一下斯特林数
- Spark环境搭建(一)-----------HDFS分布式文件系统搭建
下载的压缩文件放在~/software/ 解压安装在~/app/ 一:分布式文件系统搭建HDFS 1,下载Hadoop HDFS环境搭建 使用版本:hadoop-2.6.0-cdh5.7. ...
- java集合的复习
1:自定义的linkedList链表 https://blog.csdn.net/qq_33471403/article/details/80109620 2:用linked https://b ...
- webpack之带有可自动打开浏览器及热重载的基本配置
什么是Webpack WebPack可以看做是模块打包机:它做的事情是,分析你的项目结构,找到JavaScript模块以及其它的一些浏览器不能直接运行的拓展语言(Scss,TypeScript等),并 ...
- idea创建第一个普通java web项目
1.新建项目(工作空间) 选择空项目 输入项目名称,点击完成 系统会默认选中Modules,点击上面的小+号创建模块->New Module 新建一个Java EE Web Applicatio ...
- Python练手例子(4)
16.一个数如果恰好等于它的因子之和,这个数就称为"完数".例如6=1+2+3.编程找出1000以内的所有完数. 程序分析:请参照程序Python 100例中的第14个例子 #py ...
- 工具包分享-常用工具。by-某某
下载地址: 链接:http://pan.baidu.com/s/1hsseqm4 密码:a6rc 里面的工具全部来自互联网,本人不是工具的生产者,只是它的收集工. 都是一些很常用,顺手的工具,仅用于技 ...