
python网络爬虫抓取动态网页并将数据存入数据库MySQL
简述
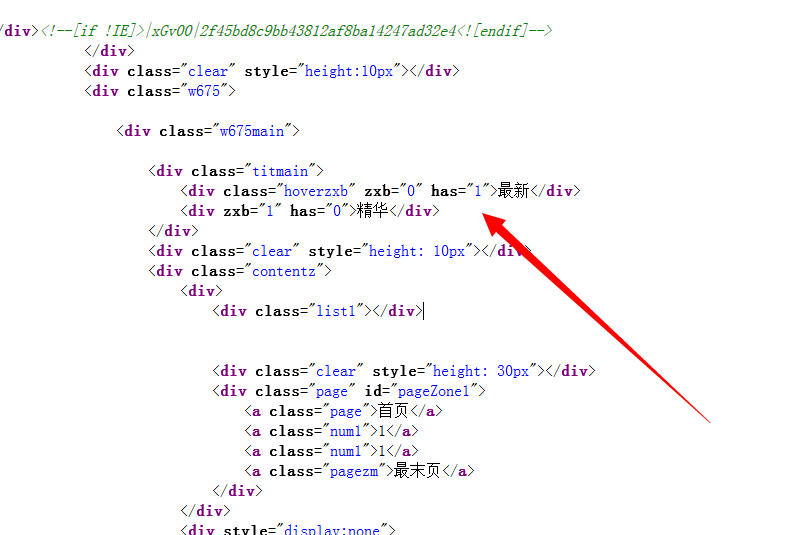
以下的代码是使用python实现的网络爬虫,抓取动态网页 http://hb.qq.com/baoliao/ 。此网页中的最新、精华下面的内容是由JavaScript动态生成的。审查网页元素与网页源码是不同。
以下是网页源码
以上是审查网页元素
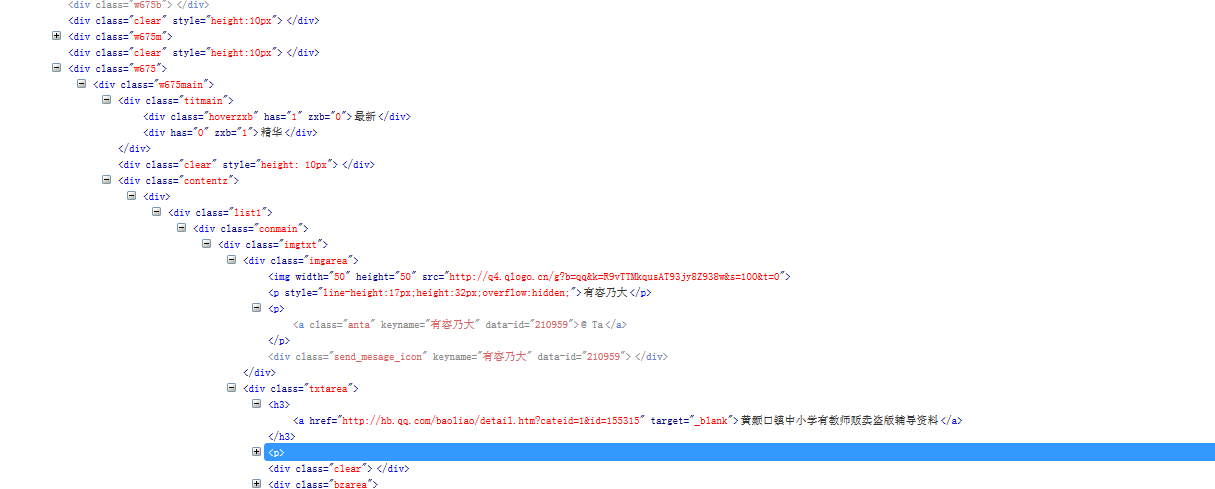
所以此处不能简单的使用正则表达式来获取内容。
以下是完整的获取内容并存储到数据库的思路及源码。
实现思路:
抓取实际访问的动态页面的url – 使用正则表达式获取需要的内容 – 解析内容 – 存储内容
以上部分过程文字解释:
抓取实际访问的动态页面的url:
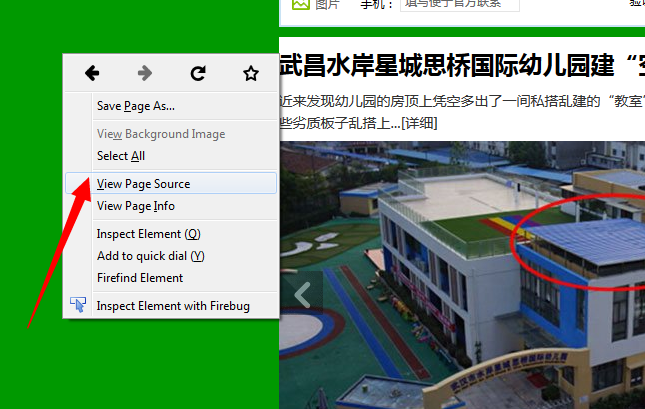
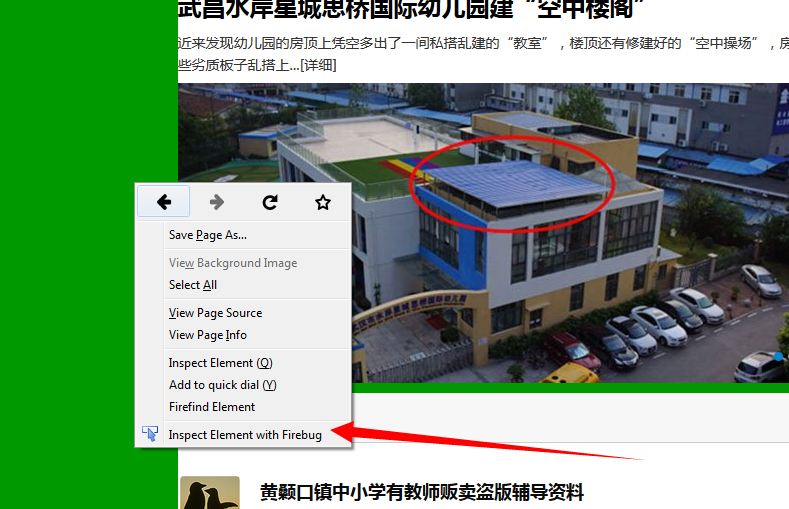
在火狐浏览器中,右键打开插件 使用**firebug审查元素** *(没有这项的,要安装firebug插件),找到并打开**网络(NET)**标签页。重新加载网页,获得网页的响应信息,包括连接地址。每个连接地址都可以在浏览器中打开。本网站的动态网页访问地址是:
在火狐浏览器中,右键打开插件 使用**firebug审查元素** *(没有这项的,要安装firebug插件),找到并打开**网络(NET)**标签页。重新加载网页,获得网页的响应信息,包括连接地址。每个连接地址都可以在浏览器中打开。本网站的动态网页访问地址是:

http://baoliao.hb.qq.com/api/report/NewIndexReportsList/cityid/18/num/20/pageno/1?callback=jQuery183019859437816181613_1440723895018&_=1440723895472
正则表达式:
正则表达式的使用有两种思路,可以参考个人有关其简述:python实现简单爬虫以及正则表达式简述
更多的细节介绍可以参考网上资料,搜索关键词: 正则表达式 python
json:
参考网上有关json的介绍,搜索关键词: json python
存储到数据库:
参考网上的使用介绍,搜索关键词: 1,mysql 2,mysql python
源码及注释
注意:使用python的版本是 2.7
#!/usr/bin/python

#指明编码

# -*- coding: UTF-8 -*-

#导入python库

import urllib

import urllib2

import re

import MySQLdb

import json

#定义爬虫类

class crawl1:

    def getHtml(self,url=None):

        #代理

        user_agent="Mozilla/5.0 (Windows NT 6.1; WOW64; rv:40.0) Gecko/20100101 Firefox/40.0"

        header={"User-Agent":user_agent}

        request=urllib2.Request(url,headers=header)

        response=urllib2.urlopen(request)

        html=response.read()

        return html

    def getContent(self,html,reg):

        content=re.findall(html, reg, re.S)

        return content

     #连接数据库 mysql

    def connectDB(self):

        host="192.168.85.21"

        dbName="test1"

        user="root"

        password=""

        #此处添加charset='utf8'是为了在数据库中显示中文,此编码必须与数据库的编码一致

        db=MySQLdb.connect(host,user,password,dbName,charset='utf8')

        return db

        cursorDB=db.cursor()

        return cursorDB

      #创建表,SQL语言。CREATE TABLE IF NOT EXISTS 表示:表createTableName不存在时就创建

    def creatTable(self,createTableName):

        createTableSql="CREATE TABLE IF NOT EXISTS "+ createTableName+"(time VARCHAR(40),title VARCHAR(100),text  VARCHAR(40),clicks VARCHAR(10))"

        DB_create=self.connectDB()

        cursor_create=DB_create.cursor()

        cursor_create.execute(createTableSql)

        DB_create.close()

        print 'creat table '+createTableName+' successfully'

        return createTableName

    #数据插入表中

    def inserttable(self,insertTable,insertTime,insertTitle,insertText,insertClicks):

        insertContentSql="INSERT INTO "+insertTable+"(time,title,text,clicks)VALUES(%s,%s,%s,%s)"

#         insertContentSql="INSERT INTO "+insertTable+"(time,title,text,clicks)VALUES("+insertTime+" , "+insertTitle+" , "+insertText+" , "+insertClicks+")"

        DB_insert=self.connectDB()

        cursor_insert=DB_insert.cursor()

        cursor_insert.execute(insertContentSql,(insertTime,insertTitle,insertText,insertClicks))

        DB_insert.commit()

        DB_insert.close()

        print 'inert contents to  '+insertTable+' successfully'

url="http://baoliao.hb.qq.com/api/report/NewIndexReportsList/cityid/18/num/20/pageno/1?callback=jQuery183019859437816181613_1440723895018&_=1440723895472"

#正则表达式,获取js,时间,标题,文本内容,点击量(浏览次数)

reg_jason=r'.*?jQuery.*?\((.*)\)'

reg_time=r'.*?"create_time":"(.*?)"'

reg_title=r'.*?"title":"(.*?)".*?'

reg_text=r'.*?"content":"(.*?)".*?'

reg_clicks=r'.*?"counter_clicks":"(.*?)"'

#实例化crawl()对象

crawl=crawl1()

html=crawl.getHtml(url)

html_jason=re.findall(reg_jason, html, re.S)

html_need=json.loads(html_jason[0])

print len(html_need)

print len(html_need['data']['list'])

table=crawl.creatTable('yh1')

for i in range(len(html_need['data']['list'])):

    creatTime=html_need['data']['list'][i]['create_time']

    title=html_need['data']['list'][i]['title']

    content=html_need['data']['list'][i]['content']

    clicks=html_need['data']['list'][i]['counter_clicks']

    crawl.inserttable(table,creatTime,title,content,clicks)
python网络爬虫抓取动态网页并将数据存入数据库MySQL的更多相关文章
- 如何利用Python网络爬虫抓取微信朋友圈的动态(上)
今天小编给大家分享一下如何利用Python网络爬虫抓取微信朋友圈的动态信息,实际上如果单独的去爬取朋友圈的话,难度会非常大,因为微信没有提供向网易云音乐这样的API接口,所以很容易找不到门.不过不要慌 ...
- 如何利用Python网络爬虫抓取微信好友数量以及微信好友的男女比例
前几天给大家分享了利用Python网络爬虫抓取微信朋友圈的动态(上)和利用Python网络爬虫爬取微信朋友圈动态——附代码(下),并且对抓取到的数据进行了Python词云和wordart可视化,感兴趣 ...
- 利用Python网络爬虫抓取微信好友的签名及其可视化展示
前几天给大家分享了如何利用Python词云和wordart可视化工具对朋友圈数据进行可视化,利用Python网络爬虫抓取微信好友数量以及微信好友的男女比例,以及利用Python网络爬虫抓取微信好友的所 ...
- 利用Python网络爬虫抓取微信好友的所在省位和城市分布及其可视化
前几天给大家分享了如何利用Python网络爬虫抓取微信好友数量以及微信好友的男女比例,感兴趣的小伙伴可以点击链接进行查看.今天小编给大家介绍如何利用Python网络爬虫抓取微信好友的省位和城市,并且将 ...
- python网络爬虫抓取网站图片
本文介绍两种爬取方式: 1.正则表达式 2.bs4解析Html 以下为正则表达式爬虫,面向对象封装后的代码如下: import urllib.request # 用于下载图片 import os im ...
- 如何利用Python网络爬虫爬取微信朋友圈动态--附代码(下)
前天给大家分享了如何利用Python网络爬虫爬取微信朋友圈数据的上篇(理论篇),今天给大家分享一下代码实现(实战篇),接着上篇往下继续深入. 一.代码实现 1.修改Scrapy项目中的items.py ...
- 【转】详解抓取网站,模拟登陆,抓取动态网页的原理和实现(Python,C#等)
转自:http://www.crifan.com/files/doc/docbook/web_scrape_emulate_login/release/html/web_scrape_emulate_ ...
- selenium抓取动态网页数据
1.selenium抓取动态网页数据基础介绍 1.1 什么是AJAX AJAX(Asynchronouse JavaScript And XML:异步JavaScript和XML)通过在后台与服务器进 ...
- scrapy和selenium结合抓取动态网页
1.安装python (我用的是2.7版本的) 2.安装scrapy: 详情请参考 http://blog.csdn.net/wukaibo1986/article/details/8167590 ...
随机推荐
- IO、NIO、AIO
一. IO 传统的IO是同步阻塞模式,数据的读取与写入会阻塞在一个线程内等待其完成. 主要面向字节流编程.(流是单向的) 二. NIO NIO支持同步非阻塞模式,在进行IO调用后,然后去 轮询调用结果 ...
- Vue的声明周期
以下简单介绍,以自己的理解进行分析.如有不好,请大牛勿喷!!!!!! new Vue() 创建 Vue 实例 beforeCreate(){}: 第一生命周期 表示实例完全创建出来,此函数执行是,da ...
- vue-cli项目配置文件分析
最近在vue-cli生成的webpack模板项目的基础上开发了一些项目,开发过程中遇到很多坑,并且需要改动build和config里面一些相关的配置,查阅,学习,总结,分享. 一.配置文件结构 本文主 ...
- JS常用工具函数(持续记录)
1.设置获取cookie //方式1 //设置cookie function SetCookie(name, value)//两个参数,一个是cookie的名字,一个是值 { var Days = 3 ...
- 【sping揭秘】8、容器内部事件发布(一)
容器内部事件发布 Spring的applicationContext容器提供的容器内事件发布功能,是通过java提供的自定义事件实现的 事件类型:eventObject 类继承 事件监听:eventL ...
- [Umbraco] xslt语言介绍及与umbraco的关系
XSLT是扩展样式表转换语言(Extensible Stylesheet Language Transformations)的简称,这是一种对XML文档进行转化的语言,XSLT中的T代表英语中的“转换 ...
- HuLu机器学习问题与解答系列(1-8)
声明:本系列文章转载自微信公众号HULU,本人只是搬运工,仅供学习,如有不妥,后续告知删除. 嗨,欢迎回来,希望你能保持定期回顾的好习惯噢!下面是Hulu机器学习问题与解答系列的前8篇内容,点击主题名 ...
- (转)Python异常类的继承关系
原文:https://blog.csdn.net/Dragonfli_Lee/article/details/52350793 https://www.cnblogs.com/Lival/p/6203 ...
- webgl介绍
一.webgl与three.js 我们知道canvas.svg等是2D绘图的,那么如果想要使用js进行3D绘图,可以吗? 答案是肯定的!实际上主流的3D开发使用的是c++,但是随着技术的发展,Java ...
- Bash控制结构
1. if-else语句 #!/bin/bash #if ... fi 语句: if [ $a != $b ] then echo "a != b" fi #if ... else ...