
shell及Python爬虫实例展示
1.shell爬虫实例:
[root@db01 ~]# vim pa.sh

#!/bin/bash

www_link=http://www.cnblogs.com/clsn/default.html?page=

for i in  {1..8}

do

a=`curl ${www_link}${i} 2>/dev/null|grep homepage|grep -v "ImageLink"|awk -F "[><\"]" '{print $7"@"$9}' >>bb.txt`#@为自己

指定的分隔符.这行是获取内容及内容网址

done

egrep -v "pager" bb.txt >ma.txt #将处理后,只剩内容和内容网址的放在一个文件里

b=`sed  "s# ##g" ma.txt`   #将文件里的空格去掉,因为for循环会将每行的空格前后作为两个变量,而不是一行为一个变量,这个坑花

了我好长时间。

for i in $b

do

  c=`echo $i|awk -F @ '{print $1}'` #c=内容网址

  d=`echo $i|awk -F @ '{print $2}'` #d=内容

  echo "<a href='${c}' target='_blank'>${d}</a> " >>cc.txt #cc.txt为生成a标签的文本

done
爬虫结果显示:归档文件中惨绿少年的爬虫结果
注意:爬取结果放入博客应在a标签后加 的空格符或其他,博客园默认不显示字符串

2、
2.1Python爬虫学习
爬取这个网页
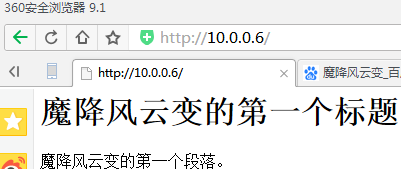
import urllib.request

# 网址

url = "http://10.0.0.6/"

# 请求

request = urllib.request.Request(url)

# 爬取结果

response = urllib.request.urlopen(request)

data = response.read()

# 设置解码方式

data = data.decode('utf-8')

# 打印结果

print(data)
结果:
E:\python\python\python.exe C:/python/day2/test.py

<html>

<meta http-equiv="Content-Type" content="text/html;charset=utf-8">

<body>

<h1>魔降风云变的第一个标题</h1>

<p>魔降风云变的第一个段落。</p>

</body>

</html>
print(type(response))
结果:
<class 'http.client.HTTPResponse'>
print(response.geturl())
结果:
http://10.0.0.6/
print(response.info())
结果:
Server: nginx/1.12.

Date: Fri,  Mar  :: GMT

Content-Type: text/html

Content-Length:

Last-Modified: Fri,  Mar  :: GMT

Connection: close

ETag: "5a98ff58-b8"

Accept-Ranges: bytes
print(response.getcode())
结果:
2.2爬取网页代码并保存到电脑文件
import urllib.request

# 网址

url = "http://10.0.0.6/"

headers = {'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) '

                         'Chrome/51.0.2704.63 Safari/537.36'}

req = urllib.request.Request(url=url, headers=headers)

res = urllib.request.urlopen(req)

data = res.read()

data = data.decode('utf-8')

# 打印抓取的内容

print(data)
结果:
<html>

<meta http-equiv="Content-Type" content="text/html;charset=utf-8">

<body>

<h1>魔降风云变的第一个标题</h1>

<p>魔降风云变的第一个段落。</p>

</body>

</html>
import urllib.request

# 定义保存函数

def saveFile(data):  #------------------------------------------

    path = "E:\\content.txt"

    f = open(path, 'wb')

    f.write(data)

    f.close()        #------------------------------------------

# 网址

url = "http://10.0.0.6/"

headers = {'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) '

                         'Chrome/51.0.2704.63 Safari/537.36'}

req = urllib.request.Request(url=url, headers=headers)

res = urllib.request.urlopen(req)

data = res.read()

# 也可以把爬取的内容保存到文件中

saveFile(data)        #******************************************

data = data.decode('utf-8')

# 打印抓取的内容

print(data)
添加保存文件的函数并执行的结果:

# # 打印爬取网页的各类信息

print(type(res))

print(res.geturl())

print(res.info())

print(res.getcode())
结果:
<class 'http.client.HTTPResponse'>

http://10.0.0.6/

Server: nginx/1.12.

Date: Fri,  Mar  :: GMT

Content-Type: text/html

Content-Length:

Last-Modified: Fri,  Mar  :: GMT

Connection: close

ETag: "5a98ff58-b8"

Accept-Ranges: bytes
2.3爬取图片
import urllib.request, socket, re, sys, os

# 定义文件保存路径

targetPath = "E:\\"

def saveFile(path):

    # 检测当前路径的有效性

    if not os.path.isdir(targetPath):

        os.mkdir(targetPath)

        # 设置每个图片的路径

    pos = path.rindex('/')

    t = os.path.join(targetPath, path[pos + 1:])

    return t

# 用if __name__ == '__main__'来判断是否是在直接运行该.py文件

# 网址

url = "http://10.0.0.6/"

headers = {

    'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) '                            'Chrome/51.0.2704.63 Safari/537.36'

}

req = urllib.request.Request(url=url, headers=headers)

res = urllib.request.urlopen(req)

data = res.read()

print(data)

for link, t in set(re.findall(r'(http:[^s]*?(jpg|png|gif))', str(data))):

    print(link)

    try:

        urllib.request.urlretrieve(link, saveFile(link))

    except:

        print('失败')
2.31
import urllib.request, socket, re, sys, os

url = "http://10.0.0.6/"

headers = {

    'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) '                            'Chrome/51.0.2704.63 Safari/537.36'

}

req = urllib.request.Request(url=url, headers=headers)

res = urllib.request.urlopen(req)

data = res.read()

print(req)

print(res)

print(data)

print(str(data))
结果:
<urllib.request.Request object at 0x0000000001ECD9E8>

<http.client.HTTPResponse object at 0x0000000002D1B128>

b'<html>\n<meta http-equiv="Content-Type" content="text/html;charset=utf-8">\n<body>\n<img src="http://10.0.0.6/ma1.png" />\n<img src="http://10.0.0.6/ma2.jpg" />\n<h1>\xe9\xad\x94\xe9\x99\x8d\xe9\xa3\x8e\xe4\xba\x91\xe5\x8f\x98\xe7\x9a\x84\xe7\xac\xac\xe4\xb8\x80\xe4\xb8\xaa\xe6\xa0\x87\xe9\xa2\x98</h1>\n<p>\xe9\xad\x94\xe9\x99\x8d\xe9\xa3\x8e\xe4\xba\x91\xe5\x8f\x98\xe7\x9a\x84\xe7\xac\xac\xe4\xb8\x80\xe4\xb8\xaa\xe6\xae\xb5\xe8\x90\xbd\xe3\x80\x82</p>\n</body>\n</html>\n'

b'<html>\n<meta http-equiv="Content-Type" content="text/html;charset=utf-8">\n<body>\n<img src="http://10.0.0.6/ma1.png" />\n<img src="http://10.0.0.6/ma2.jpg" />\n<h1>\xe9\xad\x94\xe9\x99\x8d\xe9\xa3\x8e\xe4\xba\x91\xe5\x8f\x98\xe7\x9a\x84\xe7\xac\xac\xe4\xb8\x80\xe4\xb8\xaa\xe6\xa0\x87\xe9\xa2\x98</h1>\n<p>\xe9\xad\x94\xe9\x99\x8d\xe9\xa3\x8e\xe4\xba\x91\xe5\x8f\x98\xe7\x9a\x84\xe7\xac\xac\xe4\xb8\x80\xe4\xb8\xaa\xe6\xae\xb5\xe8\x90\xbd\xe3\x80\x82</p>\n</body>\n</html>\n'
2.32
import urllib.request, socket, re, sys, os

url = "http://10.0.0.6/"

headers = {

    'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) '                            'Chrome/51.0.2704.63 Safari/537.36'

}

req = urllib.request.Request(url=url, headers=headers)

res = urllib.request.urlopen(req)

data = res.read()

for link in set(re.findall(r'(http:[^s]*?(jpg|png|gif))', str(data))):

   print(link)
结果:
('http://10.0.0.6/ma2.jpg', 'jpg')

('http://10.0.0.6/ma1.png', 'png')
2.33
for link,t in set(re.findall(r'(http:[^s]*?(jpg|png|gif))', str(data))):

   print(link)
结果:
http://10.0.0.6/ma1.png

http://10.0.0.6/ma2.jpg
2.34
import urllib.request, socket, re, sys, os

# 定义文件保存路径

targetPath = "E:\\"

def saveFile(path):

    # 检测当前路径的有效性

    if not os.path.isdir(targetPath):

        os.mkdir(targetPath)

        # 设置每个图片的路径

    pos = path.rindex('/')

    t = os.path.join(targetPath, path[pos + 1:])

    return t

# 用if __name__ == '__main__'来判断是否是在直接运行该.py文件

# 网址

url = "http://10.0.0.6/"

headers = {

    'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) '                            'Chrome/51.0.2704.63 Safari/537.36'

}

req = urllib.request.Request(url=url, headers=headers)

res = urllib.request.urlopen(req)

data = res.read()

for link,t in set(re.findall(r'(http:[^s]*?(jpg|png|gif))', str(data))):

   print(link)

   try:

       urllib.request.urlretrieve(link, saveFile(link))

   except:

       print('失败')
结果:
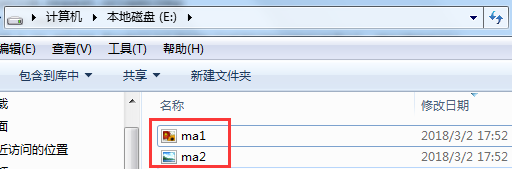
http://10.0.0.6/ma2.jpg

http://10.0.0.6/ma1.png
2.4登录知乎

参考:http://blog.csdn.net/fly_yr/article/details/51535676
shell及Python爬虫实例展示的更多相关文章
- Python爬虫实例:爬取B站《工作细胞》短评——异步加载信息的爬取
很多网页的信息都是通过异步加载的,本文就举例讨论下此类网页的抓取. <工作细胞>最近比较火,bilibili 上目前的短评已经有17000多条. 先看分析下页面 右边 li 标签中的就是短 ...
- Python爬虫实例:爬取猫眼电影——破解字体反爬
字体反爬 字体反爬也就是自定义字体反爬,通过调用自定义的字体文件来渲染网页中的文字,而网页中的文字不再是文字,而是相应的字体编码,通过复制或者简单的采集是无法采集到编码后的文字内容的. 现在貌似不少网 ...
- Python爬虫实例:爬取豆瓣Top250
入门第一个爬虫一般都是爬这个,实在是太简单.用了 requests 和 bs4 库. 1.检查网页元素,提取所需要的信息并保存.这个用 bs4 就可以,前面的文章中已经有详细的用法阐述. 2.找到下一 ...
- Python 爬虫实例
下面是我写的一个简单爬虫实例 1.定义函数读取html网页的源代码 2.从源代码通过正则表达式挑选出自己需要获取的内容 3.序列中的htm依次写到d盘 #!/usr/bin/python import ...
- Python爬虫实例:糗百
看了下python爬虫用法,正则匹配过滤对应字段,这里进行最强外功:copy大法实践 一开始是直接从参考链接复制粘贴的,发现由于糗百改版导致失败,这里对新版html分析后进行了简单改进,把整理过程记录 ...
- python爬虫实例大全
WechatSogou [1]- 微信公众号爬虫.基于搜狗微信搜索的微信公众号爬虫接口,可以扩展成基于搜狗搜索的爬虫,返回结果是列表,每一项均是公众号具体信息字典. DouBanSpider [2]- ...
- python爬虫实例——爬取歌单
学习自<<从零开始学python网络爬虫>> 爬取酷狗歌单,保存入csv文件 直接上源代码:(含注释) import requests #用于请求网页获取网页数据 from b ...
- Python 爬虫实例(爬百度百科词条)
爬虫是一个自动提取网页的程序,它为搜索引擎从万维网上下载网页,是搜索引擎的重要组成.爬虫从一个或若干初始网页的URL开始,获得初始网页上的URL,在抓取网页的过程中,不断从当前页面上抽取新的URL放入 ...
- Python爬虫实例(五) requests+flask构建自己的电影库
目标任务:使用requests抓取电影网站信息和下载链接保存到数据库中,然后使用flask做数据展示. 爬取的网站在这里 最终效果如下: 主页: 可以进行搜索:输入水形物语 点击标题进入详情页: 爬虫 ...
随机推荐
- 初试Taro
今天有空在github上发现一个好东西--Taro. 京东的Team打造的多端开发解决方案.·一套代码编译成可以在多端运行代码,(小程序,RN,H5)看到这里我就不淡定了. 这个意思就是,你照常写你的 ...
- 初学oracle遇到些小麻烦
前段时间学习了Oracle数据库,在超级用户sys下运行一些基本语句的时候都没有发现有什么问题,但是却发现不能执行删除字段的的命令,老师检查说可能是权限不够,但是在授权之后依旧不能完成该语句,所以就另 ...
- redis sentinel搭建以及在jedis中使用
一.redis主从搭建 1.搭建redis master 1>redis安装 mkdir -p /usr/local/webserver/redis //安装目录 cd /usr/local/w ...
- ios学习路线—Objective-C(堆(heap)和栈(stack))
Objective-C的对象在内存中是以堆的方式分配空间的,并且堆内存是由你释放的,即release 栈由编译器管理自动释放的,在方法中(函数体)定义的变量通常是在栈内,因此如果你的变量要跨函数的话就 ...
- xcode 快捷键大全、XCode常用快捷键图文介绍
其实就是设置里面的快捷键变成了文字版,刚开始用Xcode是不是发现以前熟悉的开发环境的快捷键都不能用了?怎么快捷运行,停止,编辑等等.都不一样了.快速的掌握这些快捷键,能提供开发的效率. 其实快捷键在 ...
- export default 和 export的使用方式
注意:1.export default 向外暴露的成员,可以使用任意的变量来接收 2.在一个模块中 ; export default 只允许向外暴露一次 3.在一个模块中 ; 可以同时使用 expor ...
- python 如何在列表list,字典dict,集合set 中根据条件筛选数据
from random import randint """ list 过滤掉负数 """ data = [randint(-10, 10) ...
- web3.js_1.x.x--API(二)/合约部署与事件调用
web3.js_1.x.x的使用和网上查到的官方文档有些不同,我对经常使用到的API进行一些整理,希望能帮到大家 转载博客:http://www.cnblogs.com/baizx/p/7474774 ...
- c#winform使用WebBrowser 大全
C# WinForm WebBrowser (一) MSDN资料 1.主要用途:使用户可以在窗体中导航网页. 2.注意:WebBrowser 控件会占用大量资源.使用完该控件后一定要调用 Dispos ...
- Flask初见
Flask是一个使用 Python 编写的轻量级 Web 应用框架.其 WSIG工具箱采用 Werkzeug ,模板引擎则使用 Jinja2 .Flask使用 BSD 授权. Flask也被称为 “m ...