
爬虫多次爬取时候cookie的存储用于登入
一.用requests模块自动保存(保存缓存中)
构建一个session对象session = requests.session()
用构建的session代替requests进行访问他就会自动存啦
import requests

session = requests.session()

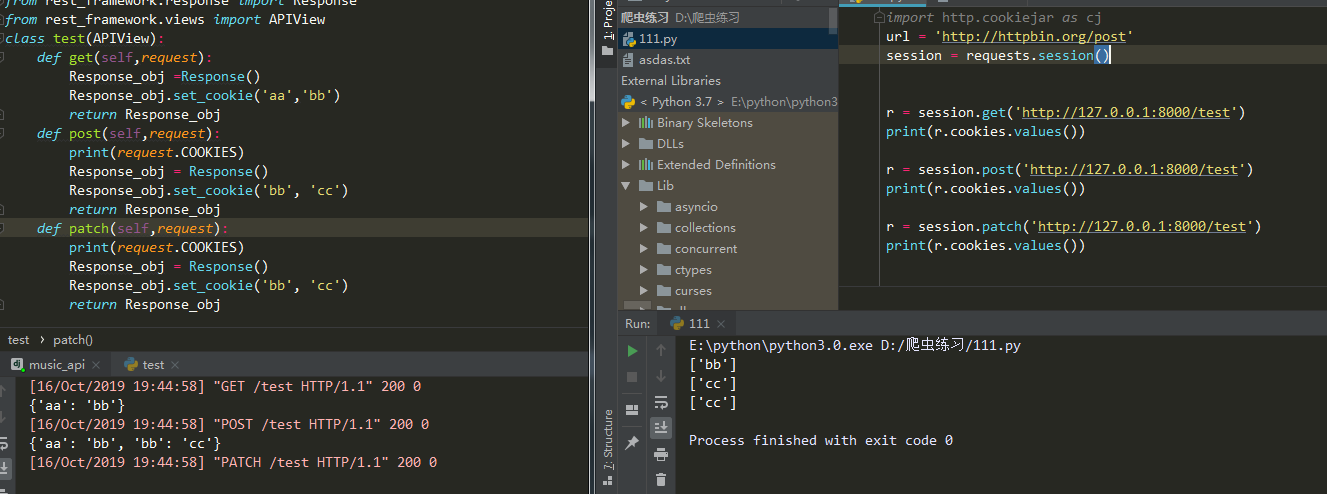
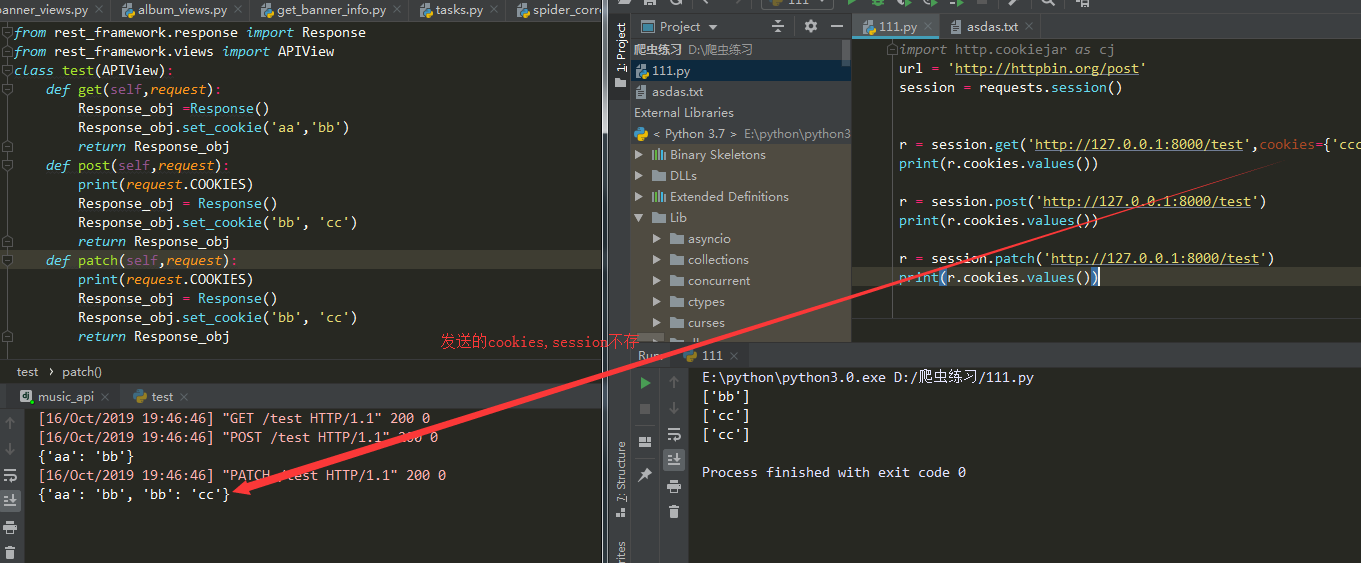
r = session.get(......)   #他会存返回的cookies不会存发送的cookies

r = session.post(......)  #在请求同一url他会把存的cookies发送过去
注意点
- 只存响应的cookie
- 不存发送请求时候带的cookie
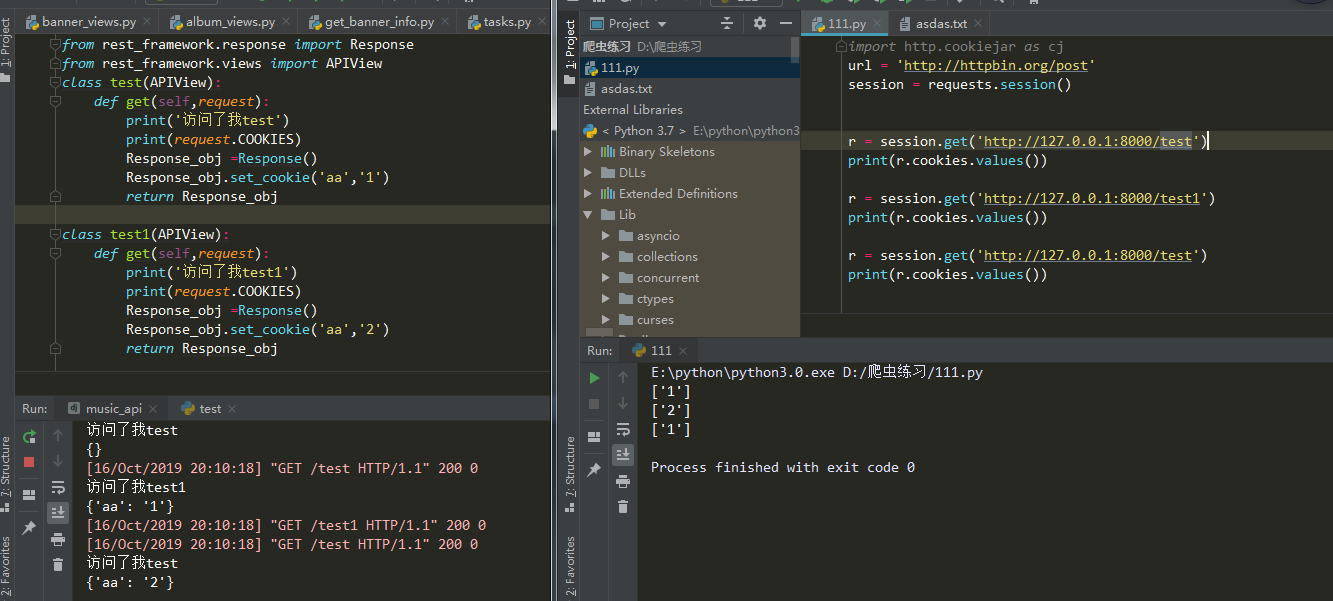
- 不同url没有影响
- cookie名字一样会覆盖掉
原因自己看下面自己看哈,有问题可以私聊我

二.将cookie存本地
1.基于session(推荐使用代码少哈哈)
import requests

from  http import  cookiejar

session =requests.session()

session.cookies = cookiejar.LWPCookieJar()  #MozillaCookieJar或LWPCookieJar。

session.cookies.save(filename='1.txt')   //存cookie

session.cookies.load(filename='1.txt')   //读cookie
2.普通请求把cookies存本地
这个参照https://www.cnblogs.com/fu-yong/p/9032902.html
第一次访问
from urllib import request,parse

from http import cookiejar

# 创建filecookiejar实例对象

# 它需要一个参数,既cookie保存的位置

filename = 'cookie.txt'

cookie = cookiejar.FileCookieJar(filename)

# 根据创建的cookie生成cookie的管理器

cookie_handle = request.HTTPCookieProcessor(cookie)

# 创建http请求管理器

http_handle = request.HTTPHandler()

# 创建https管理器

https_handle = request.HTTPSHandler()

# 创建求求管理器,将上面3个管理器作为参数属性

# 有了opener,就可以替代urlopen来获取请求了

opener =  request.build_opener(cookie_handle,http_handle,https_handle)

# 登录url,需要从登录form的action属性中获取

url = 'xxxxxxxxxxxxxx'

# 登录所需要的数据,数据为字典形式,

# 此键值需要从form扁担中对应的input的name属性中获取

data = {

    'email':'xxxx',

    'password':'xxxxx'

}

# 将数据解析成urlencode格式

data = parse.urlencode(data)

req = request.Request(url,data=data)

# 正常是用request.urlopen(),这里用opener.open()发起请求

response = opener.open(req)

# 保存cookie文件

cookie.save()
第二次访问
from urllib import request,parse

from http import cookiejar

# 创建cookiejar实例对象

cookie = cookiejar.FileCookieJar()

# 读取已经保存的cookie文件

# 读取之后,就无需登录,直接访问主页即可

cookie.load('cookie.txt')

# 根据创建的cookie生成cookie的管理器

cookie_handle = request.HTTPCookieProcessor(cookie)

# 创建http请求管理器

http_handle = request.HTTPHandler()

# 创建https管理器

https_handle = request.HTTPSHandler()

# 创建求求管理器,将上面3个管理器作为参数属性

# 有了opener,就可以替代urlopen来获取请求了

opener =  request.build_opener(cookie_handle,http_handle,https_handle)

url = 'http://xxxxxx'

res = opener.open(url)

html = res.read().decode()

with open('renren.html','w') as f:

        f.write(html)
爬虫多次爬取时候cookie的存储用于登入的更多相关文章
- 【转载】教你分分钟学会用python爬虫框架Scrapy爬取心目中的女神
原文:教你分分钟学会用python爬虫框架Scrapy爬取心目中的女神 本博文将带领你从入门到精通爬虫框架Scrapy,最终具备爬取任何网页的数据的能力.本文以校花网为例进行爬取,校花网:http:/ ...
- Python网络爬虫与如何爬取段子的项目实例
一.网络爬虫 Python爬虫开发工程师,从网站某一个页面(通常是首页)开始,读取网页的内容,找到在网页中的其它链接地址,然后通过这些链接地址寻找下一个网页,这样一直循环下去,直到把这个网站所有的网页 ...
- Python爬虫实例:爬取B站《工作细胞》短评——异步加载信息的爬取
很多网页的信息都是通过异步加载的,本文就举例讨论下此类网页的抓取. <工作细胞>最近比较火,bilibili 上目前的短评已经有17000多条. 先看分析下页面 右边 li 标签中的就是短 ...
- Python爬虫实例:爬取猫眼电影——破解字体反爬
字体反爬 字体反爬也就是自定义字体反爬,通过调用自定义的字体文件来渲染网页中的文字,而网页中的文字不再是文字,而是相应的字体编码,通过复制或者简单的采集是无法采集到编码后的文字内容的. 现在貌似不少网 ...
- Python爬虫实例:爬取豆瓣Top250
入门第一个爬虫一般都是爬这个,实在是太简单.用了 requests 和 bs4 库. 1.检查网页元素,提取所需要的信息并保存.这个用 bs4 就可以,前面的文章中已经有详细的用法阐述. 2.找到下一 ...
- 爬虫实战——Scrapy爬取伯乐在线所有文章
Scrapy简单介绍及爬取伯乐在线所有文章 一.简说安装相关环境及依赖包 1.安装Python(2或3都行,我这里用的是3) 2.虚拟环境搭建: 依赖包:virtualenv,virtualenvwr ...
- python爬虫-基础入门-爬取整个网站《3》
python爬虫-基础入门-爬取整个网站<3> 描述: 前两章粗略的讲述了python2.python3爬取整个网站,这章节简单的记录一下python2.python3的区别 python ...
- python爬虫-基础入门-爬取整个网站《2》
python爬虫-基础入门-爬取整个网站<2> 描述: 开场白已在<python爬虫-基础入门-爬取整个网站<1>>中描述过了,这里不在描述,只附上 python3 ...
- python爬虫-基础入门-爬取整个网站《1》
python爬虫-基础入门-爬取整个网站<1> 描述: 使用环境:python2.7.15 ,开发工具:pycharm,现爬取一个网站页面(http://www.baidu.com)所有数 ...
随机推荐
- vue中使用时间插件、vue使用laydate
<input id="time1" readonly="readonly" placeholder="这里选择时间" v-model= ...
- mongo helper
import datetime import pymongo import click # 数据库基本信息 db_configs = { 'type': 'mongo', 'host': '127.0 ...
- supervisor更改某项目配置后 需要重新启动才有效
在linux服务器上部署了node项目,使用supervisor进行管理,supervisor是个好工具,具体介绍见这里about supervisor 梗概了该项目对的某些配置后,重新启动项目,发现 ...
- Django实现自动发布(1数据模型)
公司成立之初,业务量较小,一个程序包揽了所有的业务逻辑,此时服务器数量少,上线简单,基本开发-测试-上线都是由开发人员完成. 随着业务量逐渐上升,功能增多,代码量增大,而单一功能上线需要重新编译整个程 ...
- 【转】Android Fastboot 与 Recovery 和刷机
1. 首先来看下Android系统的分区: Android系统的分区.jpg Android分区解释.png 安卓系统一般把rom芯片分成7个区,如果再加上内置sd卡这个分区,就是8个: hb ...
- tomcat高并发优化的参数优化并查看tomcat线程数
在Tomcat配置文件conf下面 server.xml 中的配置中和连接数相关的参数有: minProcessors:最小空闲连接线程数,用于提高系统处理性能,默认值为10 maxProcessor ...
- Java基础 awt Graphics2D 生成矩形图片并向内写入字符串
JDK :OpenJDK-11 OS :CentOS 7.6.1810 IDE :Eclipse 2019‑03 typesetting :Markdown code ...
- Spark SQL里concat_ws和collect_set的作用
concat_ws: 用指定的字符连接字符串 例如: 连接字符串: concat_ws("_", field1, field2),输出结果将会是:“field1_field2”. ...
- git 本地删除修改文件后从远程拉取
单个文件 git checkout a.php 当前目录 git checkout .
- EasyDSS高性能RTMP、HLS(m3u8)、HTTP-FLV、RTSP流媒体服务器版本打包方法介绍
EasyDSS流媒体解决方案是一套集流媒体点播.转码.管理.直播.录像.检索.时移回看于一体的一套完整的商用流媒体解决方案.EasyDSS软件以压缩包的形式提供给客户使用,同时支持Linux和 Win ...