
Python爬虫教程-13-爬虫使用cookie爬取登录后的页面(人人网)(下)
Python爬虫教程-13-爬虫使用cookie爬取登录后的页面(下)
- 自动使用cookie的方法,告别手动拷贝cookie
- http模块包含一些关于cookie的模块,通过他们我们可以自动的使用cookie
- CookieJar- 管理存储Cookie,向传出的http请求添加cookie
- 这里Cookie存储在内存中,CookieJar实例回收后cookie将消失
- FileCookieJar(filename, delayload=None, policy=None)

  -   使用文件管理cookie

  -  filename是保存cookie的文件

- MozillaCookieJar(filename, delayload=None, policy=None)

  -  创建Mocilla浏览器cookie.txt兼容的FileCookieJar实例

  -

  -  火狐Firefox浏览器需要单独处理

- LwpCookieJar(filename, delayload=None, policy=None)

  -  创建于libww-per标准兼容的Set-Cookie3格式的FileCookieJar

-  它们之间的关系: CookieJar-->FileCookieJar-->MozillaCookieJar & LwpCookieJar
利用CookieJar访问人人网
- 自动使用cookie登录,使用步骤:
- 1.打开登录页面后自动通过用户名密码登录
- 2.自动提取反馈回来的cookie
- 3.利用提取的cookie登录个人信息页面
- 创建cookiejar实例
- 生成cookie的管理器
- 创建http请求管理器
- 创建https请求的管理器
- 创建请求管理器
- 通过输入用户名和密码,获取cookie
- 案例13cookiejar文件:https://xpwi.github.io/py/py爬虫/py13cookiejar.py
# 使用cookiejar完整代码

from urllib import request,parse

from http import cookiejar

# 创建cookiejar的实例

cookie = cookiejar.CookieJar()

# 常见cookie的管理器

cookie_handler = request.HTTPCookieProcessor(cookie)

# 创建http请求的管理器

http_handler = request.HTTPHandler()

# 生成https管理器

https_handler = request.HTTPSHandler()

# 创建请求管理器

opener = request.build_opener(http_handler,https_handler,cookie_handler)

def login():

    # 负责首次登录,输入用户名和密码,用来获取cookie

    url = 'http://www.renren.com/PLogin.do'

    id = input('请输入用户名:')

    pw = input('请输入密码:')

    data = {

        # 从input标签的name获取参数的key,value由输入获取

        "email": id,

        "password": pw

    }

    # 把数据进行编码

    data = parse.urlencode(data)

    # 创建一个请求对象

    req = request.Request(url,data=data.encode('utf-8'))

    # 使用opener发起请求

    rsp = opener.open(req)

# 以上代码就可以进一步获取cookie了,cookie在哪呢?cookie在opener里

def getHomePage():

    # 地址是用在浏览器登录后的个人信息页地址

    url = "http://www.renren.com/967487029/profile"

    # 如果已经执行login函数,则opener自动已经包含cookie

    rsp = opener.open(url)

    html = rsp.read().decode()

    with open("rsp1.html", "w", encoding="utf-8")as f:

        # 将爬取的页面

        print(html)

        f.write(html)

if __name__ == '__main__':

    login()

    getHomePage()
运行结果
看到自己的个人信息就是说明登录成功了
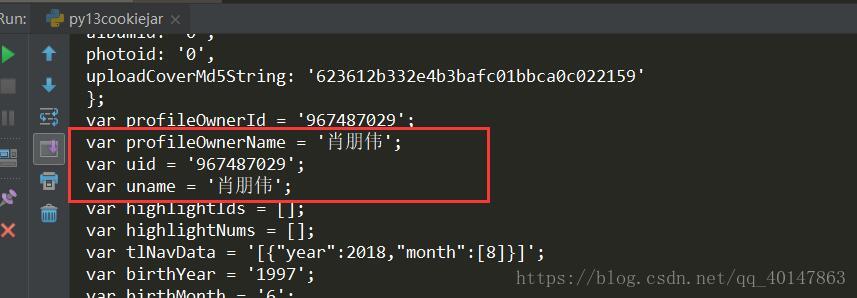
补充:在爬虫代码输入用户名和密码的使用方法
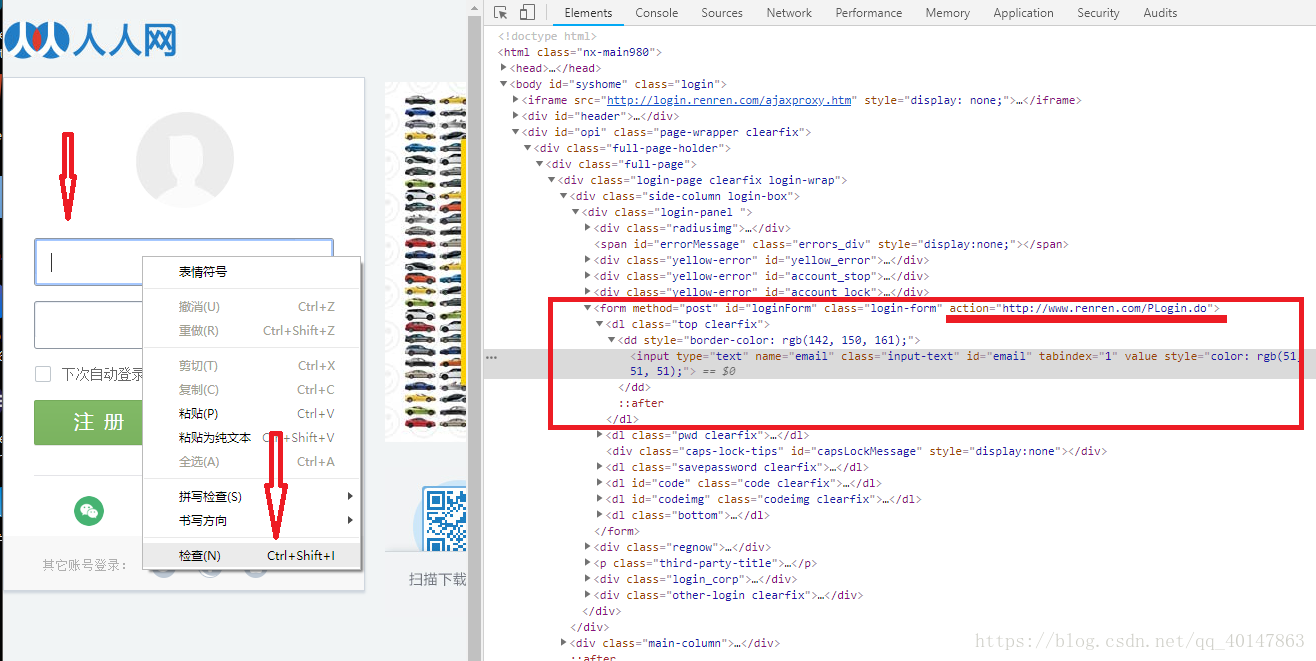
- 1.打开网站首页,登录表单页面
- 2.在输入用户名和密码的地方,【右键检查】,或者查看源代码
- 3.找到登录表单【form标签的action属性】,拷贝地址
- 4.提示:如果不能直接拷贝,【双击】地址,Ctrl+C
- 操作截图:
- 5.找到用户名和密码的【input标签的name属性】,构建参数时使用
- 6.然后在代码中,构建data参数,模拟post请求
# 代码片段

url = 'http://www.renren.com/PLogin.do'

    data = {

        # 参数使用正确的用户名密码

        "email": "18322295195",

        "password": "oaix51607991"

    }

    # 把数据进行编码

    data = parse.urlencode(data)
爬虫使用cookie,自动获取cookie解介绍到这里了
更多文章链接:Python 爬虫随笔
- 本笔记不允许任何个人和组织转载
Python爬虫教程-13-爬虫使用cookie爬取登录后的页面(人人网)(下)的更多相关文章
- Python爬虫教程-12-爬虫使用cookie爬取登录后的页面(人人网)(上)
Python爬虫教程-12-爬虫使用cookie(上) 爬虫关于cookie和session,由于http协议无记忆性,比如说登录淘宝网站的浏览记录,下次打开是不能直接记忆下来的,后来就有了cooki ...
- Python之爬虫(二十一) Scrapy爬取所有知乎用户信息(下)
在上一篇文章中主要写了关于爬虫过程的分析,下面是代码的实现,完整代码在:https://github.com/pythonsite/spider items中的代码主要是我们要爬取的字段的定义 cla ...
- 爬虫(二)Python网络爬虫相关基础概念、爬取get请求的页面数据
什么是爬虫 爬虫就是通过编写程序模拟浏览器上网,然后让其去互联网上抓取数据的过程. 哪些语言可以实现爬虫 1.php:可以实现爬虫.php被号称是全世界最优美的语言(当然是其自己号称的,就是王婆 ...
- Python爬虫教程-32-Scrapy 爬虫框架项目 Settings.py 介绍
本篇介绍项目开发的过程中,对 Setting 文件的配置和使用 Python爬虫教程-32-Scrapy 爬虫框架项目 Settings.py 介绍 settings.py 文件的使用 想要详细查看 ...
- Python爬虫教程-30-Scrapy 爬虫框架介绍
从本篇开始学习 Scrapy 爬虫框架 Python爬虫教程-30-Scrapy 爬虫框架介绍 框架:框架就是对于相同的相似的部分,代码做到不出错,而我们就可以将注意力放到我们自己的部分了 常见爬虫框 ...
- python网络爬虫之解析网页的BeautifulSoup(爬取电影图片)[三]
目录 前言 一.BeautifulSoup的基本语法 二.爬取网页图片 扩展学习 后记 前言 本章同样是解析一个网页的结构信息 在上章内容中(python网络爬虫之解析网页的正则表达式(爬取4k动漫图 ...
- Python爬虫实战(2):爬取京东商品列表
1,引言 在上一篇<Python爬虫实战:爬取Drupal论坛帖子列表>,爬取了一个用Drupal做的论坛,是静态页面,抓取比较容易,即使直接解析html源文件都可以抓取到需要的内容.相反 ...
- Python网络爬虫第三弹《爬取get请求的页面数据》
一.urllib库 urllib是Python自带的一个用于爬虫的库,其主要作用就是可以通过代码模拟浏览器发送请求.其常被用到的子模块在Python3中的为urllib.request和urllib. ...
- python网络爬虫《爬取get请求的页面数据》
一.urllib库 urllib是python自带的一个用于爬虫的库,其主要作用就是可以通过代码模拟浏览器发送请求.其常被用到的子模块在python3中的为urllib.request和urllib. ...
随机推荐
- java.math.BigDecimal cannot be cast to java.lang.Integer
问题来源: 在数据库中查询一个列表的长度时,需要转换为Integer类型,我刚开始直接转就报错了.因为在数据库中用count(*) 聚合函数返回的值类型为BigDecimal,不能直接转换为Integ ...
- 【Alpha】Scrum Meeting 0&1
前言 第0次会议和第1次会议分别在4月1日和4月2日21:00由PM在大运村一公寓3层召开. 第0次时长50min,主要明确了接下来的任务,对工作进行了分配. 第1次会议时长20min,调研了当日工作 ...
- c++ 用 0x3f3f3f3f 设定最大int值的优点
在许多算法中都要用到一个常量来表示最大值,例如:寻找一个最小数,就要先设定一个值a,如果比a小,a就等于这个数:再如,最短路径中基本的松弛操作: 0 在c++中可以用memset() 来初始化数组成最 ...
- 51nod 1812 树的双直径 题解【树形DP】【贪心】
老了-稍微麻烦一点的树形DP都想不到了. 题目描述 给定一棵树,边权是整数 \(c_i\) ,找出两条不相交的链(没有公共点),使得链长的乘积最大(链长定义为这条链上所有边的权值之和,如果这条链只有 ...
- [短期持续更新]Codeforces 构造题一览
说实话我觉得做这种题很没意思(不够硬核), 可是人有短板终究是要补的...起码这种类型补起来相对简单 所以还是把先前准备好的专题放下吧,做点实现上比较休闲的题 ps.为了精简篇幅,代码全部丢到ubun ...
- DFS-20190206
找出所有方案 排列和组合问题 排列: https://www.lintcode.com/problem/combination-sum/description public class Solutio ...
- 关于cmdbuild
哪位大神用过cmdbuild,网上的资料非常少,而且都是关于如何安装的,就在这少只又少的文章里,居然还都是互抄的,哎!!!
- Java学习之路(二):关键字和变量,运算符
关于关键字的一个概述 Java的关键字对Java的编译器有特殊的意义,他们用来表示一种数据类型,或者表示程序的结构,关键字不能用做变量名.方法名.类名.包名. Java常见的关键字 标识符 什么是标识 ...
- android 小工具:pc 上用 curl 命令打开手机浏览器,浏览指定网址
测试 API 时或其它情况经常需要在手机浏览器中输入 url 一长串的 url 输起来真是麻烦 AirDroid 很强大也不用数据线,但有时老断开连接,不是很爽.发到手机 qq 吧还得手动粘贴 所以自 ...
- Maven是什么
一.Maven是什么 Maven是一个Apache公司的开源项目,是项目构建工具.用来管理依赖. 1.Maven的好处 使用maven可以在项目中不用导入项目依赖的jar包,省去了下载和导入jar包的 ...