
浅谈HashMap与线程安全 (JDK1.8)
public class HashMap<K,V> extends AbstractMap<K,V>

    implements Map<K,V>, Cloneable, Serializable {

/**

 * The maximum capacity, used if a higher value is implicitly specified

 * by either of the constructors with arguments.

 * MUST be a power of two <= 1<<30.

 */

static final int MAXIMUM_CAPACITY = 1 << 30;

static class Node<K,V> implements Map.Entry<K,V> {

 final int hash;

 final K key;

 V value;

 Node<K,V> next;

 // ....

}

/**

 * The table, initialized on first use, and resized as

 * necessary. When allocated, length is always a power of two.

 * (We also tolerate length zero in some operations to allow

 * bootstrapping mechanics that are currently not needed.)

 */

transient Node<K,V>[] table;

//....

}
HashMap 内部存储使用了一个 Node 数组(默认大小是16),每个Node都是一个链表。每个链表存储相同索引的元素。
static final int TREEIFY_THRESHOLD = 8;

static final int UNTREEIFY_THRESHOLD = 6;
从Java 8开始,HashMap(ConcurrentHashMap以及LinkedHashMap)在处理频繁冲突时,为了提升性能将使用平衡树来代替链表,当同一hash桶中的元素数量超过特定的值(TREEIFY_THRESHOLD )便会由链表切换到平衡树,这会将get()方法的性能从O(n)提高到O(logn)。
/**

 * The default initial capacity - MUST be a power of two.

 */

static final int DEFAULT_INITIAL_CAPACITY = 1 << 4; // aka 16

/**

 * The load factor used when none specified in constructor.

 */

static final float DEFAULT_LOAD_FACTOR = 0.75f;
HashMap 内部的 Node 数组默认的大小是16(DEFAULT_INITIAL_CAPACITY )。
- Hashtable
- ConcurrentHashMap
- Synchronized Map
//Hashtable

Map<String, String> hashtable = new Hashtable<>();

//synchronizedMap

Map<String, String> synchronizedHashMap = Collections.synchronizedMap(new HashMap<String, String>());

//ConcurrentHashMap

Map<String, String> concurrentHashMap = new ConcurrentHashMap<>();
Hashtable (deprecate)
public synchronized V get(Object key) {...}

public synchronized V put(K key, V value) {...}
所以当一个线程访问 HashTable 的同步方法时,其他线程如果也要访问同步方法,会被阻塞住。因此Hashtable效率很低,基本被废弃。
/** For serialization compatibility. */

    private static final ObjectStreamField[] serialPersistentFields = {

        new ObjectStreamField("segments", Segment[].class),

        new ObjectStreamField("segmentMask", Integer.TYPE),

        new ObjectStreamField("segmentShift", Integer.TYPE)

    };
    负数代表正在进行初始化或扩容操作

    -1代表正在初始化

    -N 表示有N-1个线程正在进行扩容操作

    正数或0代表hash表还没有被初始化,这个数值表示初始化或下一次进行扩容的大小
/**

 * Table initialization and resizing control. When negative, the

 * table is being initialized or resized: -1 for initialization,

 * else -(1 + the number of active resizing threads). Otherwise,

 * when table is null, holds the initial table size to use upon

 * creation, or 0 for default. After initialization, holds the

 * next element count value upon which to resize the table.

 */

private transient volatile int sizeCtl;

static class Node<K,V> implements Map.Entry<K,V> {

 final int hash;

 final K key;

 volatile V val;

 volatile Node<K,V> next;

 public final V setValue(V value) {

  throw new UnsupportedOperationException();

 }

}

/**

 * Virtualized support for map.get(); overridden in subclasses.

 */

Node<K,V> find(int h, Object k) {

 Node<K,V> e = this;

 if (k != null) {

 do {

  K ek;

  if (e.hash == h &&

  ((ek = e.key) == k || (ek != null && k.equals(ek))))

  return e;

  } while ((e = e.next) != null);

 }

 return null;

}
private static class SynchronizedMap<K,V>

 implements Map<K,V>, Serializable {

 private final Map<K,V> m; // Backing Map

 final Object mutex; // Object on which to synchronize

 public int size() {

 synchronized (mutex) {return m.size();}

}

public boolean isEmpty() {

 synchronized (mutex) {return m.isEmpty();}

}

public boolean containsKey(Object key) {

 synchronized (mutex) {return m.containsKey(key);}

}

public boolean containsValue(Object value) {

 synchronized (mutex) {return m.containsValue(value);}

}

public V get(Object key) {

 synchronized (mutex) {return m.get(key);}

}

public V put(K key, V value) {

 synchronized (mutex) {return m.put(key, value);}

}

public V remove(Object key) {

 synchronized (mutex) {return m.remove(key);}

}

public void putAll(Map<? extends K, ? extends V> map) {

 synchronized (mutex) {m.putAll(map);}

}

public void clear() {

 synchronized (mutex) {m.clear();}

}

//...

}
ExecutorService 来并发运行5个线程,每个线程添加/获取500K个元素,比较其用时多少。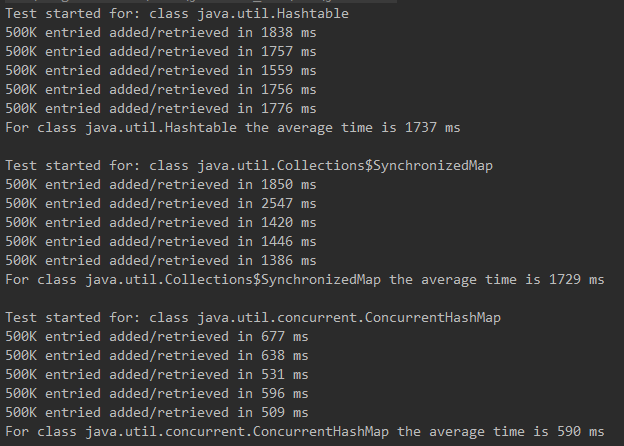
浅谈HashMap与线程安全 (JDK1.8)的更多相关文章
- Java重点之小白解析--浅谈HashMap与HashTable
这是一个面试经常遇到的知识点,无论什么公司这个知识点几乎是考小白必备,为什么呢?因为这玩意儿太特么常见了,常见到你写一百行代码,都能用到好几次,不问这个问哪个.so!本小白网罗天下HashMap与Ha ...
- 浅谈HashMap的实现原理
1. HashMap概述: HashMap是基于哈希表的Map接口的非同步实现.此实现提供所有可选的映射操作,并允许使用null值和null键.此类不保证映射的顺序,特别是它不保证该顺序恒久不变 ...
- 浅谈HashMap的内部实现
权衡时空 HashMap是以键值对的方式存储数据的. 如果没有内存限制,那我直接用哈希Map的键作为数组的索引,取的时候直接按索引get就行了,可是地价那么贵,哪里有无限制的地盘呢. 如果没有时间限制 ...
- 转:浅谈SimpleDateFormat的线程安全问题
转自:https://blog.csdn.net/weixin_38810239/article/details/79941964 在实际项目中,我们经常需要将日期在String和Date之间做转化, ...
- JAVA容器-浅谈HashMap的实现原理
概述 HashMap是通过数组+链表的方式实现的,由于HashMap的链表也是采用数组方式,我就修改直接利用LinkedList实现,简单模拟一下. 1.Key.Value的存取方式. 2.HashM ...
- 浅谈java中线程和操作系统线程
在聊线程之前,我们先了解一下操作系统线程的发展历程,在最初的时候,操作系统没有进程线程一说,执行程序都是串行方式执行,就像一个队列一样,先执行完排在前面的,再去执行后面的程序,这样的话很多程序的响应就 ...
- 【JDK源码分析】浅谈HashMap的原理
这篇文章给出了这样的一道面试题: 在 HashMap 中存放的一系列键值对,其中键为某个我们自定义的类型.放入 HashMap 后,我们在外部把某一个 key 的属性进行更改,然后我们再用这个 key ...
- struts 2学习笔记—浅谈struts的线程安全
Sruts 2工作流程: Struts 1中所有的Action都只有一个实例,该Action实例会被反复使用.通过上面Struts 2 的工作流程的红色字体部分我们可以清楚看到Struts 2中每个A ...
- 【Java】浅谈HashMap
HashMap是常用的集合类,以Key-Value形式存储值.下面一起从代码层面理解它的实现. 构造方法 它有好几个构造方法,但几乎都是调此构造方法: public HashMap(int initi ...
随机推荐
- Android 初识Retrofit
什么是 Retrofit ? Retrofit 是一套 RESTful 架构的 Android(Java) 客户端实现,基于注解,提供 JSON to POJO(Plain Ordinary Java ...
- 【转】修复关于apache-xampp的问题:Port 443 in use by “vmware-hostd.exe”!
在电脑里装了VMware后,再要装xampp,十有八九就会出现这个问题: 11:23:37 [Apache] Problem detected! 11:23:37 [Apache] ...
- 定制UITabBar显示样式
定制UITabBar显示样式 思路是这样子的: 1. 初始化UITabBarController,并装载进来几个其他的ViewController 2. 获取每个控制器的UITabBarItem 3. ...
- Ubuntu双系统安装过程中遇到的问题
1.在第六步选择时区的时候,会报错,这时候可以选择断开网络(取消右上角的网络选项)! 2.用easybcd添加启动项以后,无法进入,F12进入BIOS,选择Ubuntu进入,因为以前的BIOS BOO ...
- Redis添加访问密码
进入Redis的安装目录,找到redis.conf文件. 1.修改密码:使用vi命令打开redis.conf文件,先使用字符匹配查找到requirepass foobared对应的位置, 然后修改fo ...
- php curl 总结
1 curl post curl -X POST http://localhost/ -d '{"data":{"name":"hheh" ...
- Effective Java 第二版 Enum
/** * Effective Java 第二版 * 第30条:用enum代替int常量 */ import java.util.HashMap;import java.util.Map; publi ...
- C++中类与结构体的区别
相信有一点专业知识的人都知道,C语言是一种结构化语言.它层次清晰,便于按模块化方式组织程序,易于调试和维护.在很大程度上,标准C++是标准C的超集.实际上,所有C程序也是C++程序,然而,两者之间有少 ...
- 小技巧:Mac下Metasploit渗透Oracle环境的搭建
Metasploit是一款开源的安全漏洞检测工具,可以帮助安全和IT专业人士识别安全性问题,验证漏洞的缓解措施,并管理专家驱动的安全性进行评估,提供真正的安全风险情报.这些功能包括智能开发,密码审计, ...
- WEB开发的jsp例子标签库(jstl)的使用
<!-- e1 --> <%@ page language="java" contentType="text/html; charset=UTF-8&q ...