
Python之爬虫(十七) Scrapy框架中Spiders用法
Spider类定义了如何爬去某个网站,包括爬取的动作以及如何从网页内容中提取结构化的数据,总的来说spider就是定义爬取的动作以及分析某个网页
工作流程分析
- 以初始的URL初始化Request,并设置回调函数,当该request下载完毕并返回时,将生成response,并作为参数传给回调函数. spider中初始的requesst是通过start_requests()来获取的。start_requests()获取 start_urls中的URL,并以parse以回调函数生成Request
- 在回调函数内分析返回的网页内容,可以返回Item对象,或者Dict,或者Request,以及是一个包含三者的可迭代的容器,返回的Request对象之后会经过Scrapy处理,下载相应的内容,并调用设置的callback函数
- 在回调函数内,可以通过lxml,bs4,xpath,css等方法获取我们想要的内容生成item
- 最后将item传递给Pipeline处理
我们以通过简单的分析源码来理解
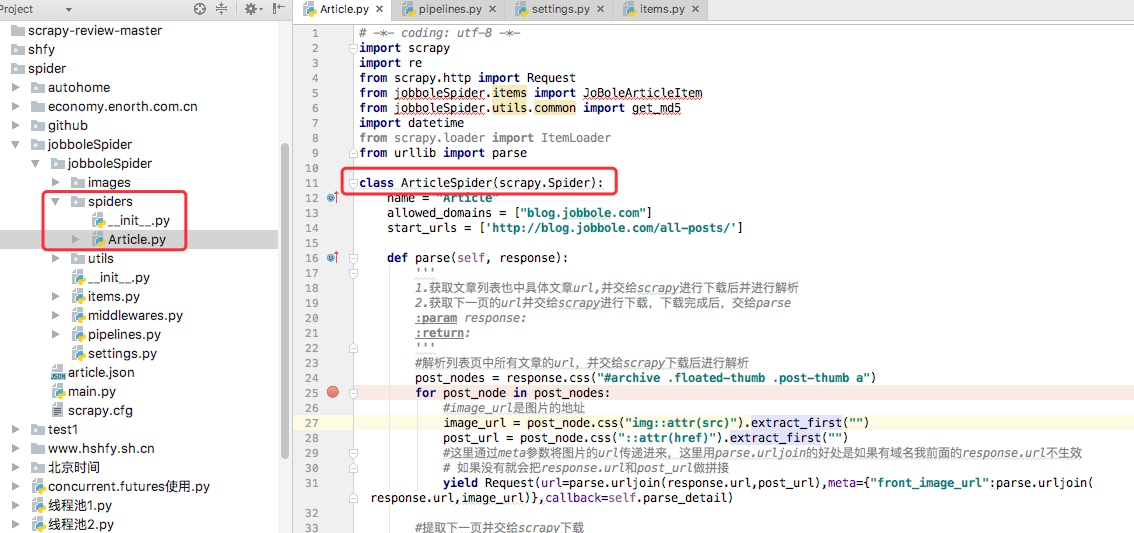
我通常在写spiders下写爬虫的时候,我们并没有写start_requests来处理start_urls中的url,这是因为我们在继承的scrapy.Spider中已经写过了,我们可以点开scrapy.Spider查看分析
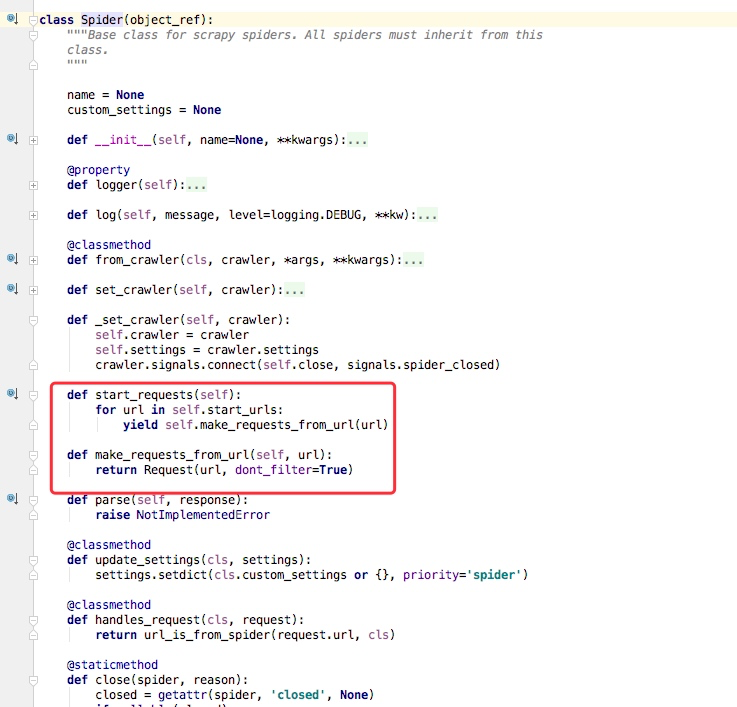
通过上述代码我们可以看到在父类里这里实现了start_requests方法,通过make_requests_from_url做了Request请求
如下图所示的一个例子,parse回调函数中的response就是父类列start_requests方法调用make_requests_from_url返回的结果,并且在parse回调函数中我们可以继续返回Request,如下属代码中yield Request()并设置回调函数。

spider内的一些常用属性
我们所有自己写的爬虫都是继承与spider.Spider这个类
name
定义爬虫名字,我们通过命令启动的时候用的就是这个名字,这个名字必须是唯一的
allowed_domains
包含了spider允许爬取的域名列表。当offsiteMiddleware启用时,域名不在列表中URL不会被访问
所以在爬虫文件中,每次生成Request请求时都会进行和这里的域名进行判断
start_urls
起始的url列表
这里会通过spider.Spider方法中会调用start_request循环请求这个列表中每个地址。
custom_settings
自定义配置,可以覆盖settings的配置,主要用于当我们对爬虫有特定需求设置的时候
设置的是以字典的方式设置:custom_settings = {}
from_crawler
这是一个类方法,我们定义这样一个类方法,可以通过crawler.settings.get()这种方式获取settings配置文件中的信息,同时这个也可以在pipeline中使用
start_requests()
这个方法必须返回一个可迭代对象,该对象包含了spider用于爬取的第一个Request请求
这个方法是在被继承的父类中spider.Spider中写的,默认是通过get请求,如果我们需要修改最开始的这个请求,可以重写这个方法,如我们想通过post请求
make_requests_from_url(url)
这个也是在父类中start_requests调用的,当然这个方法我们也可以重写
parse(response)
这个其实默认的回调函数
负责处理response并返回处理的数据以及跟进的url
该方法以及其他的Request回调函数必须返回一个包含Request或Item的可迭代对象
Python之爬虫(十七) Scrapy框架中Spiders用法的更多相关文章
- scrapy框架中Spiders用法
scrapy框架中Spiders用法 Spider类定义了如何爬去某个网站,包括爬取的动作以及如何从网页内容中提取结构化的数据 总的来说spider就是定义爬取的动作以及分析某个网页 工作流程分析 以 ...
- Python爬虫从入门到放弃(十五)之 Scrapy框架中Spiders用法
Spider类定义了如何爬去某个网站,包括爬取的动作以及如何从网页内容中提取结构化的数据,总的来说spider就是定义爬取的动作以及分析某个网页 工作流程分析 以初始的URL初始化Request,并设 ...
- Python网络爬虫之Scrapy框架(CrawlSpider)
目录 Python网络爬虫之Scrapy框架(CrawlSpider) CrawlSpider使用 爬取糗事百科糗图板块的所有页码数据 Python网络爬虫之Scrapy框架(CrawlSpider) ...
- Python逆向爬虫之scrapy框架,非常详细
爬虫系列目录 目录 Python逆向爬虫之scrapy框架,非常详细 一.爬虫入门 1.1 定义需求 1.2 需求分析 1.2.1 下载某个页面上所有的图片 1.2.2 分页 1.2.3 进行下载图片 ...
- 16.Python网络爬虫之Scrapy框架(CrawlSpider)
引入 提问:如果想要通过爬虫程序去爬取”糗百“全站数据新闻数据的话,有几种实现方法? 方法一:基于Scrapy框架中的Spider的递归爬取进行实现(Request模块递归回调parse方法). 方法 ...
- 16,Python网络爬虫之Scrapy框架(CrawlSpider)
今日概要 CrawlSpider简介 CrawlSpider使用 基于CrawlSpider爬虫文件的创建 链接提取器 规则解析器 引入 提问:如果想要通过爬虫程序去爬取”糗百“全站数据新闻数据的话, ...
- Python学习---爬虫学习[scrapy框架初识]
Scrapy Scrapy是一个框架,可以帮助我们进行创建项目,运行项目,可以帮我们下载,解析网页,同时支持cookies和自定义其他功能. Scrapy是一个为了爬取网站数据,提取结构性数据而编写的 ...
- 5-----Scrapy框架中Spiders用法
Spider类定义了如何爬去某个网站,包括爬取的动作以及如何从网页内容中提取结构化的数据,总的来说spider就是定义爬取的动作以及分析某个网页 工作流程分析 1.以初始的URL初始化Request, ...
- python爬虫之scrapy框架介绍
一.什么是Scrapy? Scrapy是一个为了爬取网站数据,提取结构性数据而编写的应用框架,非常出名,非常强悍.所谓的框架就是一个已经被集成了各种功能(高性能异步下载,队列,分布式,解析,持久化等) ...
随机推荐
- UWP实现第二字幕并且跟随系统的设置
话不多说,先看一下最终效果 系统设置默认 在系统设置里面更改字幕的显示效果 需求 要求播放器可以显示第二字幕,类似旁白的文字解释.比如片中出现了一个专业术语,这个时候观众可能有些疑惑.所以需要在屏幕上 ...
- upd套接字服务器与客户端交互C++代码示范
upd套接字服务器与客户端交互C++代码示范 // vc2_2_4UDPserver_Txwtech.cpp : 定义控制台应用程序的入口点. //服务器端 #include "StdAfx ...
- 1.二进制部署kubernetes
目录 kubernetes的五个组件 master节点的三个组件 kube-apiserver kube-controller-manager kube-scheduler node节点的两个组件 k ...
- thinkphp3.2 where 条件查询
thinkphp3.2 where 条件查询 在连贯操作中条件where的操作有时候自己很晕,所以整理下,有助于使用 查询条件 支持的表达式查询,tp不区分大小写 含义 TP运算符 SQL运算符 例子 ...
- js中each函数的用法
官方说明: jQuery.each(object, [callback]) 概述 通用例遍方法,可用于例遍对象和数组. 不同于例遍 jQuery 对象的 $().each() 方法,此方法可用于例遍任 ...
- SSM-框架搭建-tank后台学习系统
一.前言 最近收到很多网友给我私信,学习软件开发有点吃力,不知道从何处开始学习,会点基础但是做不出来什么项目, 都想放弃了.我就回复道:当下互联网飞速发展,软件开发行业非常吃香而且前景相当不错.希望能 ...
- Wireshark论证TCP3次握手的过程
wireshark过滤条件:ip.addr == 120.79.36.180 千万别写成 ip.dst == 120.79.36.180 ,这样子就看不到服务器给我们返回的包了 此时,在浏览器输入12 ...
- 01-最大子列和问题(java)
问题描述:给定N个整数的序列{A1,A2,A3,…,An},求解子列和中最大的值. 这里我们给出{-2,11,-4,13,-5,-2}这样一个序列,正确的最大子列和为20 该题是在数据结构与算法中经常 ...
- java-IO流(commons-io-2.6)使用教程
工具库下载: https://pan.baidu.com/s/1tXXF4zjIfJ9ouObsU5RTpA 提取码:214v 1.打开IDEA 2.在模块下新建个lib文件夹将框架复制进去 3.点 ...
- bug和测试报告思维导图
Bug定义: 1.不符合需求的 2.程序本身的报错 3.不符合用户使用习惯的 Bug生命周期: 当我们测试人员提交一个bug的时候,自始bug就有它的生命周期,从开始到结束, 把测试的过程和结果写成文 ...