
爬虫新手学习2-爬虫进阶(urllib和urllib2 的区别、url转码、爬虫GET提交实例、批量爬取贴吧数据、fidder软件安装、有道翻译POST实例、豆瓣ajax数据获取)
1、urllib和urllib2区别实例
urllib和urllib2都是接受URL请求相关模块,但是提供了不同的功能,两个最显著的不同如下:
urllib可以接受URL,不能创建设置headers的Request类实例,urlib2可以。
url转码
https://www.baidu.com/s?wd=%E5%AD%A6%E7%A5%9E
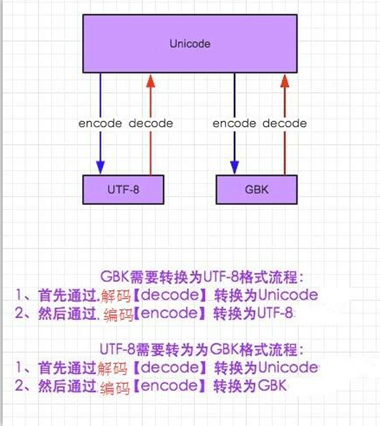
python字符集解码加码过程:
2.爬虫GET提交实例
#coding:utf-8

import urllib    #负责url编码处理

import urllib2

url = "https://www.baidu.com/s"

word = {"wd": "繁华"}

word = urllib.urlencode(word)   #转换成url编码格式(字符串)

newurl = url + "?" + word

headers = {"User-Agent": "Mozilla/5.0 (Windows NT 10.0; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/63.0.3239.84 Safari/537.36"}

request = urllib2.Request(newurl, headers=headers)

response = urllib2.urlopen(request)

print response.read()
#coding:utf-8

import urllib    #负责url编码处理

import urllib2

url = "https://www.baidu.com/s"

word = {"wd": "咖菲猫"}

word = urllib.urlencode(word)   #转换成url编码格式(字符串)

newurl = url + "?" + word

headers = {"User-Agent": "Mozilla/5.0 (Windows NT 10.0; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/63.0.3239.84 Safari/537.36"}

request = urllib2.Request(newurl, headers=headers)

response = urllib2.urlopen(request)

print response.read()
自定义爬虫GET提交实例
#coding:utf-8

import urllib    #负责url编码处理

import urllib2

url = "https://www.baidu.com/s"

keyword = raw_input("请输入要查询的关键字:")

word = {"wd": keyword}

word = urllib.urlencode(word)   #转换成url编码格式(字符串)

newurl = url + "?" + word

headers = {"User-Agent": "Mozilla/5.0 (Windows NT 10.0; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/63.0.3239.84 Safari/537.36"}

request = urllib2.Request(newurl, headers=headers)

response = urllib2.urlopen(request)

print response.read()
3.批量爬取贴吧页面数据
分析贴吧URL
http://tieba.baidu.com/f?kw=%E7%BB%9D%E5%9C%B0%E6%B1%82%E7%94%9F
pn递增50为一页
0为第一页
http://tieba.baidu.com/f?kw=%E7%BB%9D%E5%9C%B0%E6%B1%82%E7%94%9F&pn=0
50为第二页
http://tieba.baidu.com/f?kw=%E7%BB%9D%E5%9C%B0%E6%B1%82%E7%94%9F&pn=50
100为第三页
http://tieba.baidu.com/f?kw=%E7%BB%9D%E5%9C%B0%E6%B1%82%E7%94%9F&pn=100
批量爬贴吧实例
#coding:utf-8

import urllib

import urllib2

def loadPage(url, filename):

    '''

        作用:根据url发送请求, 获取服务器响应文件

        url:需要爬取的url地址

        filename:文件名

    '''

    print "正在下载" + filename

    headers = {

        "User-Agent": "Mozilla/5.0 (Windows NT 10.0; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/63.0.3239.84 Safari/537.36"}

    request = urllib2.Request(url, headers = headers)

    response = urllib2.urlopen(request)

    return response.read()

def writeFile(html, filename):

    '''

        作用:保存服务器相应文件到本地硬盘文件里

        html:服务器相应文件

        filename:本地磁盘文件名

    '''

    print "正在存储" + filename

    with open(unicode(filename, 'utf-8'), 'w') as f:

        f.write(html)

    print "-" * 20

def tiebaSpider(url, beginPage, endPage, name):

    '''

        作用:负责处理url,分配每个url去发送请求

        url:需要处理的第一个url

        beginPage:爬虫执行的起始页面

        endPage:爬虫执行的截止页面

    '''

    for page in range(beginPage, endPage + 1):

        pn = (page - 1) * 50

        filename = "第" + name + "-" + str(page) + "页.html"

        #组合为完整的url,并且pn值每次增加50

        fullurl = url + "&pn=" + str(pn)

        #print fullurl

        #调用loadPage()发送请求获取HTML页面

        html = loadPage(fullurl, filename)

        #将获取到的HTML页面写入本地磁盘文件

        writeFile(html, filename)

#模拟main函数"

if __name__ == "__main__":

    kw = raw_input("请输入需要爬取的贴吧:")

    beginPage = int(raw_input("请输入起始页:"))

    endPage = int(raw_input("请输入终止页:"))

    url = "http://tieba.baidu.com/f?"

    key = urllib.urlencode({"kw": kw})

    #组合后的url示例:http://tieba.baidu.com/f?kw=绝地求生

    newurl = url + key

    tiebaSpider(newurl, beginPage, endPage, kw)
4.Fidder使用安装
下载fidder
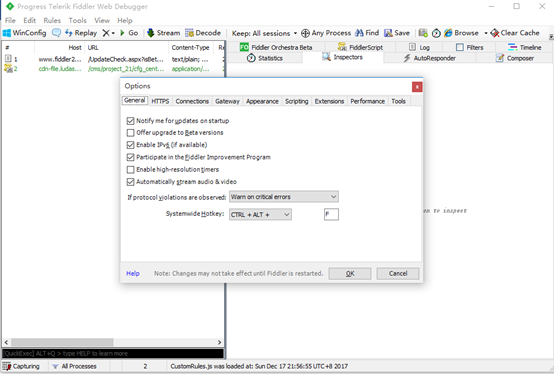
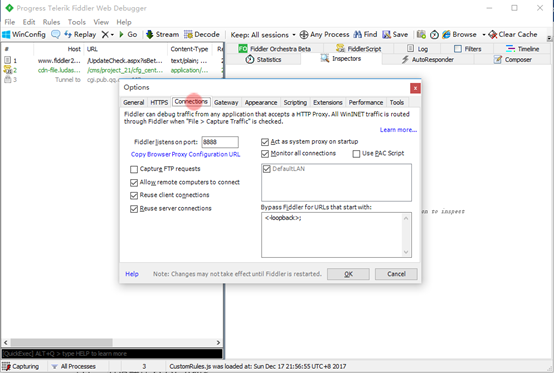
安装后,照下图设置

5.有道翻译POST分析
调用有道翻译POST API实例
#coding:utf-8

import urllib

import urllib2

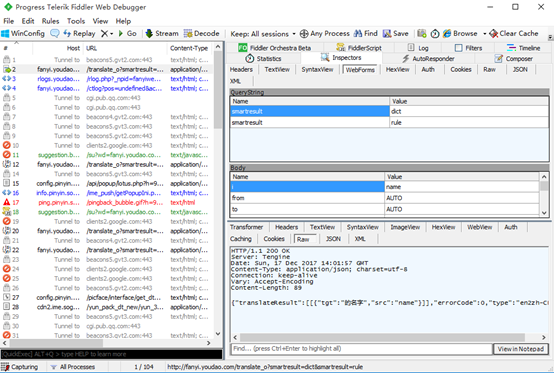
#通过抓包的方式获取的url,并不是浏览器上显示的url

url = "http://fanyi.youdao.com/translate?smartresult=dict&smartresult=rule&smartresult=ugc&sessionFrom=null"

#完整的headers

headers = {

    "Accept": "application/json, text/javascript, */*; q=0.01",

    "Origin": "http://fanyi.youdao.com",

    "X-Requested-With": "XMLHttpRequest",

    "User-Agent": "Mozilla/5.0 (Windows NT 10.0; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/63.0.3239.84 Safari/537.36",

    "Content-Type": "application/x-www-form-urlencoded; charset=UTF-8"

}

#用户接口输入

key = raw_input("请输入需要翻译的英文单词:")

#发送到web服务器的表单数据

formdata = {

    "i": key,

    "from": "AUTO",

    "to": "AUTO",

    "smartresult": "dict",

    "client": "fanyideskweb",

    "salt": "",

    "sign": "29e3219b8c4e75f76f6e6aba0bb3c4b5",

    "doctype": "json",

    "version": "2.1",

    "keyfrom": "fanyi.web",

    "action": "FY_BY_REALTIME",

    "typoResult": "false"

}

#经过urlencode转码

data = urllib.urlencode(formdata)

#如果Request()方法里的data参数有值,那么这个请求就是POST

#如果没有,就是Get

request = urllib2.Request(url, data= data, headers= headers)

print urllib2.urlopen(request).read()
6.Ajax加载方式的数据获取
豆瓣分析Ajax
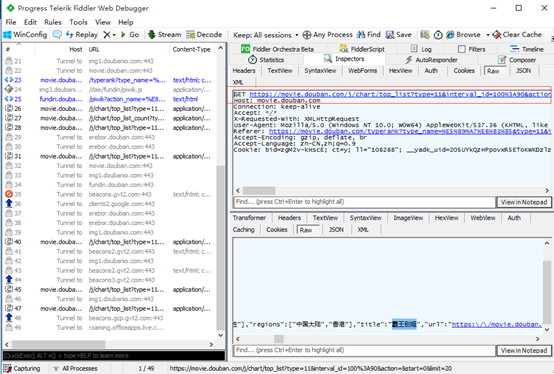
爬取豆瓣电影排行信息实例
#coding:utf-8

import urllib2

import urllib

url = "https://movie.douban.com/j/chart/top_list?type=11&interval_id=100%3A90&action="

headers = {"User-Agent": "Mozilla/5.0 (Windows NT 10.0; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/63.0.3239.84 Safari/537.36"}

formdata = {

    "start": "",

    "limit": ""

}

data = urllib.urlencode(formdata)

request = urllib2.Request(url, data = data, headers = headers)

print urllib2.urlopen(request).read()
爬虫新手学习2-爬虫进阶(urllib和urllib2 的区别、url转码、爬虫GET提交实例、批量爬取贴吧数据、fidder软件安装、有道翻译POST实例、豆瓣ajax数据获取)的更多相关文章
- Python爬虫实例:爬取B站《工作细胞》短评——异步加载信息的爬取
很多网页的信息都是通过异步加载的,本文就举例讨论下此类网页的抓取. <工作细胞>最近比较火,bilibili 上目前的短评已经有17000多条. 先看分析下页面 右边 li 标签中的就是短 ...
- python爬虫25 | 爬取下来的数据怎么保存? CSV 了解一下
大家好 我是小帅b 是一个练习时长两年半的练习生 喜欢 唱! 跳! rap! 篮球! 敲代码! 装逼! 不好意思 我又走错片场了 接下来的几篇文章 小帅b将告诉你 如何将你爬取到的数据保存下来 有文本 ...
- Python爬虫:爬取喜马拉雅音频数据详解
前言 喜马拉雅是专业的音频分享平台,汇集了有声小说,有声读物,有声书,FM电台,儿童睡前故事,相声小品,鬼故事等数亿条音频,我最喜欢听民间故事和德云社相声集,你呢? 今天带大家爬取喜马拉雅音频数据,一 ...
- Python爬虫实例:爬取猫眼电影——破解字体反爬
字体反爬 字体反爬也就是自定义字体反爬,通过调用自定义的字体文件来渲染网页中的文字,而网页中的文字不再是文字,而是相应的字体编码,通过复制或者简单的采集是无法采集到编码后的文字内容的. 现在貌似不少网 ...
- Python爬虫实例:爬取豆瓣Top250
入门第一个爬虫一般都是爬这个,实在是太简单.用了 requests 和 bs4 库. 1.检查网页元素,提取所需要的信息并保存.这个用 bs4 就可以,前面的文章中已经有详细的用法阐述. 2.找到下一 ...
- from appium import webdriver 使用python爬虫,批量爬取抖音app视频(requests+Fiddler+appium)
使用python爬虫,批量爬取抖音app视频(requests+Fiddler+appium) - 北平吴彦祖 - 博客园 https://www.cnblogs.com/stevenshushu/p ...
- Python爬虫——request实例:爬取网易云音乐华语男歌手top10歌曲
requests是python的一个HTTP客户端库,跟urllib,urllib2类似,但比那两个要简洁的多,至于request库的用法, 推荐一篇不错的博文:https://cuiqingcai. ...
- Python爬取招聘网站数据,给学习、求职一点参考
1.项目背景 随着科技的飞速发展,数据呈现爆发式的增长,任何人都摆脱不了与数据打交道,社会对于“数据”方面的人才需求也在不断增大.因此了解当下企业究竟需要招聘什么样的人才?需要什么样的技能?不管是对于 ...
- 4 urllib和urllib2的区别
4 urllib和urllib2的区别 这个面试官确实问过,当时答的urllib2可以Post而urllib不可以. urllib提供urlencode方法用来GET查询字符串的产生,而urllib2 ...
随机推荐
- PostgreSQL 下生成 UUID(Guid)
最近在Windows 10 下安装了 PostgreSQL(postgresql-9.6.3-1-windows.exe),在学习过程中,发现PostgreSQL 支持UUID(Guid)类型,但是却 ...
- 基于Spring开发的一个BIO-RPC框架(对新人很友好)
PART1:先来整体看下项目的构成 其中bio-rpc-core就是所谓的rpc框架 bio-rpc-example-client即所谓的服务调用方(你的项目中想要调用服务的地方) bio-rpc-e ...
- 网页如何展示PPT文档
最近再做一个新项目,其中有一个难点,就是如何在网页上展示PPT,我网上找到了几种方法,但是真正符合我目前这个项目的就只有这一种方法了, 使用PowerPoint to Flash将ppt文 ...
- 原码、反码、补码的正(nao)确(can)打开方式
我们知道日常生活中使用的数分为整数和实数,整数的小数点固定在数的最右边,可以省略不写,而实数的小数点则不固定.在计算机中只能识别和表示“0”和“1”,而无法识别小数点,因此要想使得计算机能够处理日常使 ...
- 为你解读2017年Java开发前景如何
社会上普遍认为程序员是一份高薪职业,确实,相较于其他行业,大多数工作1-3年的程序员年收入都在10-20万.据权威机构统计,在所有的软件开发类人才中对Java开发人才的需求量最大,达到了60%-70% ...
- 在SQL Server Express版本中没有代理功能如何自动备份数据库
因为是免费的且单个数据库可以支持到10GB,对于一般企业完全足够了,也就将就使用了,备份将分为两步: 1.创建备份脚本 2.创建系统的计划任务进行每天的备份 详细做法如下: 1.创建备份脚本 打开SS ...
- tomcat集群日志切割和远程备份脚本分享
笔者一共有3台tomcat服务器,一共4个tomcat服务,未来还会增加4个作为负载,笔者想通过在存储服务器对tomcat服务的日志进行远程切割和备份到存储上. 文中采用清空日志的方式,优点是不用重启 ...
- 使用语句清除sqlserver数据库日志文件
修改其中的3个参数(数据库名,日志文件名,和目标日志文件的大小),运行即可 SET NOCOUNT ON DECLARE @LogicalFileName sysname, @MaxMinutes I ...
- Django框架中的model(操作数据库)
什么是ORM ORM,即Object-Relational Mapping(对象关系映射),它的作用是在关系型数据库和业务实体对象之间作一个映射,这样,我们在具体的操作业务对象的时候,就不需要再去和复 ...
- Libevent 事件循环(1)
// 事件的dispatch int event_base_loop(struct event_base *base, int flags) { //得到采用的事件模型 epoll/epoll/ ...