
scrapy中 selenium(中间件) + 语言处理 +mysql
- 在通过scrapy框架进行某些网站数据爬取的时候,往往会碰到页面动态数据加载的情况发生,如果直接使用scrapy对其url发请求,是绝对获取不到那部分动态加载出来的数据值。但是通过观察我们会发现,通过浏览器进行url请求发送则会加载出对应的动态加载出的数据。那么如果我们想要在scrapy也获取动态加载出的数据,则必须使用selenium创建浏览器对象,然后通过该浏览器对象进行请求发送,获取动态加载的数据值。
今日详情
1.案例分析:
- 需求:爬取网易新闻的国内板块下的新闻数据
- 需求分析:当点击国内超链进入国内对应的页面时,会发现当前页面展示的新闻数据是被动态加载出来的,如果直接通过程序对url进行请求,是获取不到动态加载出的新闻数据的。则就需要我们使用selenium实例化一个浏览器对象,在该对象中进行url的请求,获取动态加载的新闻数据。
2.selenium在scrapy中使用的原理分析:
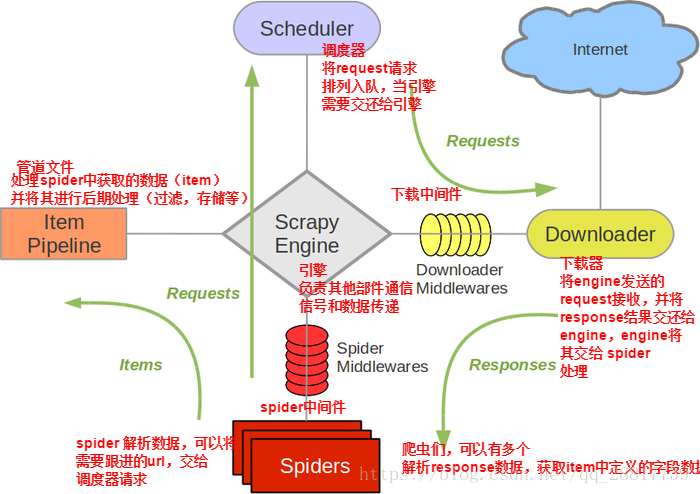
当引擎将国内板块url对应的请求提交给下载器后,下载器进行网页数据的下载,然后将下载到的页面数据,封装到response中,提交给引擎,引擎将response在转交给Spiders。Spiders接受到的response对象中存储的页面数据里是没有动态加载的新闻数据的。要想获取动态加载的新闻数据,则需要在下载中间件中对下载器提交给引擎的response响应对象进行拦截,切对其内部存储的页面数据进行篡改,修改成携带了动态加载出的新闻数据,然后将被篡改的response对象最终交给Spiders进行解析操作。
3.selenium在scrapy中的使用流程:
- 重写爬虫文件的构造方法,在该方法中使用selenium实例化一个浏览器对象(因为浏览器对象只需要被实例化一次)
- 重写爬虫文件的closed(self,spider)方法,在其内部关闭浏览器对象。该方法是在爬虫结束时被调用
- 重写下载中间件的process_response方法,让该方法对响应对象进行拦截,并篡改response中存储的页面数据
- 在配置文件中开启下载中间件
4.代码展示:
- 爬虫文件:
class WangyiSpider(RedisSpider):

    name = 'wangyi'

    #allowed_domains = ['www.xxxx.com']

    start_urls = ['https://news.163.com']

    def __init__(self):

        #实例化一个浏览器对象(实例化一次)

        self.bro = webdriver.Chrome(executable_path='/Users/bobo/Desktop/chromedriver')

    #必须在整个爬虫结束后,关闭浏览器

    def closed(self,spider):

        print('爬虫结束')

        self.bro.quit()
- 中间件文件:
from scrapy.http import HtmlResponse

    #参数介绍:

    #拦截到响应对象(下载器传递给Spider的响应对象)

    #request:响应对象对应的请求对象

    #response:拦截到的响应对象

    #spider:爬虫文件中对应的爬虫类的实例

    def process_response(self, request, response, spider):

        #响应对象中存储页面数据的篡改

        if request.url in['http://news.163.com/domestic/','http://news.163.com/world/','http://news.163.com/air/','http://war.163.com/']:

            spider.bro.get(url=request.url)

            js = 'window.scrollTo(0,document.body.scrollHeight)'

            spider.bro.execute_script(js)

            time.sleep(2)  #一定要给与浏览器一定的缓冲加载数据的时间

            #页面数据就是包含了动态加载出来的新闻数据对应的页面数据

            page_text = spider.bro.page_source

            #篡改响应对象

            return HtmlResponse(url=spider.bro.current_url,body=page_text,encoding='utf-8',request=request)

        else:

            return response
- 配置文件:
DOWNLOADER_MIDDLEWARES = {

    'wangyiPro.middlewares.WangyiproDownloaderMiddleware': 543,

}
scrapy中 selenium(中间件) + 语言处理 +mysql的更多相关文章
- 15.scrapy中selenium的应用
引入 在通过scrapy框架进行某些网站数据爬取的时候,往往会碰到页面动态数据加载的情况发生,如果直接使用scrapy对其url发请求,是绝对获取不到那部分动态加载出来的数据值.但是通过观察我们会发现 ...
- scrapy中selenium的应用
引入 在通过scrapy框架进行某些网站数据爬取的时候,往往会碰到页面动态数据加载的情况发生,如果直接使用scrapy对其url发请求,是绝对获取不到那部分动态加载出来的数据值.但是通过观察我们会发现 ...
- 15,scrapy中selenium的应用
引入 在通过scrapy框架进行某些网站数据爬取的时候,往往会碰到页面动态数据加载的情况发生如果直接用scrapy对其url发请求,是获取不到那部分动态加载出来的数据值,但是通过观察会发现,通过浏览器 ...
- 14 Scrapy中selenium的应用
在通过scrapy框架进行某些网站数据爬取的时候,往往会碰到页面动态数据加载的情况发生,如果直接使用scrapy对其url发请求,是绝对获取不到那部分动态加载出来的数据值.但是通过观察我们会发现,通过 ...
- 爬虫07 /scrapy图片爬取、中间件、selenium在scrapy中的应用、CrawlSpider、分布式、增量式
爬虫07 /scrapy图片爬取.中间件.selenium在scrapy中的应用.CrawlSpider.分布式.增量式 目录 爬虫07 /scrapy图片爬取.中间件.selenium在scrapy ...
- 如何优雅的在scrapy中使用selenium —— 在scrapy中实现浏览器池
1 使用 scrapy 做采集实在是爽,但是遇到网站反爬措施做的比较好的就让人头大了.除了硬着头皮上以外,还可以使用爬虫利器 selenium,selenium 因其良好的模拟能力成为爬虫爱(cai) ...
- selenium在scrapy中的使用、UA池、IP池的构建
selenium在scrapy中的使用流程 重写爬虫文件的构造方法__init__,在该方法中使用selenium实例化一个浏览器对象(因为浏览器对象只需要被实例化一次). 重写爬虫文件的closed ...
- Scrapy中集成selenium
面对众多动态网站比如说淘宝等,一般情况下用selenium最好 那么如何集成selenium到scrapy中呢? 因为每一次request的请求都要经过中间件,所以写在中间件中最为合适 from se ...
- 在Scrapy中使用selenium
在scrapy中使用selenium 在scrapy中需要获取动态加载的数据的时候,可以在下载中间件中使用selenium 编码步骤: 在爬虫文件中导入webdrvier类 在爬虫文件的爬虫类的构造方 ...
随机推荐
- pyquery的使用
常用的三种初始化方法: 1.字符串初始化: from pyquery import PyQuery as pq html=""" <html> <hea ...
- Anaconda 安装 Python 库(MySQLdb)的方法-(转)
安装python库的过程中,最重要的地方就是版本需要兼容.其中操作系统为64位,Python为2.X 64位,下载安装文件的时候也要注意版本匹配.其中文件名中包含的cp27表示CPython 2.7版 ...
- jquery遍历table的tr获取td的值
方法一: var siginArray = []; $("#tbody").children("tr").each(function () { var sigi ...
- @RequestMapping、@Responsebody、@RequestBody和@PathVariable详解(转)
一.预备知识:@RequestMapping RequestMapping是一个用来处理请求地址映射的注解,可用于类或方法上.用于类上,表示类中的所有响应请求的方法都是以该地址作为父路径. @Requ ...
- Go 缓冲信道和非缓冲信道
非缓冲信道是一个进一个出,再一个进再一个出,信道内是不保存数据的 缓冲信道是可以很多个依次进去,存储在信道里,然后一个一个的按次序取出来. 不过缓冲信道如果超过了预期的存入个数,会发生信道阻塞,只有把 ...
- InfluxDB中文文档
来源:https://github.com/jasper-zhang/influxdb-document-cn InfluxDB中文文档 InfluxDB是一个用于存储和分析时间序列数据的开源数据库. ...
- java容器Container和组件Component之GUI
GUI全称Graphical User Interfaces,意为图形用户户界面,又称为图形用户接口,GUI指的就是采用图形方式显示的计算机操作用户界面,打个比方吧,我们点击QQ图标,就会弹出一个QQ ...
- IKAnalyzer 源码走读
首先摘抄一段关于IK的特性介绍: 采用了特有的“正向迭代最细粒度切分算法”,具有60万字/秒的高速处理能力. 采用了多子处理器分析模式,支持:英文字母(IP地址.Email.URL).数字(日期,常用 ...
- HTML+CSS补充
1. HTML+CSS补充 - 布局: <style> .w{ width:980px;margin:0 auto; } </style> <body> <d ...
- 如果遇到Hadoop集群正常,MapReduce作业运行出现错误,如何来查看作业运行日志(图文详解)
不多说,直接上干货! 这个时候我们可以进入logs下的userlogs 备注:userlogs目录下有很多个以往运行的作业,我选择最新的最大编号的作业,就是我们当前运行作业的日志.然后找到stderr ...