
Scrapy中集成selenium
面对众多动态网站比如说淘宝等,一般情况下用selenium最好
那么如何集成selenium到scrapy中呢?
因为每一次request的请求都要经过中间件,所以写在中间件中最为合适
from selenium import webdriver

from scrapy.http import HtmlResponse

class JSPageMiddleware(object):

    def process_request(self, request, spider):

        if spider.name == "xinlang":  # 这只是一个示例表示爬虫为新浪,当然可以自定义比如正则表达式对于某一种网址来进行过滤

            browser = webdriver.Chrome()

            browser.get(request.url)

            import time

            time.sleep(3)

            print("访问:{0}".format(request.url))  # 如何在这里发送完成之后就不发送给scrapy下载器了呢?

            return HtmlResponse(url=browser.current_url, body=browser.page_source, encoding="utf-8",request=request)

            # 一旦遇到HTMLResponse,scrapy就不会向download发送了,而是直接返回给spider了,上面所有值都是必须的
注意别忘了 将中间件写入到settings中!
是不是可以优化的空间了呢?
每一次请求都要打开一次Chrome,这个就很烦了,因为速度比较慢
from selenium import webdriver

from scrapy.http import HtmlResponse

class JSPageMiddleware(object):

    def __init__(self):

        self.browser = webdriver.Chrome

        super().__init__()

    def process_request(self, request, spider):

        if spider.name == "xinlang":  # 这只是一个示例表示爬虫为新浪,当然可以自定义比如正则表达式对于某一种网址来进行过滤

            self.browser.get(request.url)

            import time

            time.sleep(3)

            print("访问:{0}".format(request.url))  # 如何在这里发送完成之后就不发送给scrapy下载器了呢?

            return HtmlResponse(url=self.browser.current_url, body=self.browser.page_source, encoding="utf-8", request=request)

            # 一旦遇到HTMLResponse,scrapy就不会向download发送了,而是直接返回给spider了,上面所有值都是必须的
这样只需要打开一次Chrome了,但是,注意下,这样的话scrapy就不会关闭了,那怎么办?
我们把它放到spider中

那这样的话,中间件中改为
from scrapy.http import HtmlResponse

class JSPageMiddleware(object):

    def process_request(self, request, spider):

        if spider.name == "xinlang":

            spider.browser.get(request.url)  # 利用spider来进行调用

            import time

            time.sleep(3)

            print("访问:{0}".format(request.url))  # 如何在这里发送完成之后就不发送给scrapy下载器了呢?

            return HtmlResponse(url=spider.browser.current_url, body=spider.browser.page_source, encoding="utf-8", request=request)
但是这样还是有问题,我咋知道什么时间关闭?
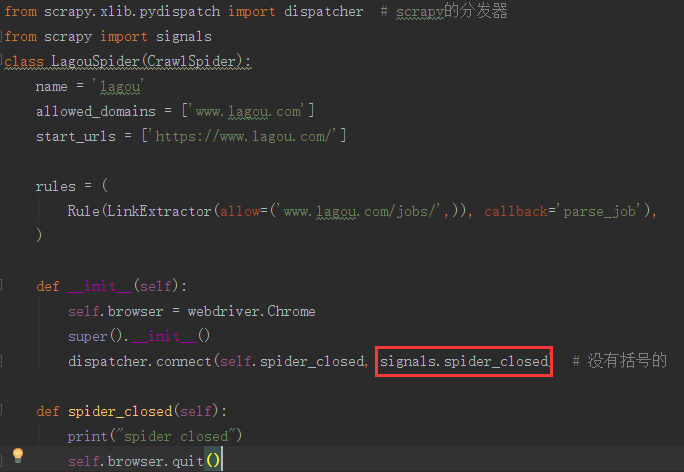
from selenium import webdriver

from scrapy.xlib.pydispatch import dispatcher  # scrapy的分发器

from scrapy import signals

class LagouSpider(CrawlSpider):

    name = 'lagou'

    allowed_domains = ['www.lagou.com']

    start_urls = ['https://www.lagou.com/']

    rules = (

        Rule(LinkExtractor(allow=('www.lagou.com/jobs/',)), callback='parse_job'),

    )

    def __init__(self):

        self.browser = webdriver.Chrome

        super().__init__()

        dispatcher.connect(self.spider_closed, signals.spider_closed)  # 没有括号的

    def spider_closed(self):

        print("spider closed")

        self.browser.quit()
是不是和django的用法非常一致?
但是异步处理的时候,则么办,现在是一个同步的请求!
那么重写download
git 搜索scrapy download一搜便知
Scrapy中集成selenium的更多相关文章
- 在Scrapy中使用selenium
在scrapy中使用selenium 在scrapy中需要获取动态加载的数据的时候,可以在下载中间件中使用selenium 编码步骤: 在爬虫文件中导入webdrvier类 在爬虫文件的爬虫类的构造方 ...
- scrapy中使用selenium来爬取页面
scrapy中使用selenium来爬取页面 from selenium import webdriver from scrapy.http.response.html import HtmlResp ...
- 如何优雅的在scrapy中使用selenium —— 在scrapy中实现浏览器池
1 使用 scrapy 做采集实在是爽,但是遇到网站反爬措施做的比较好的就让人头大了.除了硬着头皮上以外,还可以使用爬虫利器 selenium,selenium 因其良好的模拟能力成为爬虫爱(cai) ...
- scrapy中的selenium
引入 在通过scrapy框架进行某些网站数据爬取的时候,往往会碰到页面动态数据加载的情况发生,如果直接使用scrapy对其url发请求,是绝对获取不到那部分动态加载出来的数据值.但是通过观察我们会发现 ...
- 爬虫之scrapy框架应用selenium
一.利用selenium 爬取 网易军事新闻 使用流程: ''' 在scrapy中使用selenium的编码流程: 1.在spider的构造方法中创建一个浏览器对象(作为当前spider的一个属性) ...
- 第三百五十一节,Python分布式爬虫打造搜索引擎Scrapy精讲—将selenium操作谷歌浏览器集成到scrapy中
第三百五十一节,Python分布式爬虫打造搜索引擎Scrapy精讲—将selenium操作谷歌浏览器集成到scrapy中 1.爬虫文件 dispatcher.connect()信号分发器,第一个参数信 ...
- scrapy架构与目录介绍、scrapy解析数据、配置相关、全站爬取cnblogs数据、存储数据、爬虫中间件、加代理、加header、集成selenium
今日内容概要 scrapy架构和目录介绍 scrapy解析数据 setting中相关配置 全站爬取cnblgos文章 存储数据 爬虫中间件和下载中间件 加代理,加header,集成selenium 内 ...
- selenium在scrapy中的使用、UA池、IP池的构建
selenium在scrapy中的使用流程 重写爬虫文件的构造方法__init__,在该方法中使用selenium实例化一个浏览器对象(因为浏览器对象只需要被实例化一次). 重写爬虫文件的closed ...
- 15.scrapy中selenium的应用
引入 在通过scrapy框架进行某些网站数据爬取的时候,往往会碰到页面动态数据加载的情况发生,如果直接使用scrapy对其url发请求,是绝对获取不到那部分动态加载出来的数据值.但是通过观察我们会发现 ...
随机推荐
- C/C++中指针和java的引用区别
C++指针 要区分指针变量和指针变量所指对象. 指针变量先是一个变量,它有自己的地址和存储的内容,所以要想清楚是改变指针变量的值(即地址),还是改变指针变量所指对象的值. #include < ...
- Java学习笔记——鸵鸟学习记(三)
8,对象的创建与销毁 a, 构造方法——在构造对象的时候同时传入相关的属性 用于构造对象的方法(当创建对象时调用的方法) 规则:1)方法名与类名相同 2)无返回值 package my; public ...
- Android开发 Context详解与类型 转载
转载地址:https://blog.csdn.net/guolin_blog/article/details/47028975 个人总结: Context分为 activity : activity其 ...
- 6.3 基于二分搜索树、链表的实现的集合Set复杂度分析
两种集合类的复杂度分析 在[6.1]节与[6.2]节中分别以二分搜索树和链表作为底层实现了集合Set,在本节就两种集合类的复杂度分析进行分析:测试内容:6.1节与6.2节中使用的书籍.测试方法:测试两 ...
- 在Airtest中如何使用无线模式控制手机
在使用Airtest超快速开发App爬虫文章的最后,我们留了一个尾巴:如何启动Airtest的无线模式,不用USB线就能控制手机? 本文将会讲到具体的做法.做法分为两种:第一种是在Airtest的ID ...
- Python11
os模块 os.getcwd() 获取当前工作目录,即当前python脚本工作的目录路径 os.chdir("dirname") 改变当前脚本工作目录:相当于shell下cd os ...
- python算法之冒泡排序和选择排序
一.冒泡排序(Bubble sort) Bubble sort, sometimes referred to as sinking sort, is a simple sorting algorith ...
- DRF框架之认证组件用法(第四天)
1. 什么是drf 框架的认证组件: auth 就等于是jango中的Auth模块,Auth是自带session信息,但是 drf的认证组件可以自定义token携带过去,去判断用的 2.如何实现认证呢 ...
- thinkphp51 重定向 redirect()
thinkphp51 重定向 跨域 redirect() 可以重新定义新的路由,是fetch() 无法做到的.
- Django04-模板系统Template
一.模板支持的语法 Django模板中只需要记两种特殊符号: {{ }}表示变量,在模板渲染的时候替换成值{% %}表示逻辑相关的操作. 二. 变量(使用双大括号来引用变量) 1.语法格式:{{var ...