
15.scrapy中selenium的应用
引入
- 在通过scrapy框架进行某些网站数据爬取的时候,往往会碰到页面动态数据加载的情况发生,如果直接使用scrapy对其url发请求,是绝对获取不到那部分动态加载出来的数据值。但是通过观察我们会发现,通过浏览器进行url请求发送则会加载出对应的动态加载出的数据。那么如果我们想要在scrapy也获取动态加载出的数据,则必须使用selenium创建浏览器对象,然后通过该浏览器对象进行请求发送,获取动态加载的数据值。
今日详情
1.案例分析:
- 需求:爬取网易新闻的国内板块下的新闻数据
- 需求分析:当点击国内超链进入国内对应的页面时,会发现当前页面展示的新闻数据是被动态加载出来的,如果直接通过程序对url进行请求,是获取不到动态加载出的新闻数据的。则就需要我们使用selenium实例化一个浏览器对象,在该对象中进行url的请求,获取动态加载的新闻数据。
2.selenium在scrapy中使用的原理分析:
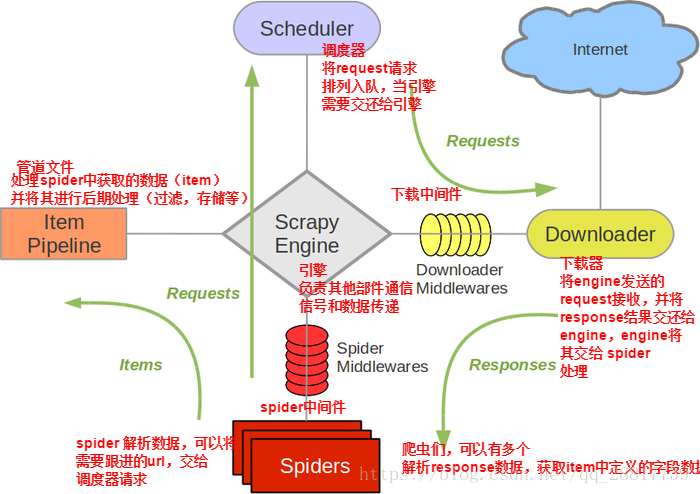
当引擎将国内板块url对应的请求提交给下载器后,下载器进行网页数据的下载,然后将下载到的页面数据,封装到response中,提交给引擎,引擎将response在转交给Spiders。Spiders接受到的response对象中存储的页面数据里是没有动态加载的新闻数据的。要想获取动态加载的新闻数据,则需要在下载中间件中对下载器提交给引擎的response响应对象进行拦截,切对其内部存储的页面数据进行篡改,修改成携带了动态加载出的新闻数据,然后将被篡改的response对象最终交给Spiders进行解析操作。
3.selenium在scrapy中的使用流程:
- 重写爬虫文件的构造方法,在该方法中使用selenium实例化一个浏览器对象(因为浏览器对象只需要被实例化一次)
- 重写爬虫文件的closed(self,spider)方法,在其内部关闭浏览器对象。该方法是在爬虫结束时被调用
- 重写下载中间件的process_response方法,让该方法对响应对象进行拦截,并篡改response中存储的页面数据
- 在配置文件中开启下载中间件
4.代码展示:
- 爬虫文件:
class WangyiSpider(RedisSpider):

    name = 'wangyi'

    #allowed_domains = ['www.xxxx.com']

    start_urls = ['https://news.163.com']

    def __init__(self):

        #实例化一个浏览器对象(实例化一次)

        self.bro = webdriver.Chrome(executable_path='/Users/bobo/Desktop/chromedriver')

    #必须在整个爬虫结束后,关闭浏览器

    def closed(self,spider):

        print('爬虫结束')

        self.bro.quit()
- 中间件文件:
from scrapy.http import HtmlResponse

    #参数介绍:

    #拦截到响应对象(下载器传递给Spider的响应对象)

    #request:响应对象对应的请求对象

    #response:拦截到的响应对象

    #spider:爬虫文件中对应的爬虫类的实例

    def process_response(self, request, response, spider):

        #响应对象中存储页面数据的篡改

        if request.url in['http://news.163.com/domestic/','http://news.163.com/world/','http://news.163.com/air/','http://war.163.com/']:

            spider.bro.get(url=request.url)

            js = 'window.scrollTo(0,document.body.scrollHeight)'

            spider.bro.execute_script(js)

            time.sleep(2)  #一定要给与浏览器一定的缓冲加载数据的时间

            #页面数据就是包含了动态加载出来的新闻数据对应的页面数据

            page_text = spider.bro.page_source

            #篡改响应对象

            return HtmlResponse(url=spider.bro.current_url,body=page_text,encoding='utf-8',request=request)

        else:

            return response
- 配置文件:
DOWNLOADER_MIDDLEWARES = {

    'wangyiPro.middlewares.WangyiproDownloaderMiddleware': 543,

}
15.scrapy中selenium的应用的更多相关文章
- 15,scrapy中selenium的应用
引入 在通过scrapy框架进行某些网站数据爬取的时候,往往会碰到页面动态数据加载的情况发生如果直接用scrapy对其url发请求,是获取不到那部分动态加载出来的数据值,但是通过观察会发现,通过浏览器 ...
- scrapy中selenium的应用
引入 在通过scrapy框架进行某些网站数据爬取的时候,往往会碰到页面动态数据加载的情况发生,如果直接使用scrapy对其url发请求,是绝对获取不到那部分动态加载出来的数据值.但是通过观察我们会发现 ...
- scrapy中 selenium(中间件) + 语言处理 +mysql
在通过scrapy框架进行某些网站数据爬取的时候,往往会碰到页面动态数据加载的情况发生,如果直接使用scrapy对其url发请求,是绝对获取不到那部分动态加载出来的数据值.但是通过观察我们会发现,通过 ...
- 14 Scrapy中selenium的应用
在通过scrapy框架进行某些网站数据爬取的时候,往往会碰到页面动态数据加载的情况发生,如果直接使用scrapy对其url发请求,是绝对获取不到那部分动态加载出来的数据值.但是通过观察我们会发现,通过 ...
- selenium在scrapy中的使用、UA池、IP池的构建
selenium在scrapy中的使用流程 重写爬虫文件的构造方法__init__,在该方法中使用selenium实例化一个浏览器对象(因为浏览器对象只需要被实例化一次). 重写爬虫文件的closed ...
- Scrapy中集成selenium
面对众多动态网站比如说淘宝等,一般情况下用selenium最好 那么如何集成selenium到scrapy中呢? 因为每一次request的请求都要经过中间件,所以写在中间件中最为合适 from se ...
- 在Scrapy中使用selenium
在scrapy中使用selenium 在scrapy中需要获取动态加载的数据的时候,可以在下载中间件中使用selenium 编码步骤: 在爬虫文件中导入webdrvier类 在爬虫文件的爬虫类的构造方 ...
- selenium在scrapy中的应用
引入 在通过scrapy框架进行某些网站数据爬取的时候,往往会碰到页面动态数据加载的情况发生,如果直接使用scrapy对其url发请求,是绝对获取不到那部分动态加载出来的数据值.但是通过观察我们会发现 ...
- 第三百五十一节,Python分布式爬虫打造搜索引擎Scrapy精讲—将selenium操作谷歌浏览器集成到scrapy中
第三百五十一节,Python分布式爬虫打造搜索引擎Scrapy精讲—将selenium操作谷歌浏览器集成到scrapy中 1.爬虫文件 dispatcher.connect()信号分发器,第一个参数信 ...
随机推荐
- B树与B+详解
承接上篇SQLite采用B树结构使得SQLite内存占用资源较少,本篇将讲述B树的具体操作(建树,插入,删除等操作).在看博客时,建议拿支笔和纸,一点一点操作,毕竟知识是自己的,自己也要消化的.本篇通 ...
- Visual Studio 2017 - Windows应用程序打包成exe文件(2)- Advanced Installer
Advanced Installer :Free for 30 days. All features. 下载地址:https://www.advancedinstaller.com/download. ...
- [转]认识JWT
本文转自:https://www.cnblogs.com/cjsblog/p/9277677.html 1. JSON Web Token是什么 JSON Web Token (JWT)是一个开放标准 ...
- log4j-1.2.6升级到log4j-2.9.0
0.工程是普通java web工程,不是maven工程.需要升级log4j 步骤发下: 1. 在build path中 移除项目对log4j-1.2.6.jar的引用,并物理删除log4j-1.2.6 ...
- JQuery官方学习资料(译):Attributes
Attributes 元素的属性可以为你的应用程序包含有用的信息,重要的是能够获取和设置它. .attr()方法 .attr()方法是可获取和可设置的,在设置状态下,.attr()可以 ...
- Java多线程之wait、notify/notifyAll 详解,用wait 和notifyAll 以及synchronized实现阻塞队列,多线程拓展之ReentrantLock与Condition
前言:这几天看了很多关于多线程的知识,分享一波.(但是目前接触的项目还未用到过,最多用过线程池,想看线程池 请看我之前的博客) 关于基本的理论等 参考如下: https://www.cnblogs.c ...
- linux系统mysql主从配置
一.原理 mysql主从配置的流程大体如图: 1)master会将变动记录到二进制日志里面: 2)master有一个I/O线程将二进制日志发送到slave; 3) slave有一个I/O线程把mast ...
- Js 转动抽奖实现
一.样本 地址:http://js.zhuamimi.cn/choujiang/index.htm 源码:https://pan.baidu.com/s/15KhesfcLf1WMOom6PhzCjA ...
- Python国内豆瓣源
Python国内豆瓣源 https://pypi.doubanio.com/simple/
- C# 程序运行进度显示Lable
public void test() { Thread.Sleep(); string vvv = ""; ; i < ;i++ ) { vvv = vvv +i.ToStr ...