
python爬虫——爬取淘票票正在热映电影
今天正好学习了一下python的爬虫,觉得收获蛮大的,所以写一篇博客帮助想学习爬虫的伙伴们。
这里我就以一个简单地爬取淘票票正在热映电影为例,介绍一下一个爬虫的完整流程。
首先,话不多说,上干货——源代码
 from bs4 import BeautifulSoup

 import requests

 import json

 #伪装成浏览器请求

 headers={

     'User-Agent':'Mozilla/5.0 (compatible; MSIE 9.0; Windows NT 6.1; Trident/5.0;',

     'Referer':'https://www.taopiaopiao.com/showList.htm?spm=a1z21.3046609.header.4.1d69112aGq86y0&n_s=new'

 }

 #获取网页的代码

 def getPage(url):

     try:

         response=requests.get(url)

         if response.status_code==200:   #http状态码,200表示请求成功

             return response.text

         else:

             return None

     except Exception:

         return None

 def getInfo(html):

     soup=BeautifulSoup(html,'lxml')    #创建bs对象 bs是使用的python默认的解析器,lxml也是解析器

     items=soup.select('div .movie-card-wrap')            #去网站的控制台找需要内容的上级标签元素,注意找的时候讲究方法,爬取的内容大部分都是有规律的,找到要爬取内容后,找你要爬的内容的父标签,这里找到div标签,然后后面的.movie-card-wrap是类名,当然也可以按照id查找,不会的自行百度soup.select

     i=1

     for item in items:

         name=item.find(name='div',class_='movie-card-name').get_text().strip()     #这个是找你要爬取内容的标签和它的类

         info=item.find(name='div',class_='movie-card-list').get_text().strip()

         print(str(i)+' '+'电影名:'+name+'\n'+info+'\n')

         i=i+1

 url='https://www.taopiaopiao.com/showList.htm?spm=a1z21.3046609.header.4.1d69112aGq86y0&n_s=new'

 html=getPage(url)

 getInfo(html)
然后说一下代码的具体含义,其实注释都有,我再详细讲一下流程吧
一、伪装成浏览器请求headers
这很好理解,因为如果不伪装的话,那你去爬取,爬取网站就能获悉你在爬数据,很容易被封,所以我们写一个headers的json伪装成浏览器来访问,不明白的自行百度
二、获取网页代码getPage
这部分代码很好理解,有用的就两行,所以就不详细说了,用的时候直接用即可
三、获取信息getInfo
这部分是我觉得就爬取而言最难的一部分,当然也不是很难,所以我结合例子详细说一下
首先我们要知道,爬取网页内容是爬取的网页代码中的内容,服务器端的数据我们是没办法爬取到的,什么意思,我们打开浏览器,按F12
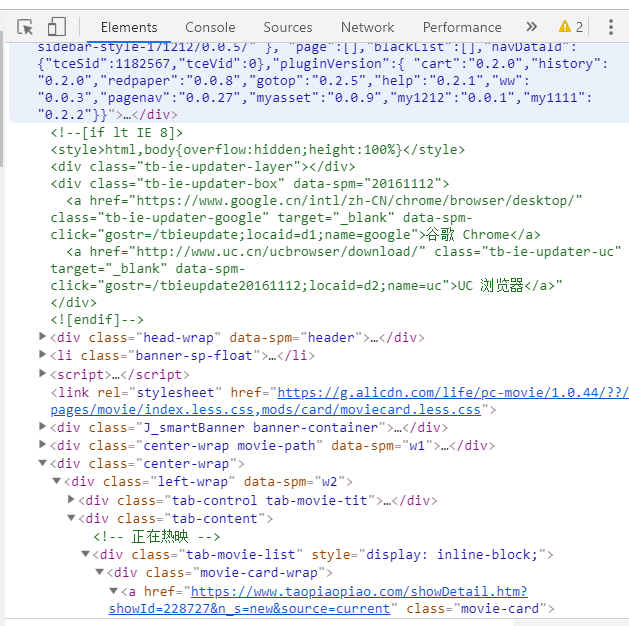
可以看到网页的源代码,然后我们要爬取的就是标签之间的那部分内容
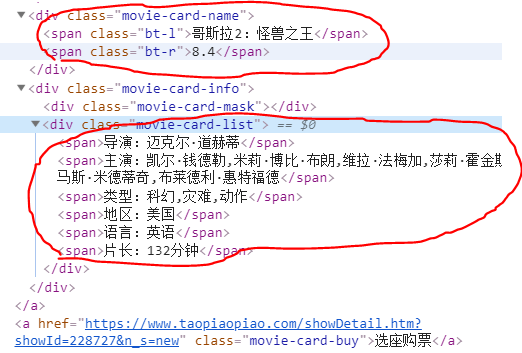
就是例如我上面画红圈的这些内容,我们这一步要做的,就是定位你要爬取内容在源代码中的位置,这么说大家可以理解吧。然后找到对应的标签,调用方法就可以了。
然后爬取到的信息可以存数据库,可以写成json数据,可以写入文件等再去做二次处理,筛选一些有用的数据,这里为了方便理解,我直接输出到控制台大家可以看一下结果。
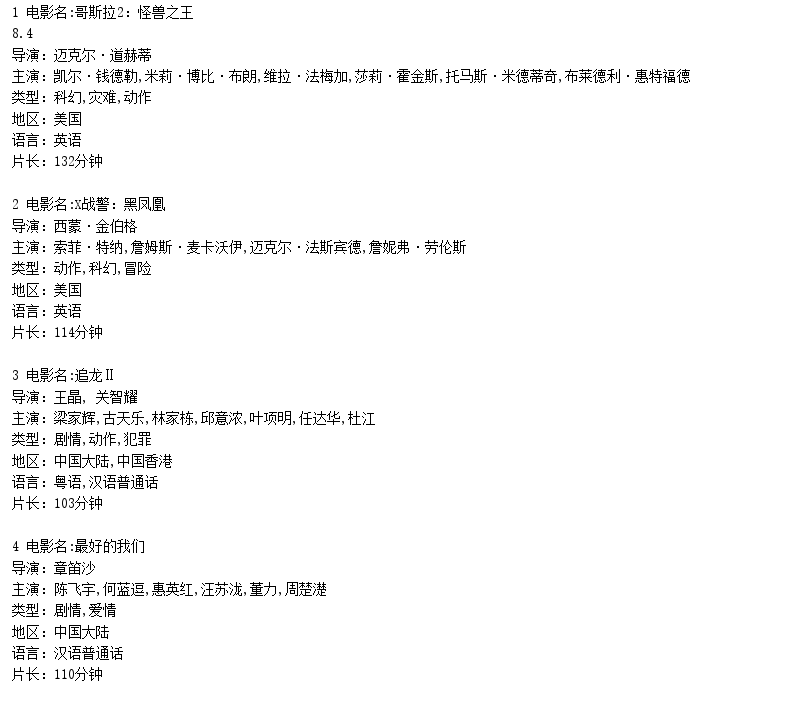
这就是python爬虫,我也是新手,可能有很多说的不到位,希望大家海涵。
python爬虫——爬取淘票票正在热映电影的更多相关文章
- 利用Python爬虫爬取淘宝商品做数据挖掘分析实战篇,超详细教程
项目内容 本案例选择>> 商品类目:沙发: 数量:共100页 4400个商品: 筛选条件:天猫.销量从高到低.价格500元以上. 项目目的 1. 对商品标题进行文本分析 词云可视化 2. ...
- 简单的python爬虫--爬取Taobao淘女郎信息
最近在学Python的爬虫,顺便就练习了一下爬取淘宝上的淘女郎信息:手法简单,由于淘宝网站本上做了很多的防爬措施,应此效果不太好! 爬虫的入口:https://mm.taobao.com/json/r ...
- Python爬虫 - 爬取百度html代码前200行
Python爬虫 - 爬取百度html代码前200行 - 改进版, 增加了对字符串的.strip()处理 源代码如下: # 改进版, 增加了 .strip()方法的使用 # coding=utf-8 ...
- 用Python爬虫爬取广州大学教务系统的成绩(内网访问)
用Python爬虫爬取广州大学教务系统的成绩(内网访问) 在进行爬取前,首先要了解: 1.什么是CSS选择器? 每一条css样式定义由两部分组成,形式如下: [code] 选择器{样式} [/code ...
- 使用Python爬虫爬取网络美女图片
代码地址如下:http://www.demodashi.com/demo/13500.html 准备工作 安装python3.6 略 安装requests库(用于请求静态页面) pip install ...
- Python爬虫|爬取喜马拉雅音频
"GOOD Python爬虫|爬取喜马拉雅音频 喜马拉雅是知名的专业的音频分享平台,用户规模突破4.8亿,汇集了有声小说,有声读物,儿童睡前故事,相声小品等数亿条音频,成为国内发展最快.规模 ...
- python爬虫爬取内容中,-xa0,-u3000的含义
python爬虫爬取内容中,-xa0,-u3000的含义 - CSDN博客 https://blog.csdn.net/aiwuzhi12/article/details/54866310
- Python爬虫爬取全书网小说,程序源码+程序详细分析
Python爬虫爬取全书网小说教程 第一步:打开谷歌浏览器,搜索全书网,然后再点击你想下载的小说,进入图一页面后点击F12选择Network,如果没有内容按F5刷新一下 点击Network之后出现如下 ...
- python爬虫—爬取英文名以及正则表达式的介绍
python爬虫—爬取英文名以及正则表达式的介绍 爬取英文名: 一. 爬虫模块详细设计 (1)整体思路 对于本次爬取英文名数据的爬虫实现,我的思路是先将A-Z所有英文名的连接爬取出来,保存在一个cs ...
随机推荐
- Protobuf(一)——Protobuf简介
Protobuf简介 什么是 Google Protocol Buffer? 假如您在网上搜索,应该会得到类似这样的文字介绍: Google Protocol Buffer( 简称 Proto ...
- 10年前文章_解决parted 编译出错问题
找到 include/site/i386-linux 文件,修改定义ac_cv_sizeof_off_t 的长度,从原来的4改为8 ac_cv_sizeof_off_t=8 删除 build_dir/ ...
- socket客户端怎么判断http响应数据的结束
前言 原文地址:https://blog.csdn.net/nimasike/article/details/81122784 http连接 短连接 定义:http头不包含Connection: Ke ...
- Eclipse开发工具的编码问题
乱码:文件有一个编码,打开文件的工具(Eclipse或者浏览器)有一个编码,当两个编码不同就会出现编码异常或乱码. 参考: Eclipse修改编码格式 背景:在Eclipse的开发使用中,我们经常使用 ...
- java -cp与java -jar的区别
java -cp 和 -classpath 一样,是指定类运行所依赖其他类的路径,通常是类库,jar包之类,需要全路径到jar包,window上分号“;”格式:java -cp .;myClass.j ...
- css-按钮中有图片和文字,怎么才能让文字和图片都中??
<div class="btn1 trans" > <img src="../../images/img/add.png"/> < ...
- 前端面试题常考&必考之--清除浮动的方法
浮动 问题:子元素设置了float后,脱离父元素,导致父元素无法撑开?(也就是子元素的高度没有过渡到父元素) 例子: 检查元素的效果: (三种)常用的解决办法: 1>额外标签法,添加一个空的di ...
- Day_04-数组,元组,列表
# for i in range(5): # for j in range(5): # print(i,j) # import re # def rm(): # a = ' 1 2 3 4 5 ' # ...
- C#项目类型分三种,Dos(控制台),c/s(客户端与服务器),b/s(浏览器/服务器)
- 超大文件上传方案( Java )
1.介绍enctype enctype 属性规定发送到服务器之前应该如何对表单数据进行编码. enctype作用是告知服务器请求正文的MIME类型(请求消息头content-type的作用一样) 1. ...