
千图网爬图片(BeautifulSoup)
import requests

from bs4 import BeautifulSoup

import os  #导入os模块

class TuKuSpider():

    """docstring for TuKuSpider"""

    def __init__(self):

        self.headers = {'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/65.0.3325.181 Safari/537.36'}

        self.url='http://588ku.com/tuku/jiepai.html'

        self.folder_path='E:\TuKuImg'

    def get_img_url(self):

        print('开始请求页面')

        init_response = self.request(self.url)

        all_img = BeautifulSoup(init_response.text,'lxml').find_all('img',class_='lazy')

        print('开始创建文件夹')

        self.mkdir(self.folder_path)  #创建文件夹

        print('开始切换文件夹')

        os.chdir(self.folder_path)   #切换路径至上面创建的文件夹

        for each in all_img:

            img_url = each.get('data-original')

            img_name = each.get('alt')

            if img_name == None:

                img_name = 'NoName'

            if img_url[-3:]=='png':

                img_url_final = 'http:'+img_url

                img_response = self.request(img_url_final)

                self.save_png(img_url_final,img_name)

            else:

                img_url = img_url[:img_url.index('.jpg')+4]

                img_url_final = 'http:'+img_url

                img_response = self.request(img_url_final)

                self.save_jpg(img_url_final,img_name)

    def request(self,url):

        r=requests.get(url,headers=self.headers)

        return r

    def save_jpg(self, url, name): ##保存图片

        print('开始请求图片地址,过程会有点长...')

        img = self.request(url)

        file_name = name + '.jpg'

        print('开始保存图片')

        f = open(file_name, 'ab')

        f.write(img.content)

        print(file_name,'图片保存成功!')

        f.close()

    def save_png(self, url, name): ##保存图片

        print('开始请求图片地址,过程会有点长...')

        img = self.request(url)

        file_name = name + '.png'

        print('开始保存图片')

        f = open(file_name, 'ab')

        f.write(img.content)

        print(file_name,'图片保存成功!')

        f.close()

    def mkdir(self, path):  ##这个函数创建文件夹

        path = path.strip()

        isExists = os.path.exists(path)

        if not isExists:

            print('创建名字叫做', path, '的文件夹')

            os.makedirs(path)

            print('创建成功!')

        else:

            print(path, '文件夹已经存在了,不再创建')

a = TuKuSpider()

a.get_img_url()
这个是针对千图网里面,搜索“街拍”弹出的结果进行一个爬虫编写。纯粹是为了练习,只爬15张图没什么必要写爬虫,手动都下载完了。
下面写一下这个爬虫的一些关键点:
一、图片URL所在位置:包含在属性class是lazy的IMG标签内,data-original内。
二、图片的URL需要进行文本处理,有些需要,有些不需要,要写个if判断。
三、图片保存的时候,在命名时要注意,后缀除了JPG以外,还有PNG,我的处理是加多了一个保存PNG的类。
踩的一些坑:
一、逻辑主体里面,有时在sublime text复制来复制去的时候,前面没有了空格,python会报错,只有前面是实线时,才是正确的,圆点是会报错的。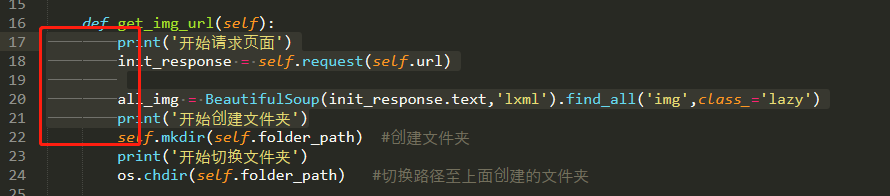
二、URL必须带“http://”不然requests无法识别,或者文本处理后的URL有误,都会报错:requests.exceptions.MissingSchema: Invalid URL
千图网爬图片(BeautifulSoup)的更多相关文章
- 【Python爬虫实战】 图片爬虫-淘宝图片爬虫--千图网图片爬虫
所谓图片爬虫,就是从互联网中自动把对方服务器上的图片爬下来的爬虫程序.有些图片是直接在html文件里面,有些是隐藏在JS文件中,在html文件中只需要我们分析源码就能得到如果是隐藏在JS文件中,那么就 ...
- python爬虫实战(二)--------千图网高清图
相关代码已经修改调试----2017-3-21 实现:千图网上高清图片的爬取 程序运行20小时,爬取大约162000张图片,一共49G,存入百度云.链接:http://pan.baidu.com/s/ ...
- 爬虫实战--基于requests 和 Beautiful的7160美图网爬取图片
import requests import os from bs4 import BeautifulSoup import re # 初始地址 all_url = 'http://www.7160. ...
- 好看的UI设计网站 www.ui.cn 和 插画网站 www.pixiv.net 千图网,界面很不错~
http://www.ui.cn/?t=share#project http://www.pixiv.net/ http://www.flaticon.com/ www.58pic.com 那张 给人 ...
- python爬取千库网
url:https://i588ku.com/beijing/0-0-default-0-8-0-0-0-0-1/ 有水印 但是点进去就没了 这里先来测试是否有反爬虫 import requests ...
- 爬取斗图网图片,使用xpath格式来匹配内容,对请求伪装成浏览器, Referer 防跨域请求
6.21自我总结 一.爬取斗图网 1.摘要 使用xpath匹配规则查找对应信息文件 将请求伪装成浏览器 Referer 防跨域请求 2.爬取代码 #导入模块 import requests #爬取网址 ...
- 每天一个小程序—0013题(爬图片+正则表达式 or BeautifulSoup)
第 0013 题: 用 Python 写一个爬图片的程序,爬 这个链接里的日本妹子图片 :-) 关于python3的urllib模块,可以看这篇博客:传送门 首先是用urlopen打开网站并且获取网页 ...
- python爬取斗图网中的 “最新套图”和“最新表情”
1.分析斗图网 斗图网地址:http://www.doutula.com 网站的顶部有这两个部分: 先分析“最新套图” 发现地址栏变成了这个链接,我们在点击第二页 可见,每一页的地址栏只有后面的pag ...
- 【Python还能干嘛】爬取微信好友头像完成马赛克拼图(千图成像)~
马赛克拼图 何谓马赛克拼图(千图成像),简单来说就是将若干小图片平凑成为一张大图,如下图路飞一样,如果放大看你会发现里面都是一些海贼王里面的图片. Our Tragets 爬取所有微信好友的头像
随机推荐
- Controller级别的异常处理过滤器IExceptionFilter
1,系统自带的HandleErrorAttribute类继承自IExceptionFilter,是MVC的默认实现. 同时设置web.config <system.web> <cus ...
- HDU 6047 Maximum Sequence (贪心+单调队列)
题意:给定一个序列,让你构造出一个序列,满足条件,且最大.条件是 选取一个ai <= max{a[b[j], j]-j} 析:贪心,贪心策略就是先尽量产生大的,所以就是对于B序列尽量从头开始,由 ...
- jquery.parser.js 的 parseOptions 方法
// target 是DOM元素 // properties 是宿主的属性 $.parser.parseOptions(target,properties); /** * parse options, ...
- 编写高质量代码改善C#程序的157个建议——建议46:显式释放资源需继承接口IDisposable
建议46:显式释放资源需继承接口IDisposable C#中的每一个类型都代表一种资源,资源分为两类: 托管资源:由CLR管理分配和释放的资源,即从CLR里new出来的对象. 非托管资源:不受CLR ...
- Eclipse中连接数据库错误:com.microsoft.sqlserver.jdbc.SQLServerException: 之类的错误
原创 错误:org.apache.jasper.JasperException: Unable to compile class for JSP 原因是页面指令中 import="java. ...
- web端访问文件没有权限的问题
背景 : ftp的PHP项目中的某些文件没有写入的权限..系统报注意错误!!! 原因 : 一般情况下,web端访问网站一般使用的是WWW权限(有限制的权限组)去访问, 但是我们编程开发的时候, 有可能 ...
- WinForm中TabControl的使用
TabControl和TabPage之间有一个默认颜色的边框,很难去除,需要重写TabControl控件重绘区域 public class FullTabControl : TabControl { ...
- go 常见问题
以下是我在go项目中碰到问题 1. 如何只测试指定的test文件,而不是所有的单元测试都跑一遍. go tool vet -test -v src\github.com\astaxie\beego\c ...
- xcode工程配置绝对路径与相对路径
1.问题描述 一般我们在xcode里面配置包含工程目录下头文件的时候,都要关联着相对路径和绝对路径,如果只是自己用这个项目,用绝对路径的问题不大,但是如果你把工程发给别人,别人就要在改这个绝对路径,这 ...
- react.js学习之路五
最近没时间写博客,但是我一直在学习react,我发现react是一个巨大的坑,而且永远填不完的坑 关于字符串的拼接: 在react中,字符串的拼接不允许出现双引号“” ,只能使用单引号' ',例如这样 ...