
Apache Spark源码走读之8 -- Spark on Yarn
欢迎转载,转载请注明出处,徽沪一郎。
概要
Hadoop2中的Yarn是一个分布式计算资源的管理平台,由于其有极好的模型抽象,非常有可能成为分布式计算资源管理的事实标准。其主要职责将是分布式计算集群的管理,集群中计算资源的管理与分配。
Yarn为应用程序开发提供了比较好的实现标准,Spark支持Yarn部署,本文将就Spark如何实现在Yarn平台上的部署作比较详尽的分析。
Spark Standalone部署模式回顾
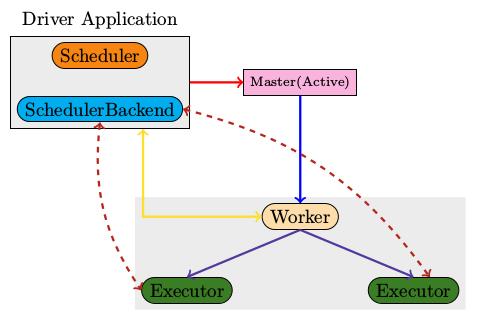
上图是Spark Standalone Cluster中计算模块的简要示意,从中可以看出整个Cluster主要由四种不同的JVM组成
- Master 负责管理整个Cluster,Driver Application和Worker都需要注册到Master
- Worker 负责某一个node上计算资源的管理,如启动相应的Executor
- Executor RDD中每一个Stage的具体执行是在Executor上完成
- Driver Application driver中的schedulerbackend会因为部署模式的不同而不同
换个角度来说,Master对资源的管理是在进程级别,而SchedulerBackend则是在线程的级别。
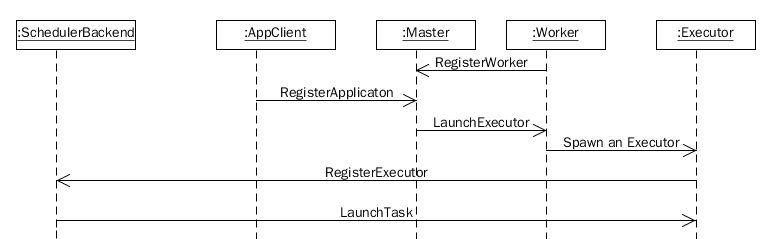
启动时序图
YARN的基本架构和工作流程
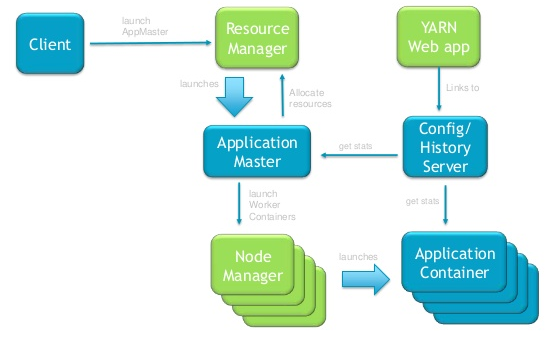
YARN的基本架构如上图所示,由三大功能模块组成,分别是1) RM (ResourceManager) 2) NM (Node Manager) 3) AM(Application Master)
作业提交
- 用户通过Client向ResourceManager提交Application, ResourceManager根据用户请求分配合适的Container,然后在指定的NodeManager上运行Container以启动ApplicationMaster
- ApplicationMaster启动完成后,向ResourceManager注册自己
- 对于用户的Task,ApplicationMaster需要首先跟ResourceManager进行协商以获取运行用户Task所需要的Container,在获取成功后,ApplicationMaster将任务发送给指定的NodeManager
- NodeManager启动相应的Container,并运行用户Task
实例
上述说了一大堆,说白了在编写YARN Application时,主要是实现Client和ApplicatonMaster。实例请参考github上的simple-yarn-app.
Spark on Yarn
结合Spark Standalone的部署模式和YARN编程模型的要求,做了一张表来显示Spark Standalone和Spark on Yarn的对比。
| Standalone | YARN | Notes |
|---|---|---|
| Client | Client | standalone请参考spark.deploy目录 |
| Master | ApplicationMaster | |
| Worker | ExecutorRunnable | |
| Scheduler | YarnClusterScheduler | |
| SchedulerBackend | YarnClusterSchedulerBackend |
作上述表格的目的就是要搞清楚为什么需要做这些更改,与之前Standalone模式间的对应关系是什么。代码走读时,分析的重点是ApplicationMaster, YarnClusterSchedulerBackend和YarnClusterScheduler
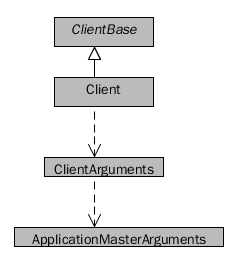
一般来说,在Client中会显示的指定启动ApplicationMaster的类名,如下面的代码所示
    ContainerLaunchContext amContainer =

        Records.newRecord(ContainerLaunchContext.class);

    amContainer.setCommands(

        Collections.singletonList(

            "$JAVA_HOME/bin/java" +

            " -Xmx256M" +

            " com.hortonworks.simpleyarnapp.ApplicationMaster" +

            " " + command +

            " " + String.valueOf(n) +

            " 1>" + ApplicationConstants.LOG_DIR_EXPANSION_VAR + "/stdout" +

            " 2>" + ApplicationConstants.LOG_DIR_EXPANSION_VAR + "/stderr"

            )

        );
但在yarn.Client中并没有直接指定ApplicationMaster的类名,是通过ClientArguments进行了封装,真正指定启动类的名称的地方在ClientArguments中。构造函数中指定了amClass的默认值是org.apache.spark.deploy.yarn.ApplicationMaster
实例说明
将SparkPi部署到Yarn上,下述是具体指令。
$ SPARK_JAR=./assembly/target/scala-2.10/spark-assembly-0.9.1-hadoop2.0.5-alpha.jar \

    ./bin/spark-class org.apache.spark.deploy.yarn.Client \

      --jar examples/target/scala-2.10/spark-examples-assembly-0.9.1.jar \

      --class org.apache.spark.examples.SparkPi \

      --args yarn-standalone \

      --num-workers 3 \

      --master-memory 4g \

      --worker-memory 2g \

      --worker-cores 1
从输出的日志可以看出, Client在提交的时候,AM指定的是org.apache.spark.deploy.yarn.ApplicationMaster
13/12/29 23:33:25 INFO Client: Command for starting the Spark ApplicationMaster: $JAVA_HOME/bin/java -server -Xmx4096m -Djava.io.tmpdir=$PWD/tmp org.apache.spark.deploy.yarn.ApplicationMaster --class org.apache.spark.examples.SparkPi --jar examples/target/scala-2.9.3/spark-examples-assembly-0.8.1-incubating.jar --args 'yarn-standalone' --worker-memory 2048 --worker-cores 1 --num-workers 3 1> /stdout 2> /stderr
小结
spark在提交时,所做的资源申请是一次性完成的,也就是说对某一个具体的Application,它所需要的Executor个数是一开始就是计算好,整个Cluster如果此时能够满足需求则提交,否则进行等待。而且如果有新的结点加入整个cluster,已经运行着的程序并不能使用这些新的资源。缺少rebalance的机制,这点上storm倒是有。
参考资料
- Launch Spark On YARN http://spark.apache.org/docs/0.9.1/running-on-yarn.html
- Getting started Writing YARN Application http://hortonworks.com/blog/getting-started-writing-yarn-applications/
- 《Hadoop技术内幕 深入解析YARN架构设计与实现原理》 董西成著
- YARN应用开发流程 http://my.oschina.net/u/1434348/blog/193374 强烈推荐!!!
Apache Spark源码走读之8 -- Spark on Yarn的更多相关文章
- Apache Spark源码走读之16 -- spark repl实现详解
欢迎转载,转载请注明出处,徽沪一郎. 概要 之所以对spark shell的内部实现产生兴趣全部缘于好奇代码的编译加载过程,scala是需要编译才能执行的语言,但提供的scala repl可以实现代码 ...
- Apache Spark源码走读之23 -- Spark MLLib中拟牛顿法L-BFGS的源码实现
欢迎转载,转载请注明出处,徽沪一郎. 概要 本文就拟牛顿法L-BFGS的由来做一个简要的回顾,然后就其在spark mllib中的实现进行源码走读. 拟牛顿法 数学原理 代码实现 L-BFGS算法中使 ...
- Apache Spark源码走读之9 -- Spark源码编译
欢迎转载,转载请注明出处,徽沪一郎. 概要 本来源码编译没有什么可说的,对于java项目来说,只要会点maven或ant的简单命令,依葫芦画瓢,一下子就ok了.但到了Spark上面,事情似乎不这么简单 ...
- Apache Spark源码走读之1 -- Spark论文阅读笔记
欢迎转载,转载请注明出处,徽沪一郎. 楔子 源码阅读是一件非常容易的事,也是一件非常难的事.容易的是代码就在那里,一打开就可以看到.难的是要通过代码明白作者当初为什么要这样设计,设计之初要解决的主要问 ...
- Apache Spark源码走读之7 -- Standalone部署方式分析
欢迎转载,转载请注明出处,徽沪一郎. 楔子 在Spark源码走读系列之2中曾经提到Spark能以Standalone的方式来运行cluster,但没有对Application的提交与具体运行流程做详细 ...
- spark 源码分析之十--Spark RPC剖析之TransportResponseHandler、TransportRequestHandler和TransportChannelHandler剖析
spark 源码分析之十--Spark RPC剖析之TransportResponseHandler.TransportRequestHandler和TransportChannelHandler剖析 ...
- spark 源码分析之十一--Spark RPC剖析之TransportClient、TransportServer剖析
TransportClient类说明 先来看,官方文档给出的说明: Client for fetching consecutive chunks of a pre-negotiated stream. ...
- Apache Spark源码走读之13 -- hiveql on spark实现详解
欢迎转载,转载请注明出处,徽沪一郎 概要 在新近发布的spark 1.0中新加了sql的模块,更为引人注意的是对hive中的hiveql也提供了良好的支持,作为一个源码分析控,了解一下spark是如何 ...
- Apache Spark源码走读之18 -- 使用Intellij idea调试Spark源码
欢迎转载,转载请注明出处,徽沪一郎. 概要 上篇博文讲述了如何通过修改源码来查看调用堆栈,尽管也很实用,但每修改一次都需要编译,花费的时间不少,效率不高,而且属于侵入性的修改,不优雅.本篇讲述如何使用 ...
随机推荐
- Linux C 知识 char型数字转换为int型 int型 转换为Char
前言 在九度oj做acm的时候,经常会遇到了char类型和int类型相互转化的问题,这里进行一下总结.今后,可能会多次更新博客,因为半年做了很多总结,但是都是保存在word文档上了,现在开始慢慢向CS ...
- 【读书笔记】读《JavaScript高级程序设计-第2版》 - 函数部分
1. 定义 函数实际上是对象,每个函数都是Function类型的实例,而且都与其他引用类型一样具有属性和方法.由于函数是对象,因此函数名实际上也是一个指向函数对象的指针,不会与某个函数绑定. 对于函数 ...
- Snmp配置
http://www.07net01.com/linux/CentOSxiaSNMPfuwuanzhuang_496848_1372907142.html
- ubuntu下简单的驱动编译
转自:http://www.eefocus.com/jefby1990/blog/13-02/291628_c39b8.html 本文是参考了网上多篇帖子而写的算不上什么原创.唯一值得欣慰的只不过在本 ...
- Windows 10 上强制Visual Studio以管理员身份运行
Windows 10 的一个既安全又蛋疼之处是UAC的行为被改变了.以往在Windows 7中,只要关闭了UAC,自己的帐号又是本机管理员组的,任何程序都会以管理员身份启动.然而,在Windows 8 ...
- 在HTML中优雅的生成PDF
关键代码<script type=</text> </para> <para align=" value=" ...
- cocos2dx游戏开发——微信打飞机学习笔记(九)——BulletLayer的搭建
一.创建文件~ BulletLayer.h BulletLayer.cpp 二.How to do? (1)实例化BulletLayer方法的实现~ Bullet(PlayerLayer* temp) ...
- 关于sqoop与datax。 和sqoop to oracle插件OraOop
之前我还在想了解下datax,是否有可能替换sqoop,但了解后发现,datax和sqoop的业务场景是不同的.前者适合异构数据库的同步,后者适合hdfs与rdbms互相之间的同步.针对sq ...
- Hark的数据结构与算法练习之桶排序
算法说明 桶排序的逻辑其实特别好理解,它是一种纯粹的分而治之的排序方法. 举个例子简单说一下大家就知道精髓了. 假如对11,4,2,13,22,24,20 进行排序. 那么,我们将4和2放在一起,将1 ...
- c#知识总结2
四.C#类型转换 类型转换就是把一种类型转换成为另一种类型. 隐式类型转换:c#默认的以安全方式进行的转换.例如小整数类型转换为大整数类型.派生类转换为基类 显式类型转换:用户使用的预定义的函数显式完 ...