
爬虫技术 -- 进阶学习(七)简单爬虫抓取示例(附c#代码)
这是我的第一个爬虫代码。。。算是一份测试版的代码。大牛大神别喷。。。
通过给定一个初始的地址startPiont然后对网页进行捕捉,然后通过正则表达式对网址进行匹配。
List<string> todo :进行抓取的网址的集合
List<string> visited :已经访问过的网址的集合
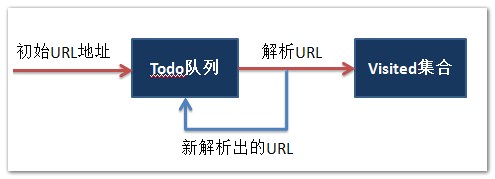
下面实现的是,给定一个初始地址,然后进行爬虫,输出正在访问的网址和已经访问的网页的个数。
需要注意的是,下面代码实现的链接匹配页面的内容如图一、图二所示:
- 图一:
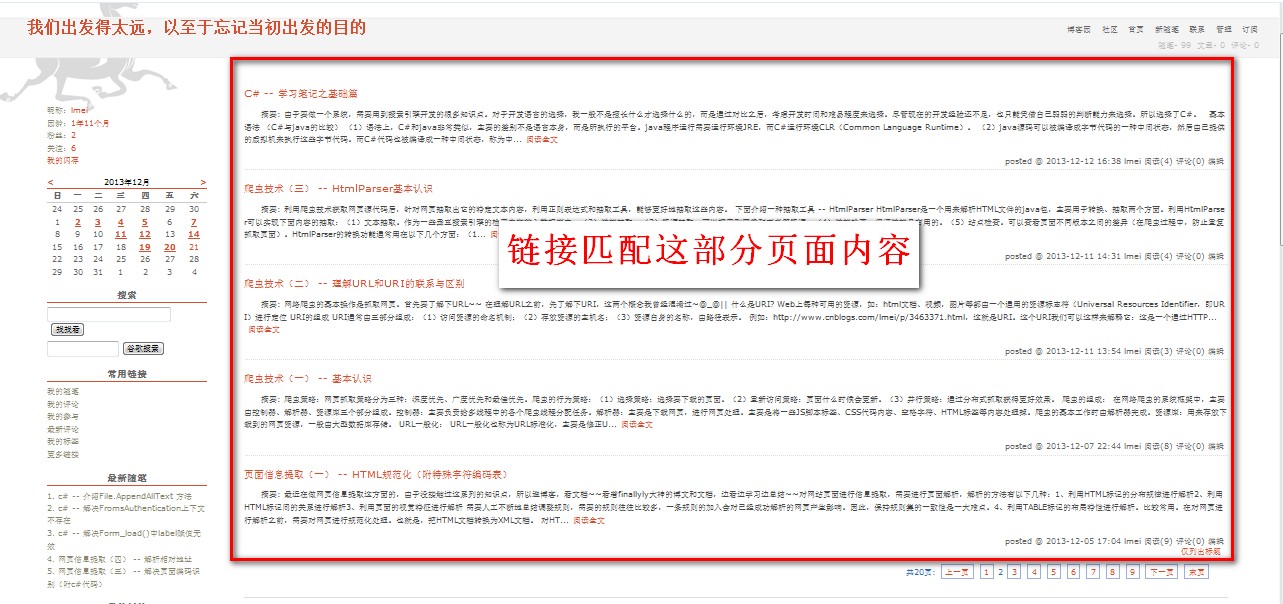
- 图二:

简单代码示范如下:(测试版)
using System;

using System.Collections.Generic;

using System.ComponentModel;

using System.Data;

using System.Drawing;

using System.Linq;

using System.Text;

using System.Windows.Forms;

using System.Web.Security;

using System.IO;

using System.Net;

using System.Text.RegularExpressions;

using System.Web;

namespace Demo1

{

    public partial class Form1 : Form

    {

        public Form1()

        {

            InitializeComponent();

         }

        private void button1_Click(object sender, EventArgs e)

        {

            Test1 a = new Test1();

            a.getCurrentURL();

        }

        public class Test1

        {

            List<string> todo = new List<string>();

            List<string> visited = new List<string>();

            string startPoint = "http://www.cnblogs.com/lmei/";


            public void getCurrentURL()

            {

                RequestSite(startPoint);

                while (todo.Count > )
                {

                    string currentURL = todo[];

                    RequestSite(currentURL);

                    if (visited.Contains(currentURL))  //注释1

                    {

                        Console.WriteLine("已经访问过了" + currentURL);

                        todo.Remove((currentURL));

                    }

                    else

                    {

                        Console.WriteLine("现在正在访问:===>   " + currentURL);

                        visited.Add(currentURL);

                        Console.WriteLine("目前已经访问了:===>   " + visited.Count + "个网页" );

                        todo.Remove((currentURL));

                    }

                }

            }

            public void RequestSite(string url)

            {

                WebRequest req = WebRequest.Create(url);

                HttpWebResponse res;

                try{

                      res = (HttpWebResponse)(req.GetResponse());

                }

                catch (WebException ex) { res = (HttpWebResponse)ex.Response; }

                Stream st = res.GetResponseStream();

                StreamReader rdr = new StreamReader(st);

                string s = rdr.ReadToEnd();

                todo.AddRange(GetLink(s));

            }

            List<string> GetLink(string htmlPage)

            {

                Regex regx =

                    new Regex("http://www\\.cnblogs\\.com\\/lmei\\/p\\/[0-9a-zA-Z]+\\.html*" ,RegexOptions.IgnoreCase);

                MatchCollection matches = regx.Matches(htmlPage);

                List<string> results = new List<string>();

                foreach (Match match in matches)

                {

                    if (!visited.Contains(match.Value)) //注释2

                    {

                        results.Add(match.Value);

                    }

                }

                return results;

            }

        }

    }

}
注释1 :是将已经访问过的网址排除。
注释2 :是将已经访问过的网址排除,但是可能由于同个网页中包含的两个(或两个以上)相同的链接,而且都没被访问过的,这样使得todo队列中会有相同的网址,所以需要注释1那部分进行再次过滤排除。其实也可以将注释2那部分删去,直接让注释1过滤就行。
接下来会进一步补充爬虫抓取的内容。。。
爬虫技术 -- 进阶学习(七)简单爬虫抓取示例(附c#代码)的更多相关文章
- 爬虫技术 -- 进阶学习(十)网易新闻页面信息抓取(htmlagilitypack搭配scrapysharp)
最近在弄网页爬虫这方面的,上网看到关于htmlagilitypack搭配scrapysharp的文章,于是决定试一试~ 于是到https://www.nuget.org/packages/Scrapy ...
- 爬虫技术(四)-- 简单爬虫抓取示例(附c#代码)
这是我的第一个爬虫代码...算是一份测试版的代码.大牛大神别喷... 通过给定一个初始的地址startPiont然后对网页进行捕捉,然后通过正则表达式对网址进行匹配. List<string&g ...
- 爬虫技术 -- 进阶学习(九)使用HtmlAgilityPack获取页面链接(附c#代码及插件下载)
菜鸟HtmlAgilityPack初体验...弱弱的代码... Html Agility Pack是一个开源项目,为网页提供了标准的DOM API和XPath导航.使用WebBrowser和HttpW ...
- 爬虫技术 -- 进阶学习(十一)【补充】获取html中meta标签中的content的内容
上一篇网易新闻页面信息抓取 -- htmlagilitypack搭配scrapysharp中提及了很多如何快速抓取html中的文本的语句, 但是meta标签中的content内容的抓取,没有提及到! ...
- 爬虫技术 -- 进阶学习(八)模拟简单浏览器(附c#代码)
由于最近在做毕业设计,需要用到一些简单的浏览器功能,于是学习了一下,顺便写篇博客~~大牛请勿喷,菜鸟练练手~ 实现界面如下:(简单朴素版@_@||) button_go实现如下: private vo ...
- 爬虫技术 -- 基础学习(一)HTML规范化(附特殊字符编码表)
最近在做网页信息提取这方面的,由于没接触过这系列的知识点,所以逛博客,看文档~~看着finallyly大神的博文和文档,边看边学习边总结~~ 对网站页面进行信息提取,需要进行页面解析,解析的方法有以下 ...
- 爬虫学习一系列:urllib2抓取网页内容
爬虫学习一系列:urllib2抓取网页内容 所谓网页抓取,就是把URL地址中指定的网络资源从网络中读取出来,保存到本地.我们平时在浏览器中通过网址浏览网页,只不过我们看到的是解析过的页面效果,而通过程 ...
- python3爬虫再探之豆瓣影评数据抓取
一个关于豆瓣影评的爬虫,涉及:模拟登陆,翻页抓取.直接上代码: import re import time import requests import xlsxwriter from bs4 imp ...
- [python应用]python简单图片抓取
前言 emmmm python简单图片抓取 1 import requests 2 import threading 3 import queue 4 from subprocess import P ...
随机推荐
- PowerManager和WakeLock的操作步骤
① PowerManager pm = (PowerManager) getSystemService(Context.POWER_SERVICE);通过 Context.getSystemServ ...
- Node.js的颠覆者:PHP的Swoole扩展
最近2年Node.js很火,异步与协程是网络开发方面热门的话题.在追求新技术的同时,也应该反思下这里面存在的陷阱.Node.js确实是一门有趣好玩有个性的语言和技术,动态性,全异步回调的方 ...
- go语言实现一个简单的登录注册web小程序
最近学习golang也有一段时间了,基础差不多学了个大概,因为本人是java程序员,所以对web更感兴趣.根据<go web编程>中的例子改编一个更简单的例子,供新手参考,废话不多说,上菜 ...
- Solr5之Schema.xml详解
schema.xml 是用来定义索引数据中的域的,包括域名称,域类型,域是否索引,是否分词,是否存储,是否标准化即 Norms ,是否存储项向量等等. schema.xml 配置文件的根元素就是 sc ...
- Android布局优化之过度绘制
如果一个布局十分复杂,那么就需要来排查是否出现了过度绘制,如果出现了,那么很可能会造成刷新率下降,造成卡顿的现象.那么什么是过度绘制呢?过度绘制就是在同一个区域中叠加了多个控件.这就像小时候我们画画, ...
- 关于iis7短日期后面带有星期的解决办法
以下方法试验无效: 在“控制面板”,在“区域和语言选项”中找到了“格式”设置,然后把短日期改成yyyy-M-D. 正确方法是修改注册表: /HKEY_USERS/.DEFAULT/Control Pa ...
- java Joda-Time 对日期、时间操作
任何企业应用程序都需要处理时间问题.应用程序需要知道当前的时间点和下一个时间点,有时它们还必须计算这两个时间点之间的路径.使用 JDK 完成这项任务将非常痛苦和繁琐.现在来看看 Joda Time,一 ...
- IOS开发 应用程序图标数字角标
其实实现这个功能很简单,只要调用UIApplication即可. 用法用例:[UIApplication sharedApplication].applicationIconBadgeNumber ...
- C#新开一个线程取到数据,如何更新到主线程UI上面
一:问题 之前有被面试官问过,在WinForm中,要去网络上获取数据,由于网络环境等原因,不能很快的完成,因此会发生进程阻塞,造成主进程假死的现象,需要怎么解决? 二:思路 因此,往往是新 ...
- 在 Visual Studio 中打开编辑 cshtml 文件时出现错误:未能完成该操作 无效指针 的解决方法
第一步:关闭 Visual Studio: 第二步:删除 %LocalAppData%\Microsoft\VisualStudio\14.0\ComponentModelCache 下的所有文件: ...