
05 (OC) 二叉树 深度优先遍历和广度优先遍历
总结深度优先与广度优先的区别
1、区别
1) 二叉树的深度优先遍历的非递归的通用做法是采用栈,广度优先遍历的非递归的通用做法是采用队列。
2) 深度优先遍历:对每一个可能的分支路径深入到不能再深入为止,而且每个结点只能访问一次。要特别注意的是,二叉树的深度优先遍历比较特殊,可以细分为先序遍历、中序遍历、后序遍历。具体说明如下:
- 先序遍历:对任一子树,先访问根,然后遍历其左子树,最后遍历其右子树。
- 中序遍历:对任一子树,先遍历其左子树,然后访问根,最后遍历其右子树。
- 后序遍历:对任一子树,先遍历其左子树,然后遍历其右子树,最后访问根。
广度优先遍历:又叫层次遍历,从上往下对每一层依次访问,在每一层中,从左往右(也可以从右往左)访问结点,访问完一层就进入下一层,直到没有结点可以访问为止。
3)深度优先搜素算法:不全部保留结点,占用空间少;有回溯操作(即有入栈、出栈操作),运行速度慢。
广度优先搜索算法:保留全部结点,占用空间大; 无回溯操作(即无入栈、出栈操作),运行速度快。
通常 深度优先搜索法不全部保留结点,扩展完的结点从数据库中弹出删去,这样,一般在数据库中存储的结点数就是深度值,因此它占用空间较少。
所以,当搜索树的结点较多,用其它方法易产生内存溢出时,深度优先搜索不失为一种有效的求解方法。
广度优先搜索算法,一般需存储产生的所有结点,占用的存储空间要比深度优先搜索大得多,因此,程序设计中,必须考虑溢出和节省内存空间的问题。
但广度优先搜索法一般无回溯操作,即入栈和出栈的操作,所以运行速度比深度优先搜索要快些
4)深度优先遍历:用时间换空间。
广度优先遍历:用空间换时间。
2.二叉树的遍历
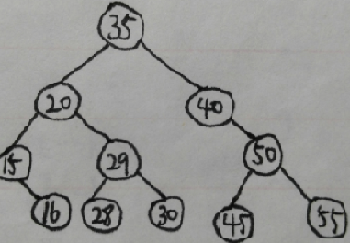
先序遍历(递归):35 20 15 16 29 28 30 40 50 45 55
中序遍历(递归):15 16 20 28 29 30 35 40 45 50 55
后序遍历(递归):16 15 28 30 29 20 45 55 50 40 35
先序遍历(非递归):35 20 15 16 29 28 30 40 50 45 55
中序遍历(非递归):15 16 20 28 29 30 35 40 45 50 55
后序遍历(非递归):16 15 28 30 29 20 45 55 50 40 35
广度优先遍历:35 20 40 15 29 50 16 28 30 45 55
05 (OC) 二叉树 深度优先遍历和广度优先遍历的更多相关文章
- js实现深度优先遍历和广度优先遍历
深度优先遍历和广度优先遍历 什么是深度优先和广度优先 其实简单来说 深度优先就是自上而下的遍历搜索 广度优先则是逐层遍历, 如下图所示 1.深度优先 2.广度优先 两者的区别 对于算法来说 无非就是时 ...
- 深度优先遍历 and 广度优先遍历
深度优先遍历 and 广度优先遍历 遍历在前端的应用场景不多,多数是处理DOM节点数或者 深拷贝.下面笔者以深拷贝为例,简单说明一些这两种遍历.
- C++ 二叉树深度优先遍历和广度优先遍历
二叉树的创建代码==>C++ 创建和遍历二叉树 深度优先遍历:是沿着树的深度遍历树的节点,尽可能深的搜索树的分支. //深度优先遍历二叉树void depthFirstSearch(Tree r ...
- python、java实现二叉树,细说二叉树添加节点、深度优先(先序、中序、后续)遍历 、广度优先 遍历算法
数据结构可以说是编程的内功心法,掌握好数据结构真的非常重要.目前基本上流行的数据结构都是c和c++版本的,我最近在学习python,尝试着用python实现了二叉树的基本操作.写下一篇博文,总结一下, ...
- 二叉树的深度优先遍历与广度优先遍历 [ C++ 实现 ]
深度优先搜索算法(Depth First Search),是搜索算法的一种.是沿着树的深度遍历树的节点,尽可能深的搜索树的分支. 当节点v的所有边都己被探寻过,搜索将回溯到发现节点v的那条边的起始节点 ...
- 树的深度优先遍历和广度优先遍历的原理和java实现代码
import java.util.ArrayDeque; public class BinaryTree { static class TreeNode{ int value; TreeNode le ...
- 邻接矩阵c源码(构造邻接矩阵,深度优先遍历,广度优先遍历,最小生成树prim,kruskal算法)
matrix.c #include <stdio.h> #include <stdlib.h> #include <stdbool.h> #include < ...
- C++编程练习(9)----“图的存储结构以及图的遍历“(邻接矩阵、深度优先遍历、广度优先遍历)
图的存储结构 1)邻接矩阵 用两个数组来表示图,一个一维数组存储图中顶点信息,一个二维数组(邻接矩阵)存储图中边或弧的信息. 2)邻接表 3)十字链表 4)邻接多重表 5)边集数组 本文只用代码实现用 ...
- js实现对树深度优先遍历与广度优先遍历
深度优先与广度优先的定义 首先我们先要知道什么是深度优先什么是广度优先. 深度优先遍历是指从某个顶点出发,首先访问这个顶点,然后找出刚访问这个结点的第一个未被访问的邻结点,然后再以此邻结点为顶点,继续 ...
随机推荐
- bs4-BeautifulSoup
1.BeautifulSoup下载 pip install BeautifulSoup4 或者 pip install bs4 pip install lxml #解析器 2.BeautifulSou ...
- Okhttp3源码解析(3)-Call分析(整体流程)
### 前言 前面我们讲了 [Okhttp的基本用法](https://www.jianshu.com/p/8e404d9c160f) [Okhttp3源码解析(1)-OkHttpClient分析]( ...
- poli-java开源BI软件
目录 快速入门 Github地址: 特性 一个易于使用的SQL报告应用程序,专为SQL爱好者而设计. SQL中的电源数据分析,可获得更快的业务洞察力. 快速入门 https://shzlw.githu ...
- MySQL之修改默认引擎和字符集
一.数据库引擎 1.1 查看数据库引擎 mysql> show engines; +--------------------+---------+------------------------ ...
- JDBC之批量处理
JDBC之批量处理 一.批量处理JDBC语句提高处理速度 当需要成批插入或者更新记录时.可以采用Java的批量更新机制,这一机制允许多条语句一次性提交给数据库批量处理.通常情况下比单独提交处理更有效率 ...
- C#开发BIMFACE系列9 服务端API之获取应用支持的文件类型
系列目录 [已更新最新开发文章,点击查看详细] BIMFACE最核心能力之一是工程文件格式转换.无需安装插件,支持数十种工程文件格式在云端转换,完整保留原始文件信息.开发者将告别原始文件解析烦 ...
- P1357 花园 状压 矩阵快速幂
题意 小L有一座环形花园,沿花园的顺时针方向,他把各个花圃编号为1~N(2<=N<=10^15).他的环形花园每天都会换一个新花样,但他的花园都不外乎一个规则,任意相邻M(2<=M& ...
- SPOJ - 3267. D-query 主席树求区间个数
SPOJ - 3267 主席树的又一种写法. 从后端点开始添加主席树, 然后如果遇到出现过的元素先把那个点删除, 再更新树, 最后查询区间就好了. #include<bits/stdc++.h& ...
- 最短路算法 Dijkstra 入门
dijkstra算法 是一种单源点最短路算法求出一个点到其他所有点的最短路. 给你这样的一个图,需要求出1号点到其他点的最短距离是多少. 首先我们开一个数组 d[N],d[x] 代表着从起点出发到x点 ...
- CodeForces 1084 F Max Mex
Max Mex 题意:问在树上的所有路中mex值最大是多少. 题解: 用线段树维护值. 区间[L,R]意味着 区间[L,R]的数可不可以合并. 重点就是合并的问题了. 首先合法的区间只有3种: 1. ...