
scrapy 知乎用户信息爬虫
zhihu_spider
此项目的功能是爬取知乎用户信息以及人际拓扑关系,爬虫框架使用scrapy,数据存储使用mongo,下载这些数据感觉也没什么用,就当为大家学习scrapy提供一个例子吧。代码地址:https://github.com/LiuRoy/zhihu_spider,欢迎各位大神指出问题,另外知乎也欢迎大家关注哈 ^_^.
流程图
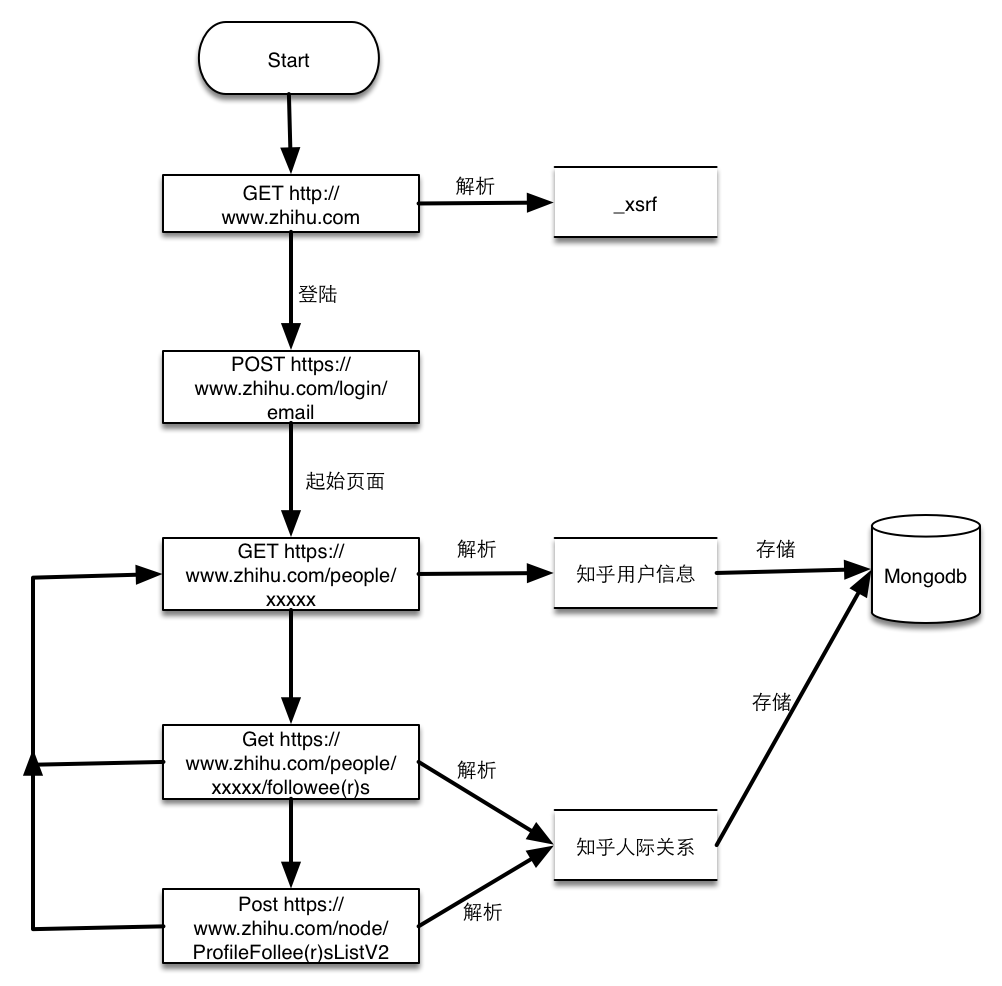
- 请求https://www.zhihu.com获取页面中的_xsrf数据,知乎开启了跨站请求伪造功能,所有的POST请求都必须带上此参数。
- 提交用户名,密码已经第一步解析的_xsrf参数到https://www.zhihu.com/login/email,登陆获取cookies
- 访问用户主页,以我的主页为例https://www.zhihu.com/people/weizhi-xiazhi, 如下图:
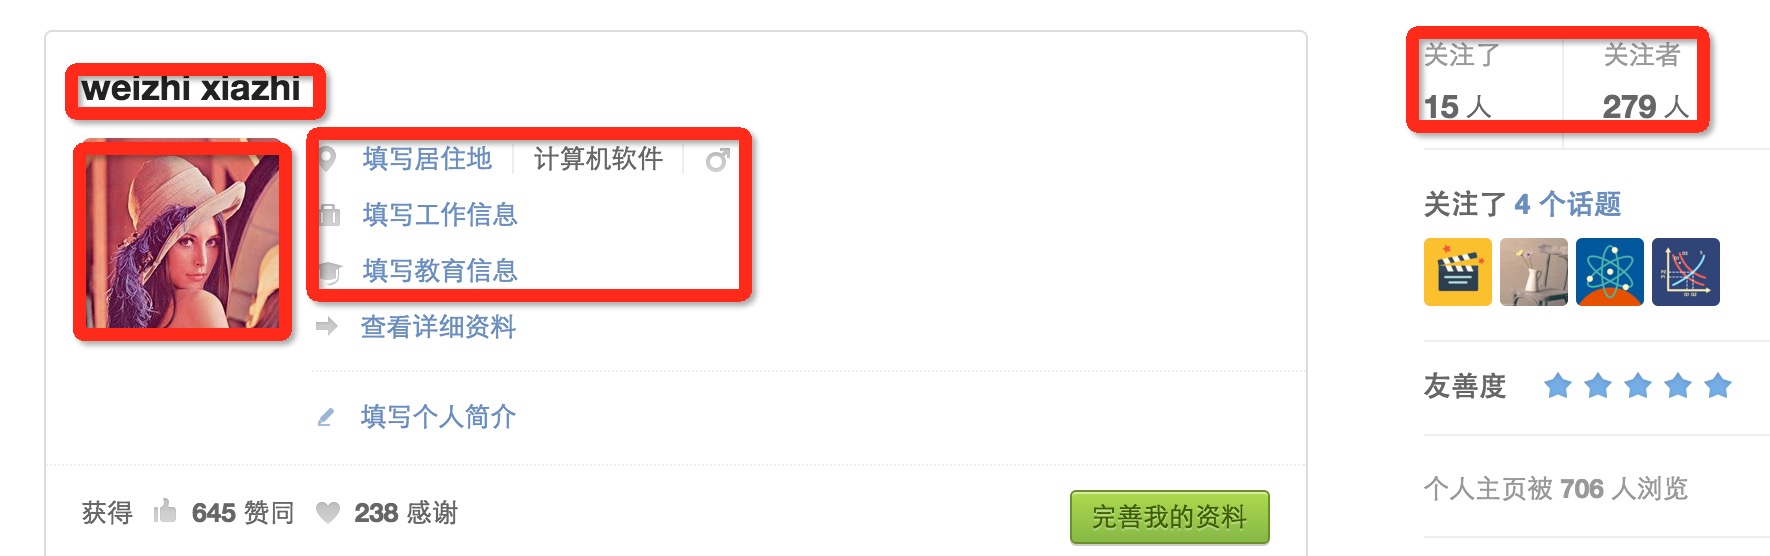
- 解析的用户信息包括昵称,头像链接,个人基本信息还有关注人的数量和粉丝的数量。这个页面还能获取关注人页面和粉丝页面。
- 由上一步获取的分页列表页面和关注人页面获取用户人际关系,这两个页面类似,唯一麻烦的是得到的静态页面最多只有二十个,获取全部的人员必须通过POST请求,解析到的个人主页再由上一步来解析。
代码解释
scrapy文档非常详细,在此我就不详细讲解,你所能碰到的任何疑问都可以在文档中找到解答。
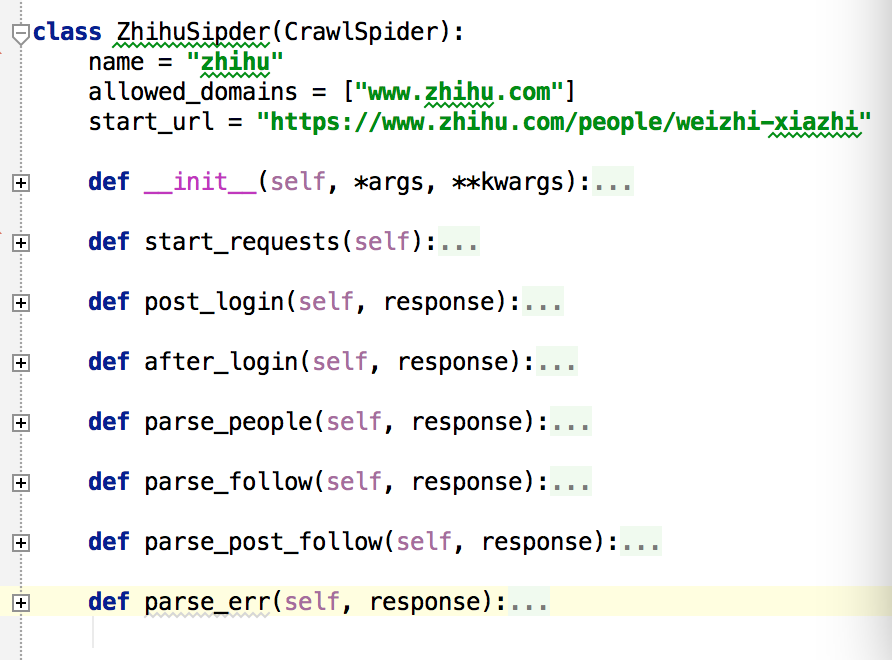
- 爬虫框架从start_requests开始执行,此部分会提交知乎主页的访问请求给引擎,并设置回调函数为post_login.
- post_login解析主页获取_xsrf保存为成员变量中,并提交登陆的POST请求,设置回调函数为after_login.
- after_login拿到登陆后的cookie,提交一个start_url的GET请求给爬虫引擎,设置回调函数parse_people.
- parse_people解析个人主页,一次提交关注人和粉丝列表页面到爬虫引擎,回调函数是parse_follow, 并把解析好的个人数据提交爬虫引擎写入mongo。
- parse_follow会解析用户列表,同时把动态的人员列表POST请求发送只引擎,回调函数是parse_post_follow,把解析好的用户主页链接请求也发送到引擎,人员关系写入mongo。
- parse_post_follow单纯解析用户列表,提交用户主页请求至引擎。
效果图
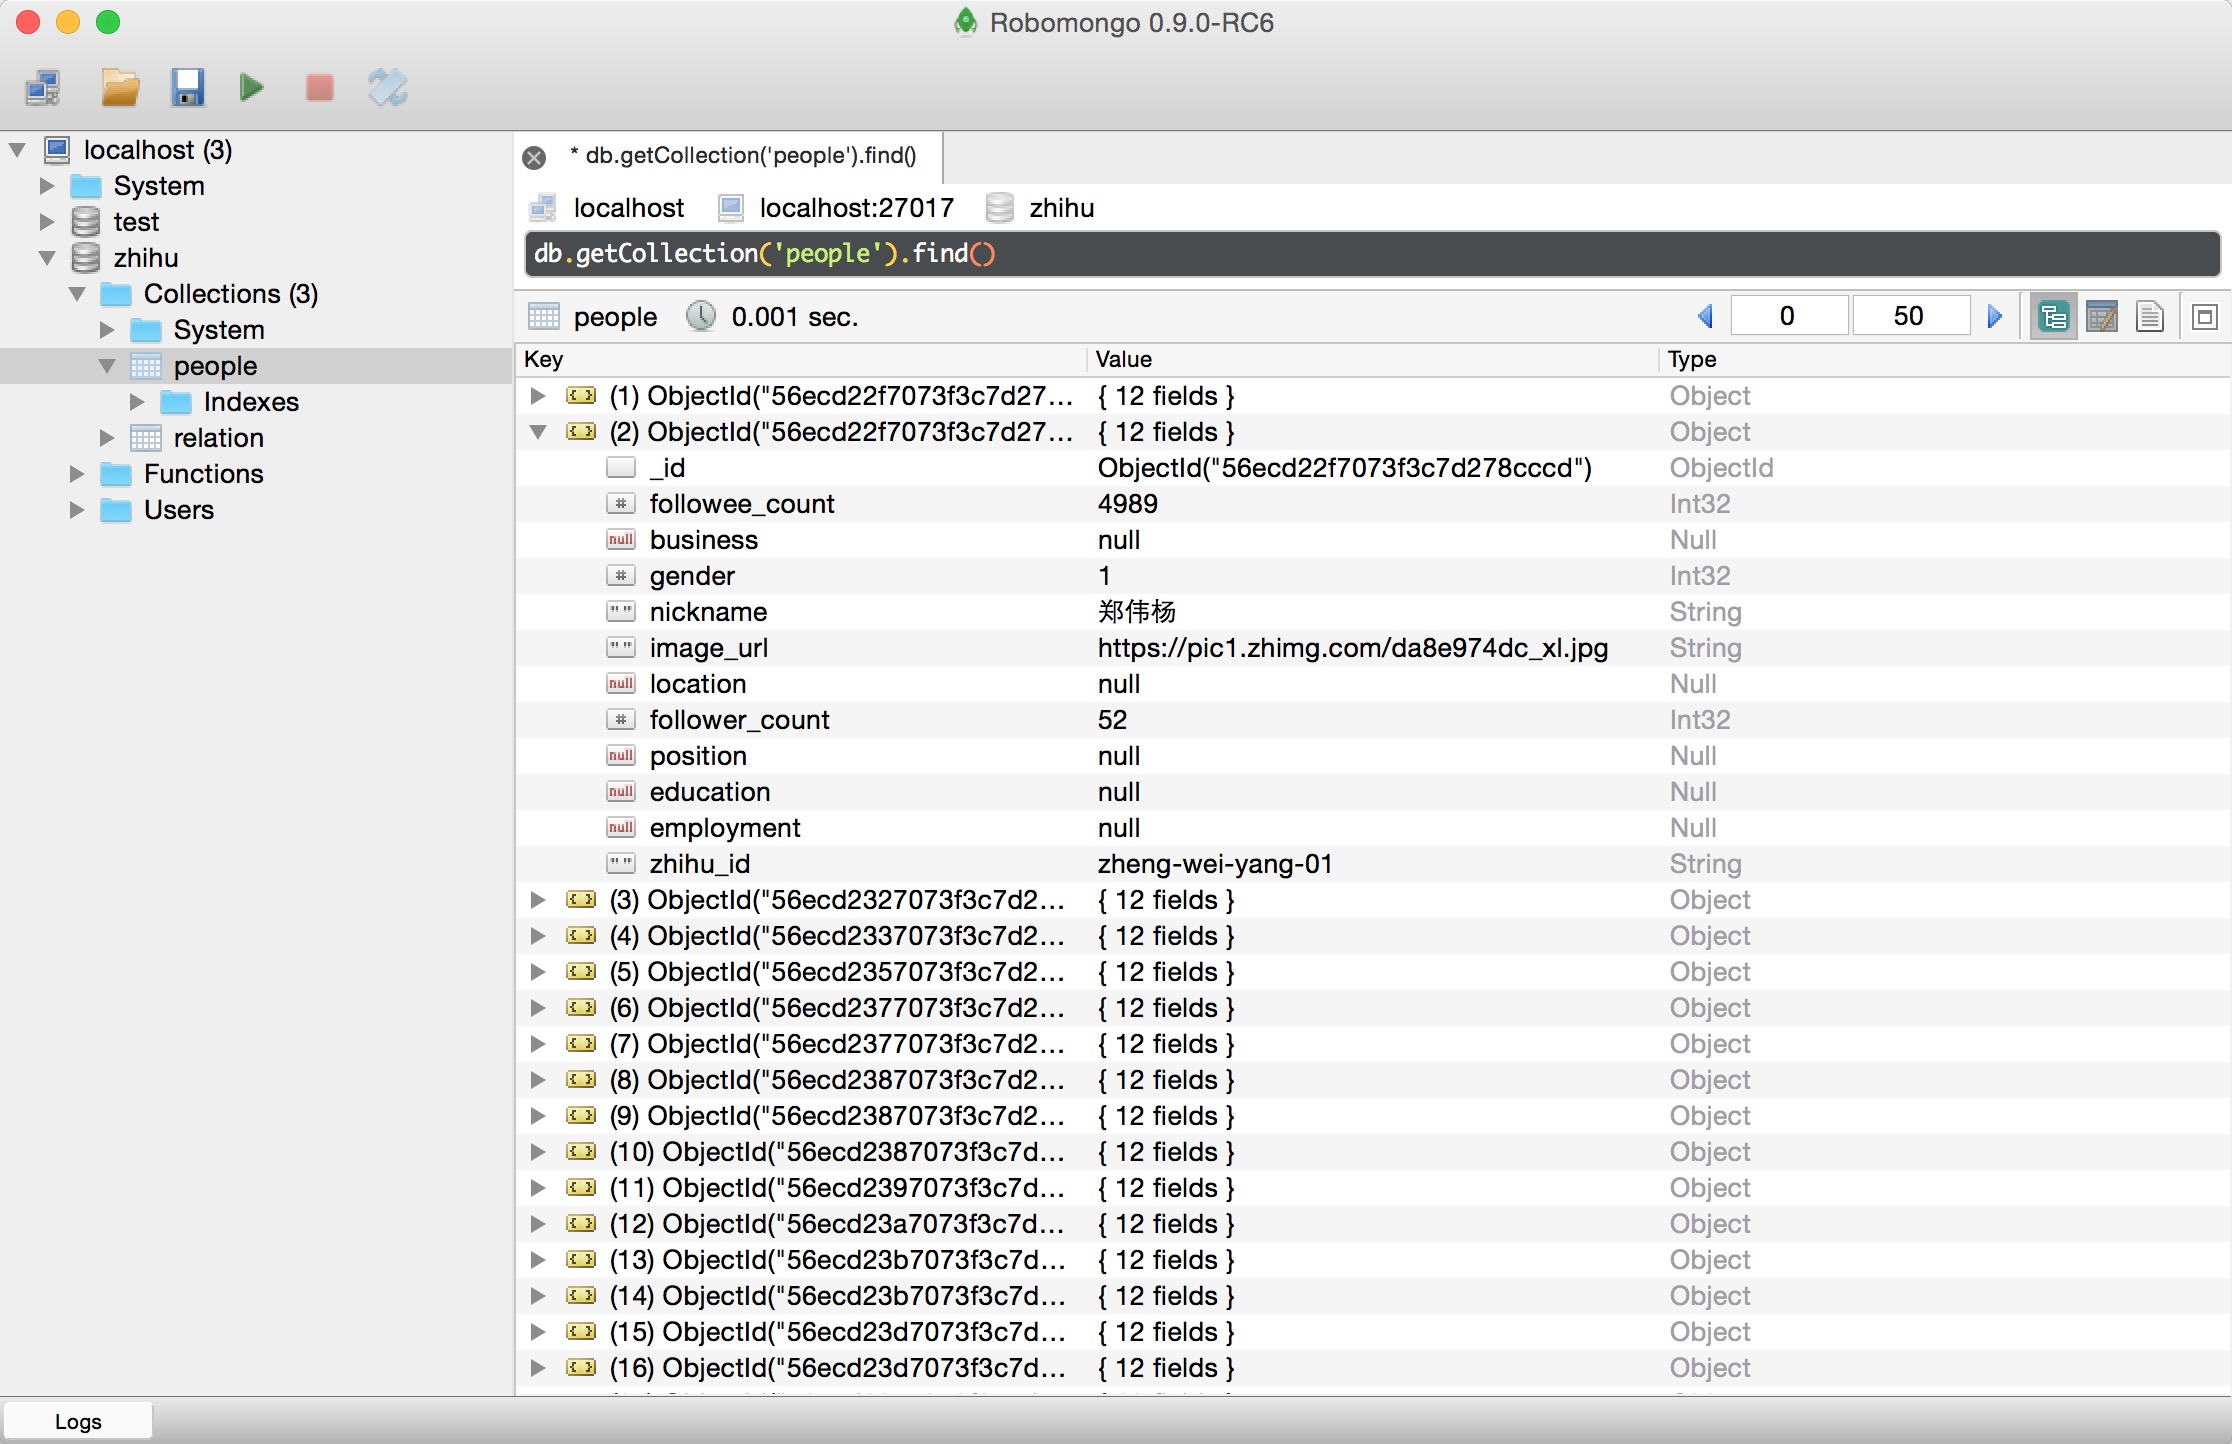
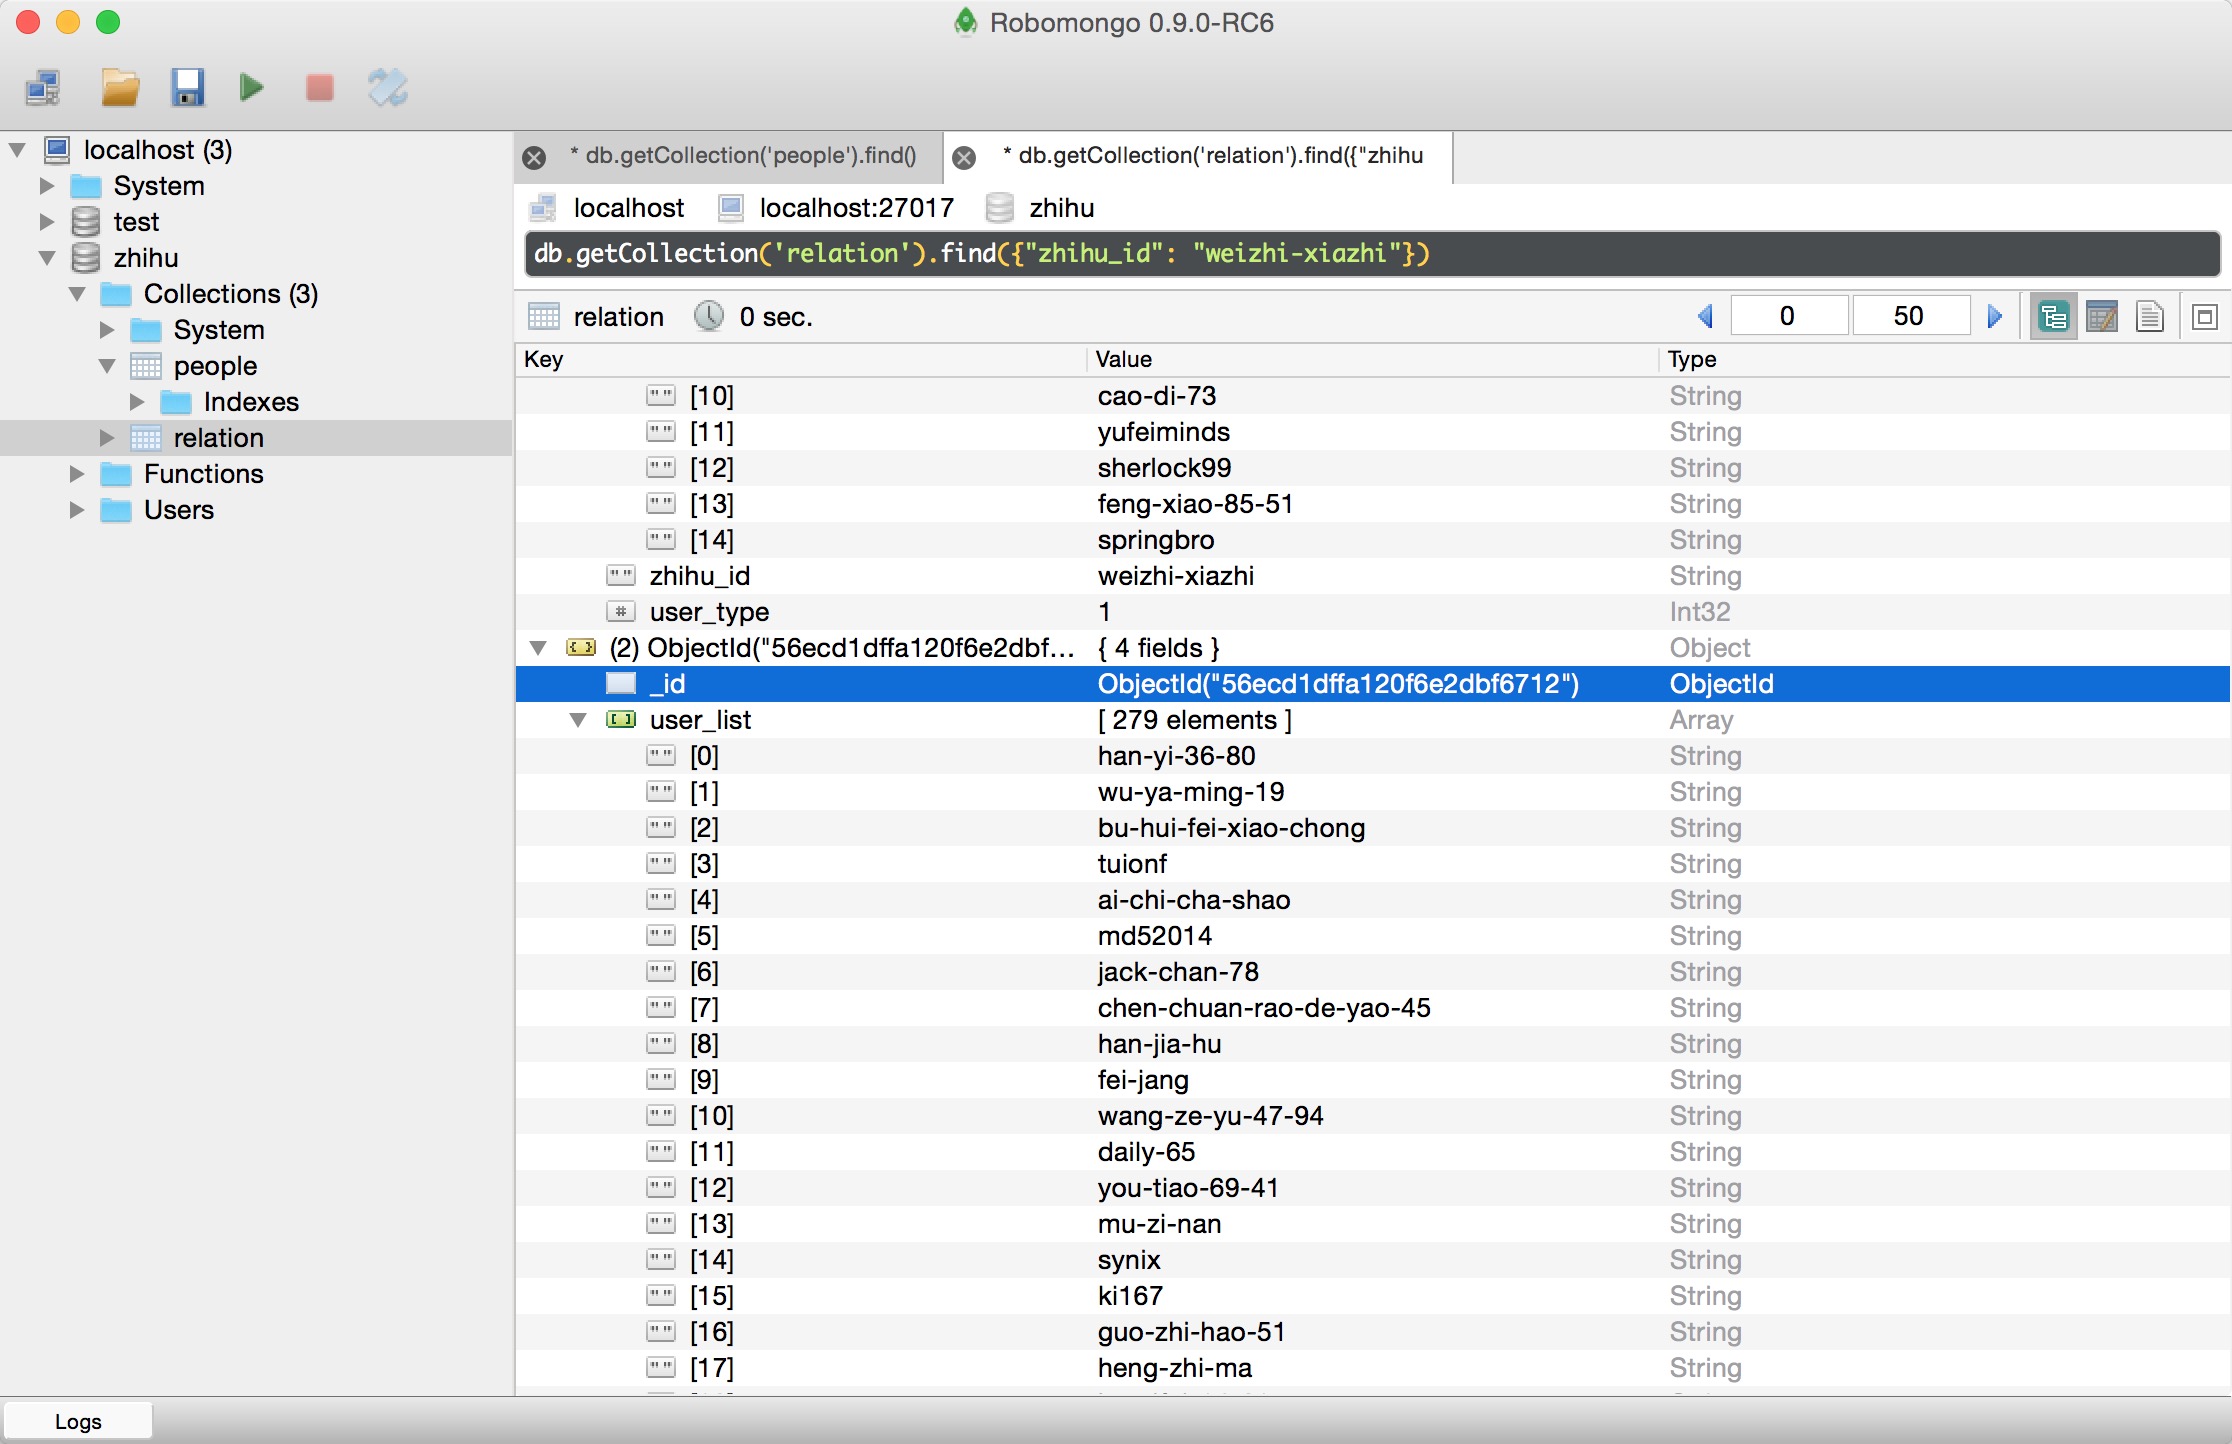
scrapy 知乎用户信息爬虫的更多相关文章
- 基于webmagic的爬虫小应用--爬取知乎用户信息
听到“爬虫”,是不是第一时间想到Python/php ? 多少想玩爬虫的Java学习者就因为语言不通而止步.Java是真的不能做爬虫吗? 当然不是. 只不过python的3行代码能解决的问题,而Jav ...
- scrapy爬取全部知乎用户信息
# -*- coding: utf-8 -*- # scrapy爬取全部知乎用户信息 # 1:是否遵守robbots_txt协议改为False # 2: 加入爬取所需的headers: user-ag ...
- python3编写网络爬虫22-爬取知乎用户信息
思路 选定起始人 选一个关注数或者粉丝数多的大V作为爬虫起始点 获取粉丝和关注列表 通过知乎接口获得该大V的粉丝列表和关注列表 获取列表用户信息 获取列表每个用户的详细信息 获取每个用户的粉丝和关注 ...
- Python爬虫从入门到放弃(十八)之 Scrapy爬取所有知乎用户信息(上)
爬取的思路 首先我们应该找到一个账号,这个账号被关注的人和关注的人都相对比较多的,就是下图中金字塔顶端的人,然后通过爬取这个账号的信息后,再爬取他关注的人和被关注的人的账号信息,然后爬取被关注人的账号 ...
- Scrapy爬虫框架第八讲【项目实战篇:知乎用户信息抓取】--本文参考静觅博主所写
思路分析: (1)选定起始人(即选择关注数和粉丝数较多的人--大V) (2)获取该大V的个人信息 (3)获取关注列表用户信息 (4)获取粉丝列表用户信息 (5)重复(2)(3)(4)步实现全知乎用户爬 ...
- 爬虫(十六):scrapy爬取知乎用户信息
一:爬取思路 首先我们应该找到一个账号,这个账号被关注的人和关注的人都相对比较多的,就是下图中金字塔顶端的人,然后通过爬取这个账号的信息后,再爬取他关注的人和被关注的人的账号信息,然后爬取被关注人的账 ...
- Python之爬虫(二十) Scrapy爬取所有知乎用户信息(上)
爬取的思路 首先我们应该找到一个账号,这个账号被关注的人和关注的人都相对比较多的,就是下图中金字塔顶端的人,然后通过爬取这个账号的信息后,再爬取他关注的人和被关注的人的账号信息,然后爬取被关注人的账号 ...
- Python爬虫从入门到放弃(十九)之 Scrapy爬取所有知乎用户信息(下)
在上一篇文章中主要写了关于爬虫过程的分析,下面是代码的实现,完整代码在:https://github.com/pythonsite/spider items中的代码主要是我们要爬取的字段的定义 cla ...
- Python之爬虫(二十一) Scrapy爬取所有知乎用户信息(下)
在上一篇文章中主要写了关于爬虫过程的分析,下面是代码的实现,完整代码在:https://github.com/pythonsite/spider items中的代码主要是我们要爬取的字段的定义 cla ...
随机推荐
- java基础集合经典训练题
第一题:要求产生10个随机的字符串,每一个字符串互相不重复,每一个字符串中组成的字符(a-zA-Z0-9)也不相同,每个字符串长度为10; 分析:*1.看到这个题目,或许你脑海中会想到很多方法,比如判 ...
- 从0开始搭建SQL Server AlwaysOn 第四篇(配置异地机房节点)
从0开始搭建SQL Server AlwaysOn 第四篇(配置异地机房节点) 第一篇http://www.cnblogs.com/lyhabc/p/4678330.html第二篇http://www ...
- TDD在Unity3D游戏项目开发中的实践
0x00 前言 关于TDD测试驱动开发的文章已经有很多了,但是在游戏开发尤其是使用Unity3D开发游戏时,却听不到特别多关于TDD的声音.那么本文就来简单聊一聊TDD如何在U3D项目中使用以及如何使 ...
- TSQL Identity 用法全解
Identity是标识值,在SQL Server中,有ID列,ID属性,ID值,ID列的值等术语. Identity属性是指在创建Table时,为列指定的Identity属性,其语法是:column_ ...
- android键盘
在应用的开发过程中有不少的情况下会用到自定义键盘,例如支付宝的支付密码的输入,以及类似的场景.android系统给开发者们提供了系统键盘,KeyboardView,其实并不复杂,只是有些开发者不知道罢 ...
- 对Thoughtworks的有趣笔试题实践
记得2014年在网上看到Thoughtworks的一道笔试题,当时觉得挺有意思,但是没动手去写.这几天又在网上看到了,于是我抽了一点时间写了下,我把程序运行的结果跟网上的答案对了一下,应该是对的,但是 ...
- 我大中华微软MVP中国区人才库
刘海峰:国内知名微软开源技术网站51Aspx 创始人,十年以上的Asp.net从业经验,微软MSDN特约讲师.Teched讲师.ImagineCup大赛评委.人大出版社研修班特约讲师,曾多次受邀访问美 ...
- bzoj3207--Hash+主席树
题目大意: 给定一个n个数的序列和m个询问(n,m<=100000)和k,每个询问包含k+2个数字:l,r,b[1],b[2]...b[k],要求输出b[1]~b[k]在[l,r]中是否出现. ...
- Html 制作相册
本文主要讲述采用Html5+jQuery+CSS 制作相册的小小记录. 主要功能点: Html5进行布局 调用jQuery(借用官网的一句话:The Write Less, Do More)极大的简化 ...
- Unity插件之plyGame教程:DiaQ对话系统
本文为孤月蓝风编写,转载请注明出处:http://fengyu.name/?cat=game&id=296 DiaQ是plyGame旗下的一款对话及任务系统.拥有可视化的对话及任务编辑器,能够 ...