
Python爬虫从入门到放弃(十八)之 Scrapy爬取所有知乎用户信息(上)
爬取的思路
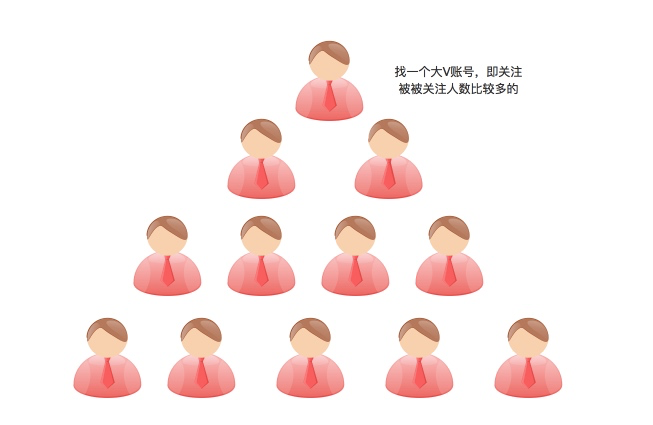
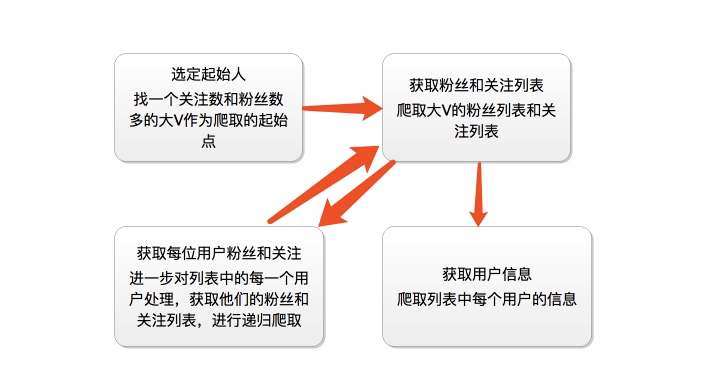
首先我们应该找到一个账号,这个账号被关注的人和关注的人都相对比较多的,就是下图中金字塔顶端的人,然后通过爬取这个账号的信息后,再爬取他关注的人和被关注的人的账号信息,然后爬取被关注人的账号信息和被关注信息的关注列表,爬取这些用户的信息,通过这种递归的方式从而爬取整个知乎的所有的账户信息。整个过程通过下面两个图表示:
爬虫分析过程
这里我们找的账号地址是:https://www.zhihu.com/people/excited-vczh/answers
我们抓取的大V账号的主要信息是:

其次我们要获取这个账号的关注列表和被关注列表
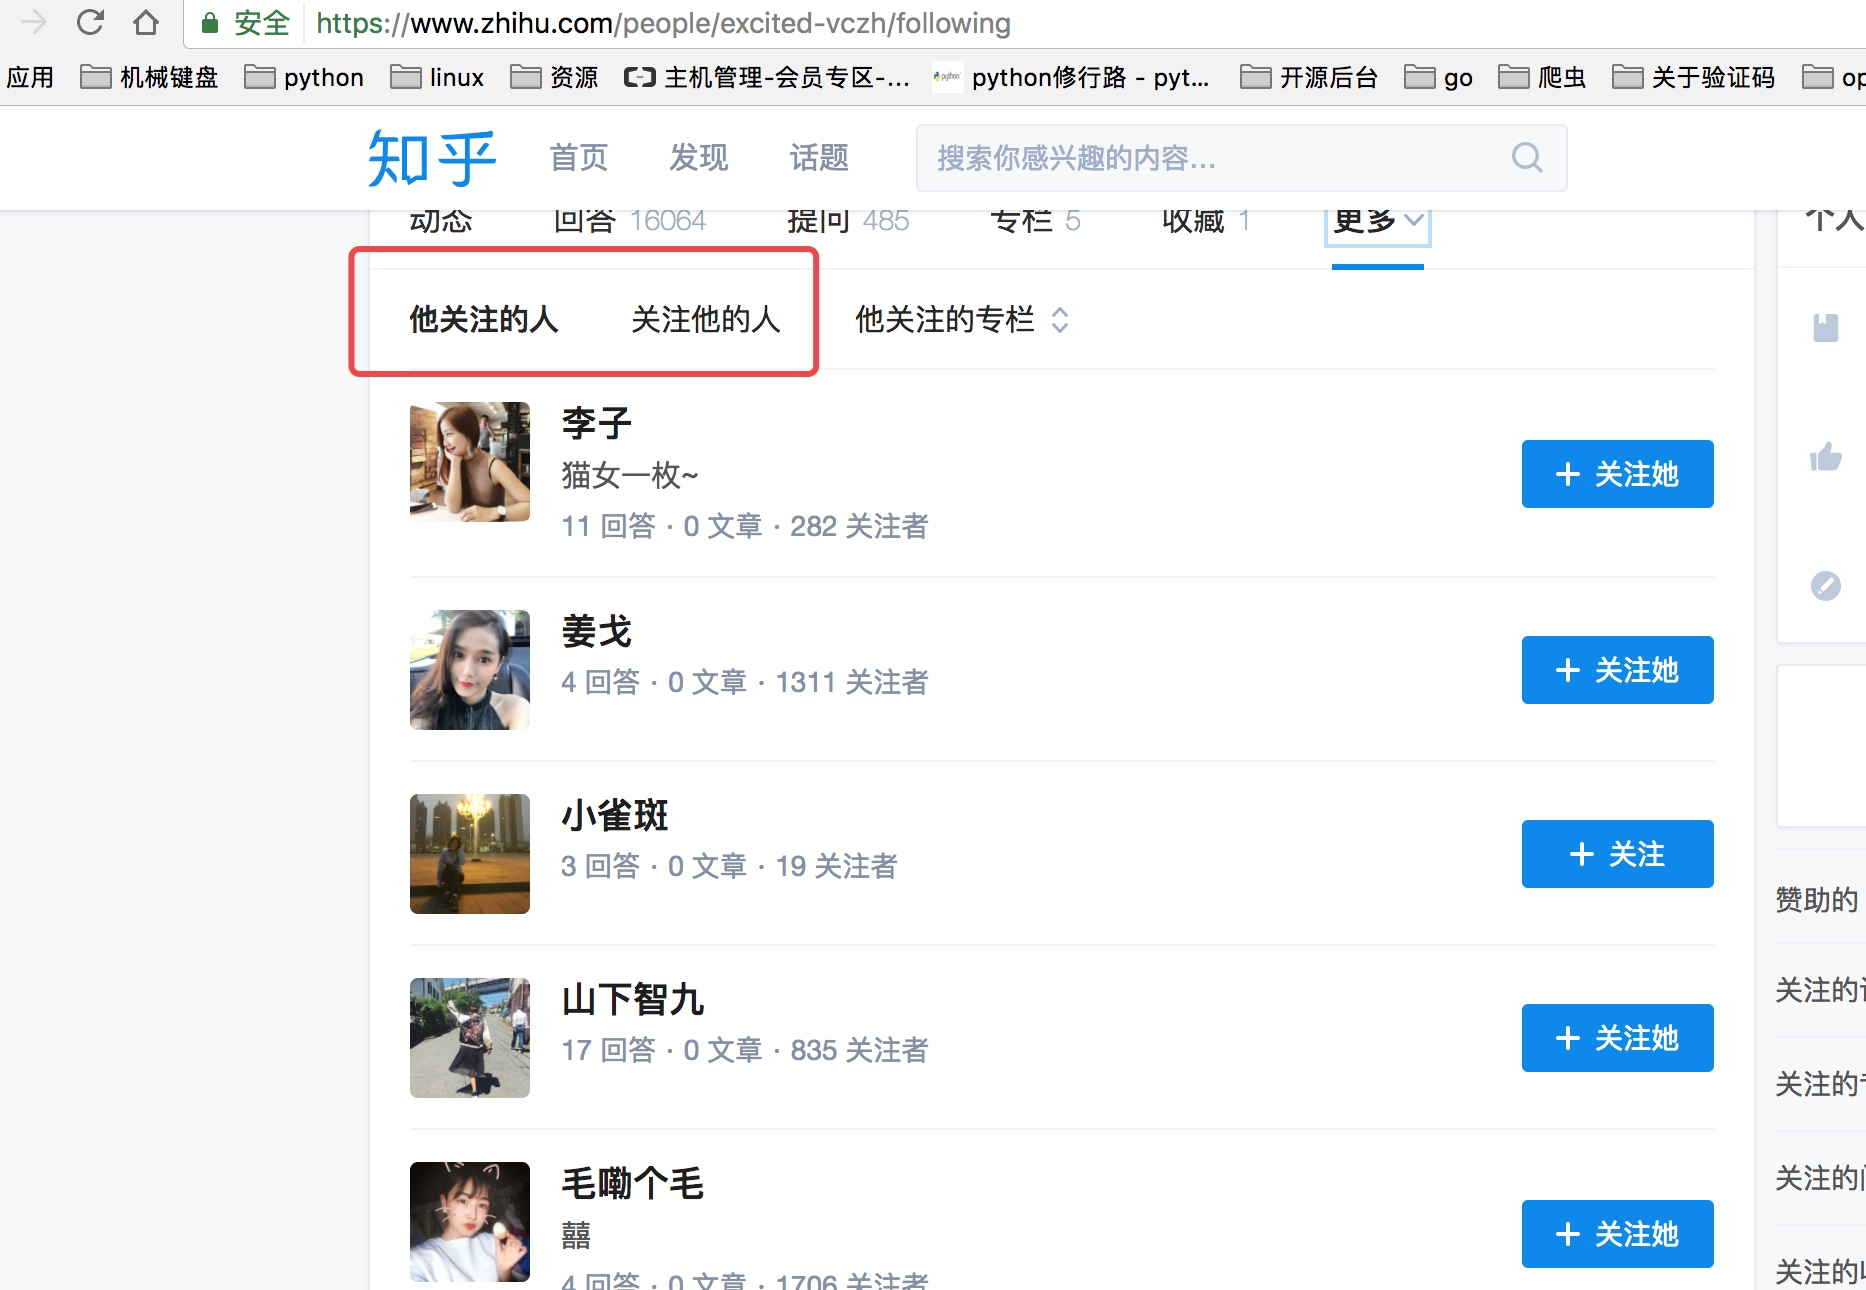
这里我们需要通过抓包分析如果获取这些列表的信息以及用户的个人信息内容
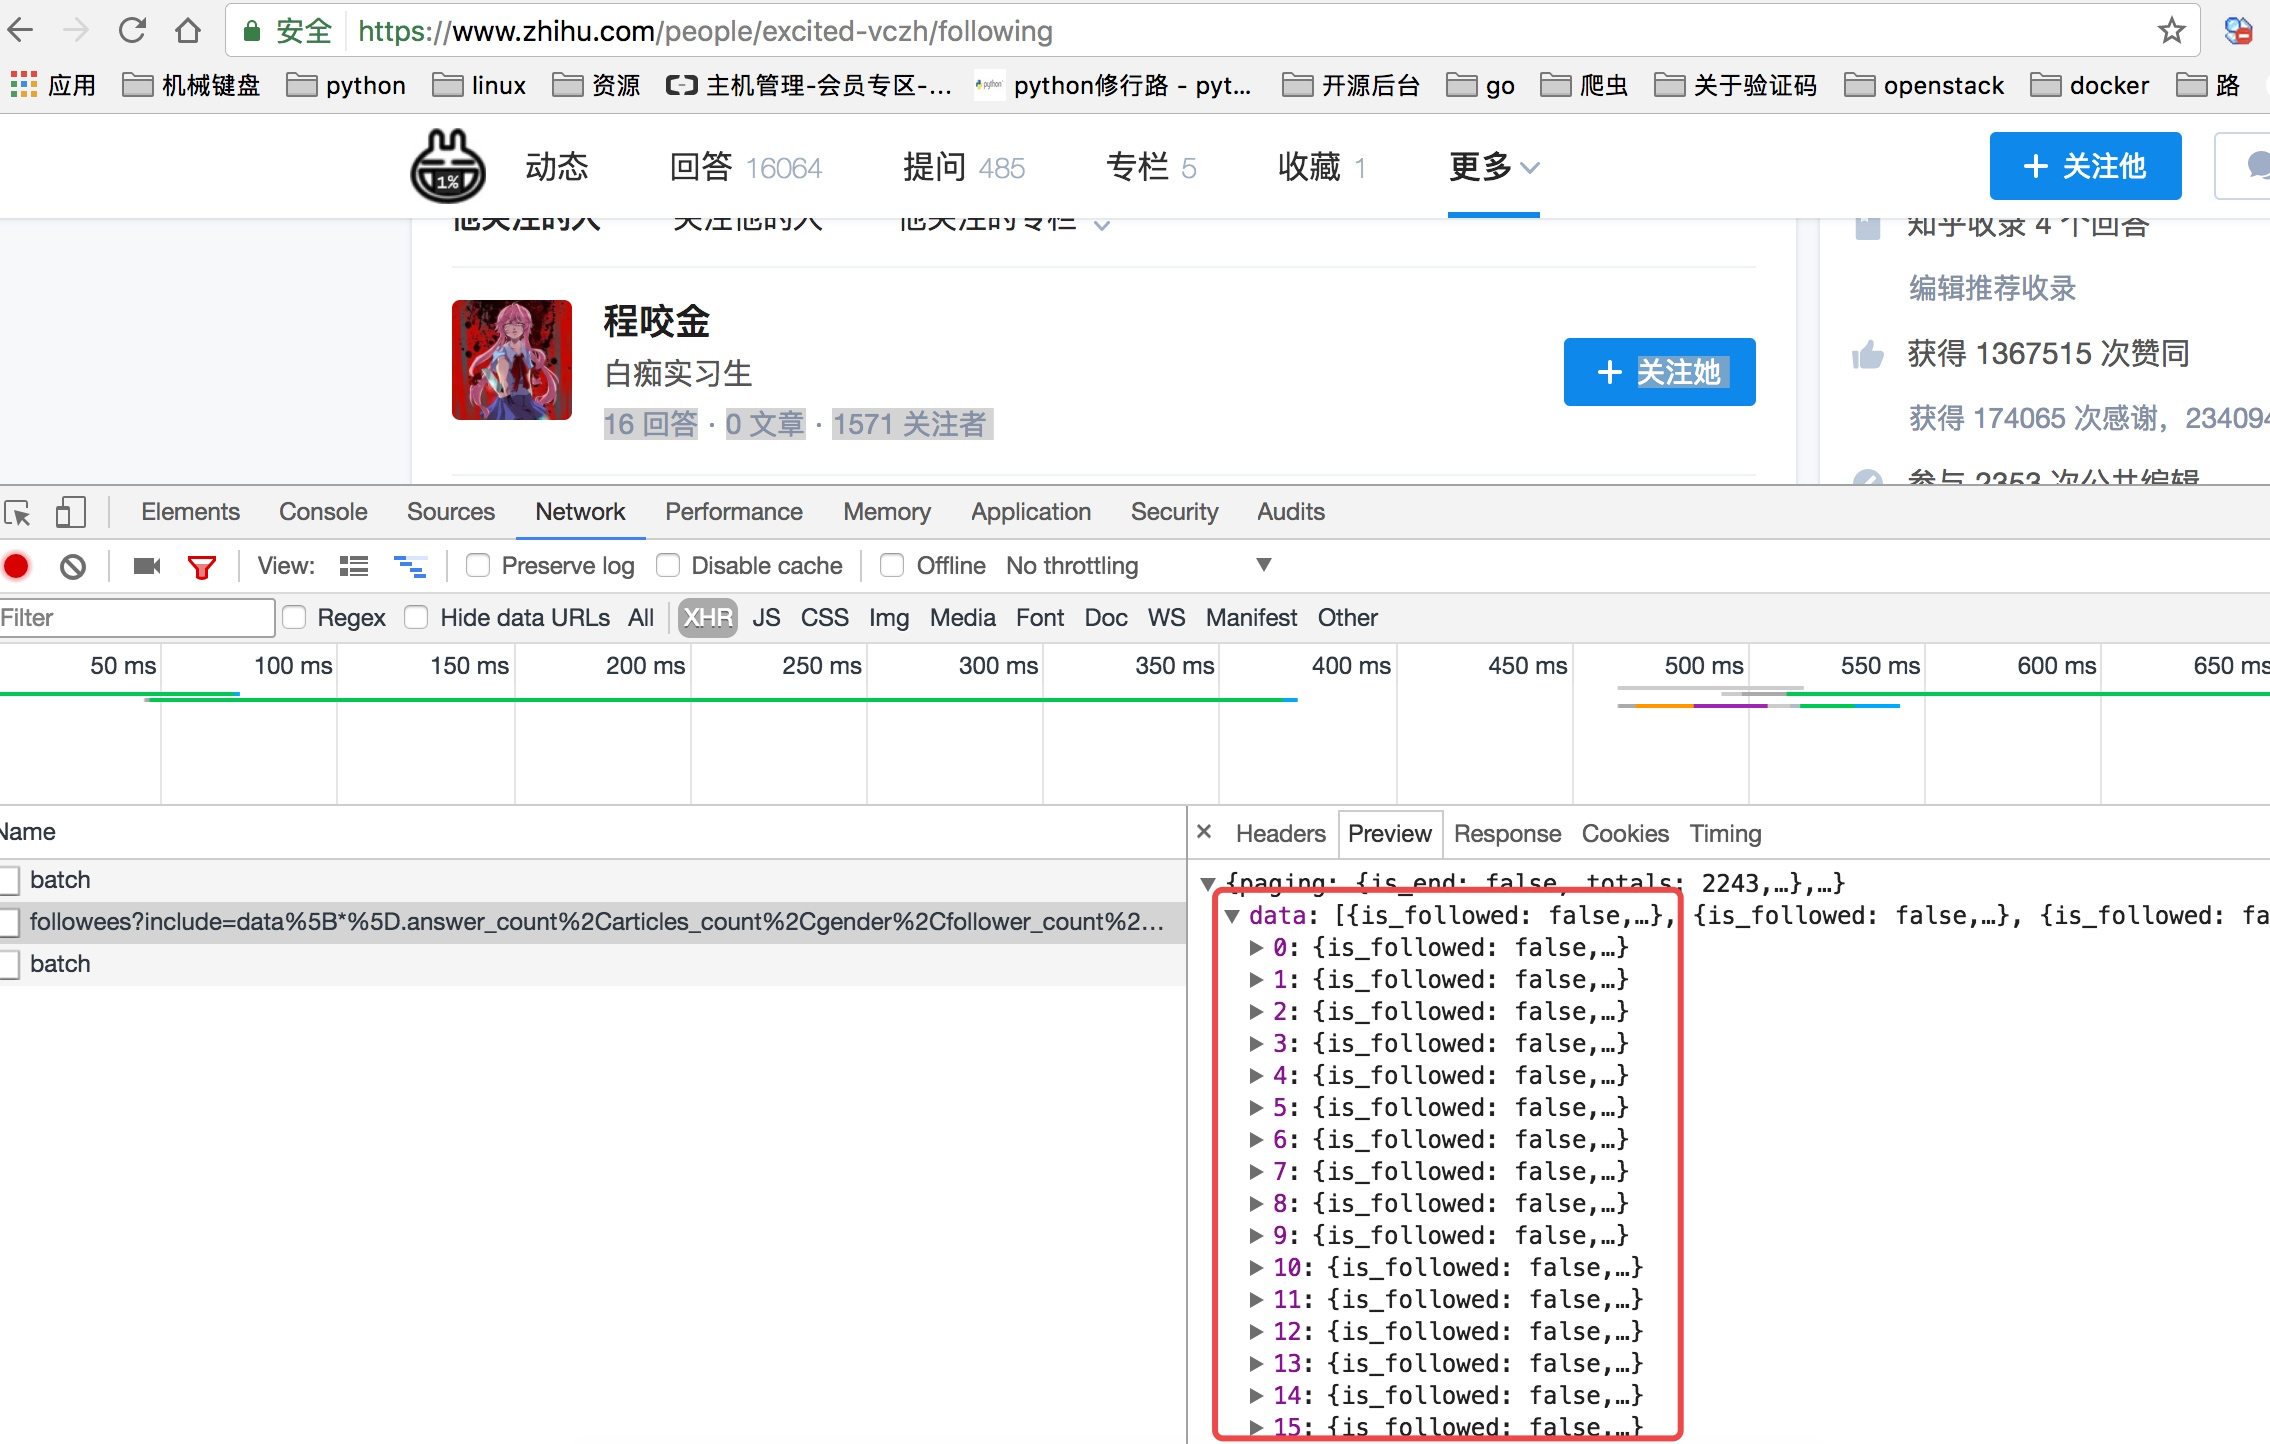
当我们查看他关注人的列表的时候我们可以看到他请求了如下图中的地址,并且我们可以看到返回去的结果是一个json数据,而这里就存着一页关乎的用户信息。


上面虽然可以获取单个用户的个人信息,但是不是特别完整,这个时候我们获取一个人的完整信息地址是当我们将鼠标放到用户名字上面的时候,可以看到发送了一个请求:
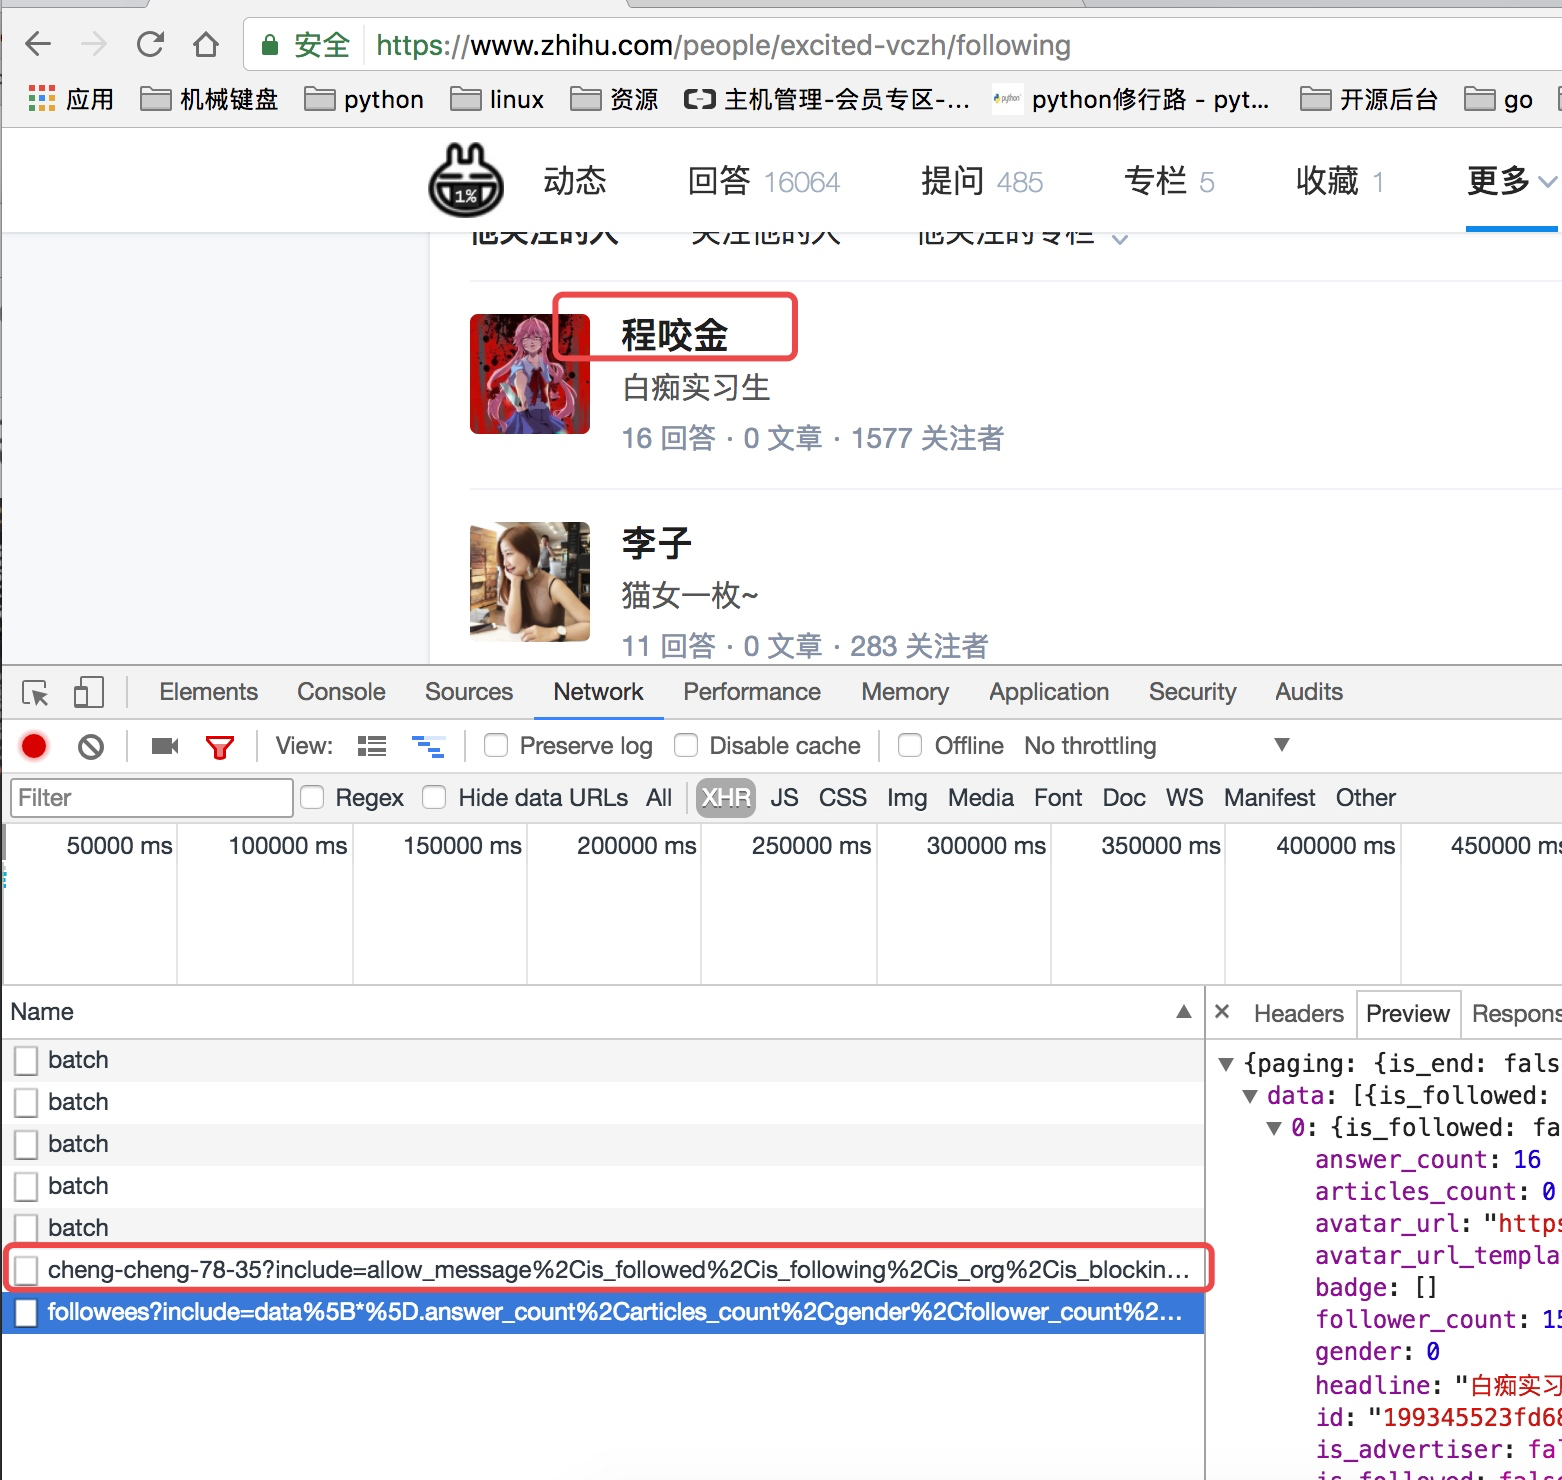
我们可以看这个地址的返回结果可以知道,这个地址请求获取的是用户的详细信息:

通过上面的分析我们知道了以下两个地址:
获取用户关注列表的地址:https://www.zhihu.com/api/v4/members/excited-vczh/followees?include=data%5B*%5D.answer_count%2Carticles_count%2Cgender%2Cfollower_count%2Cis_followed%2Cis_following%2Cbadge%5B%3F(type%3Dbest_answerer)%5D.topics&offset=0&limit=20
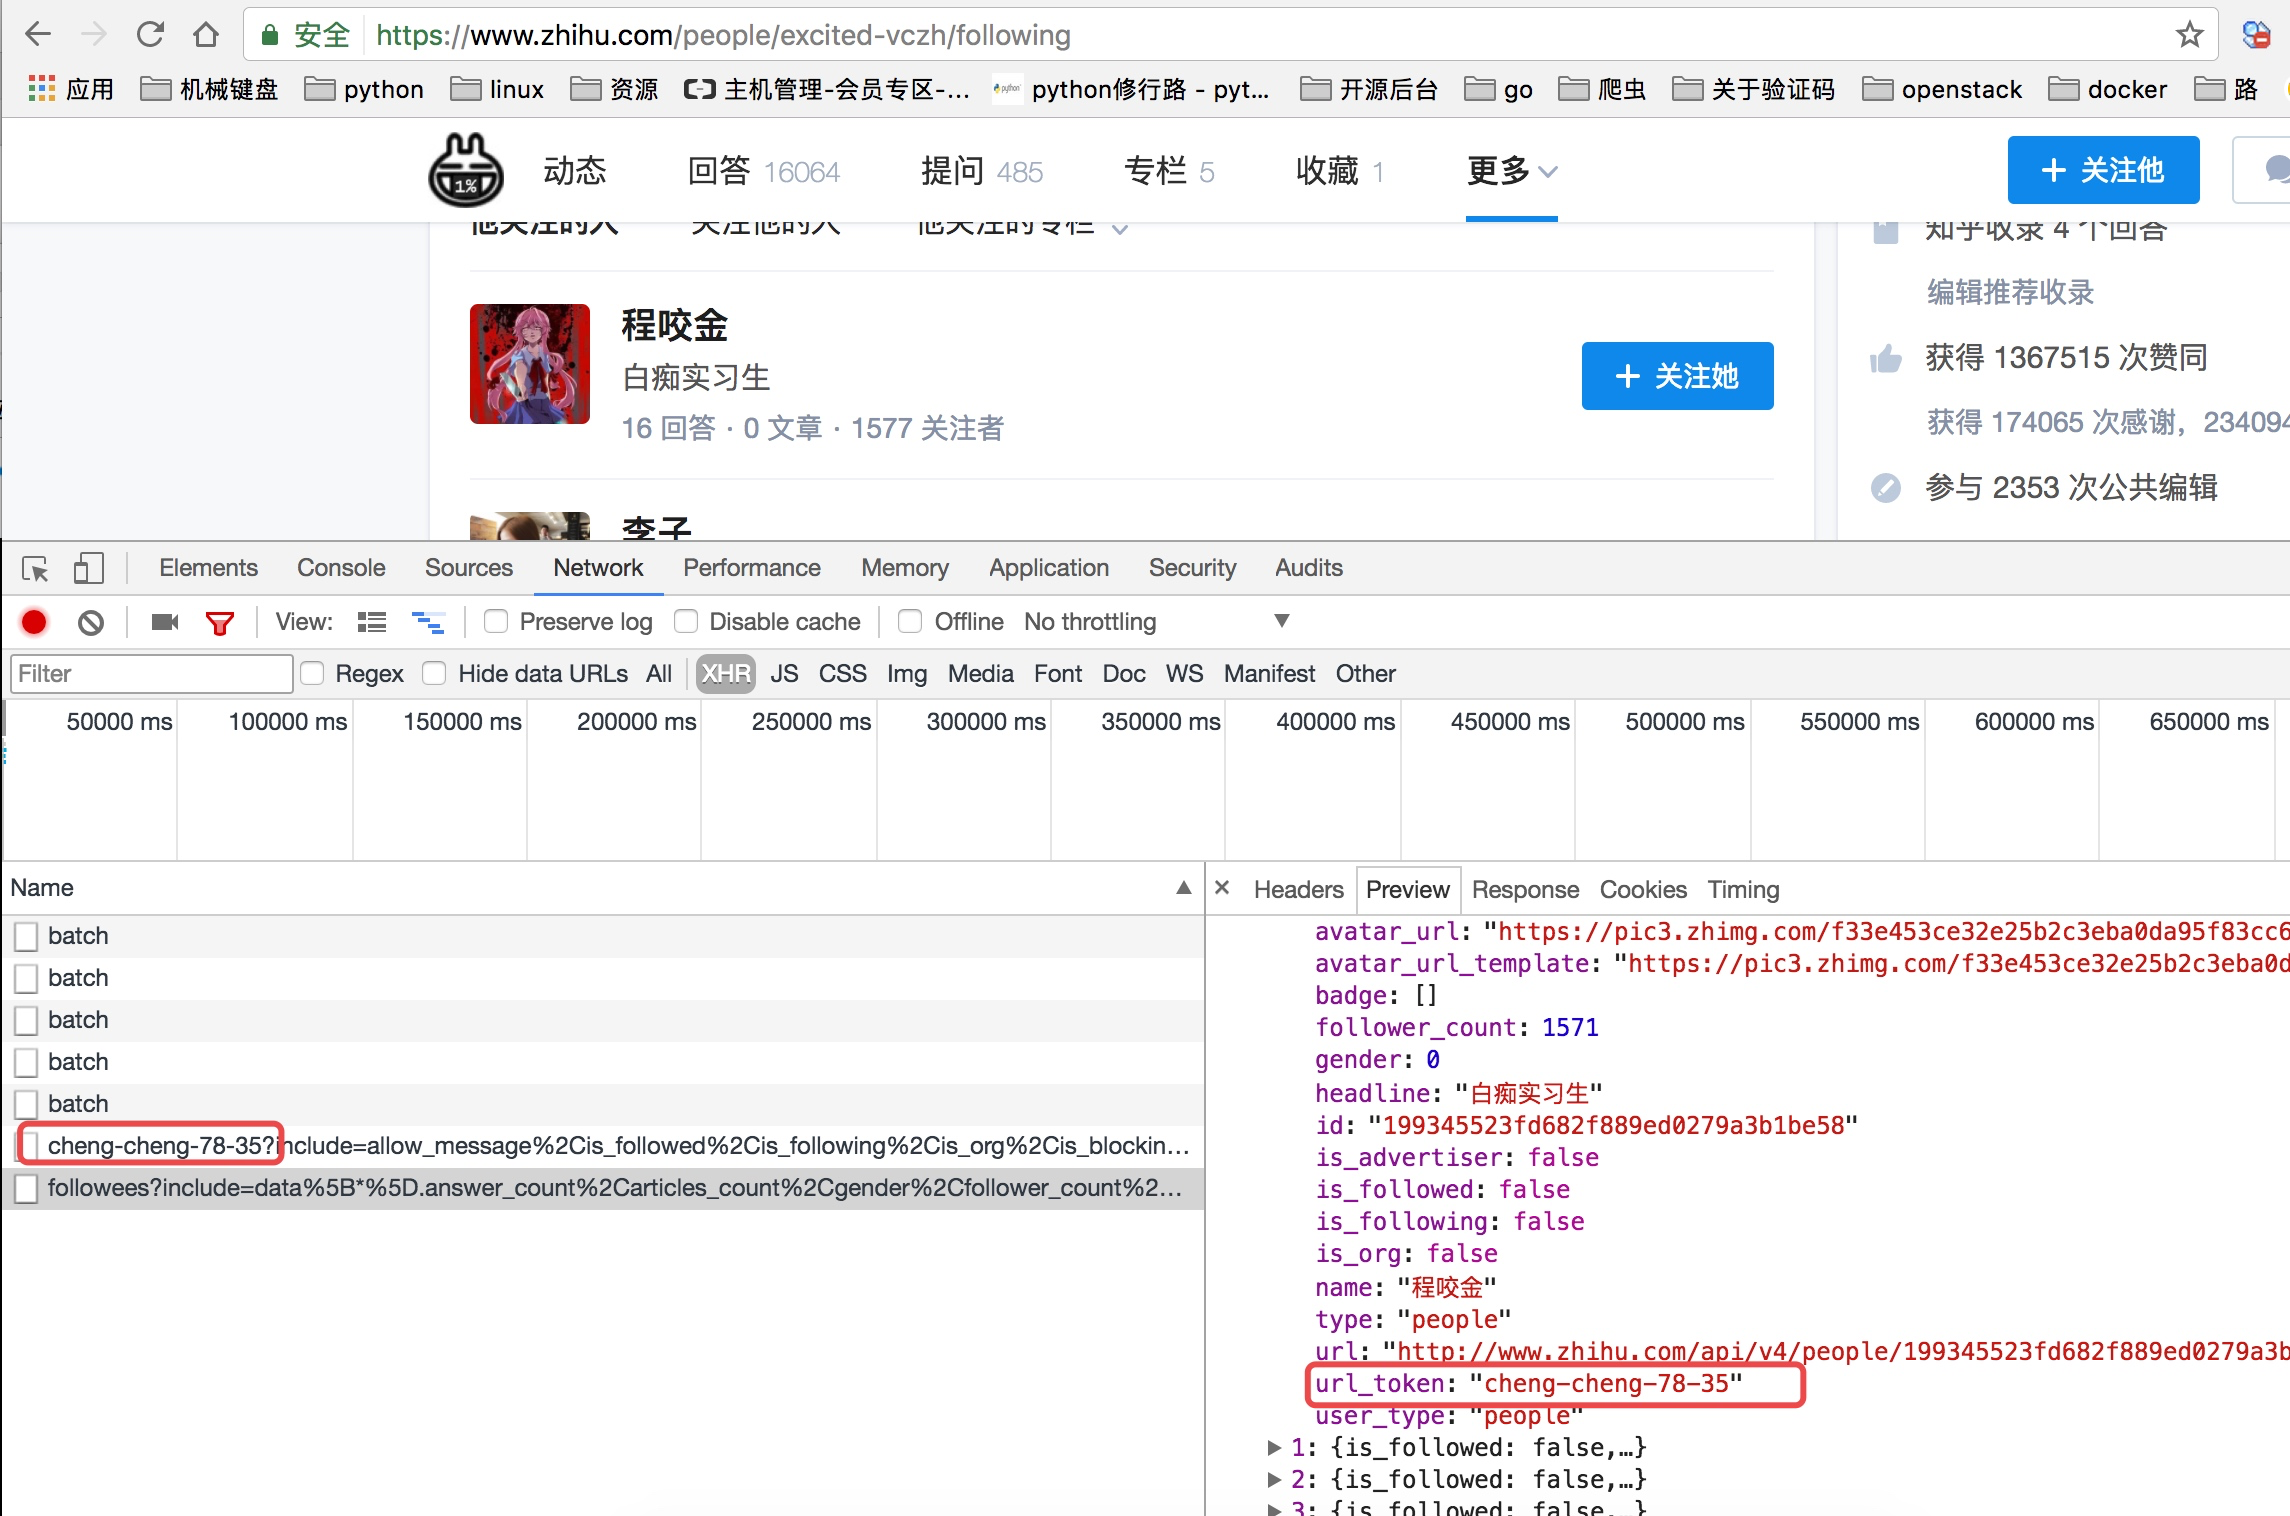
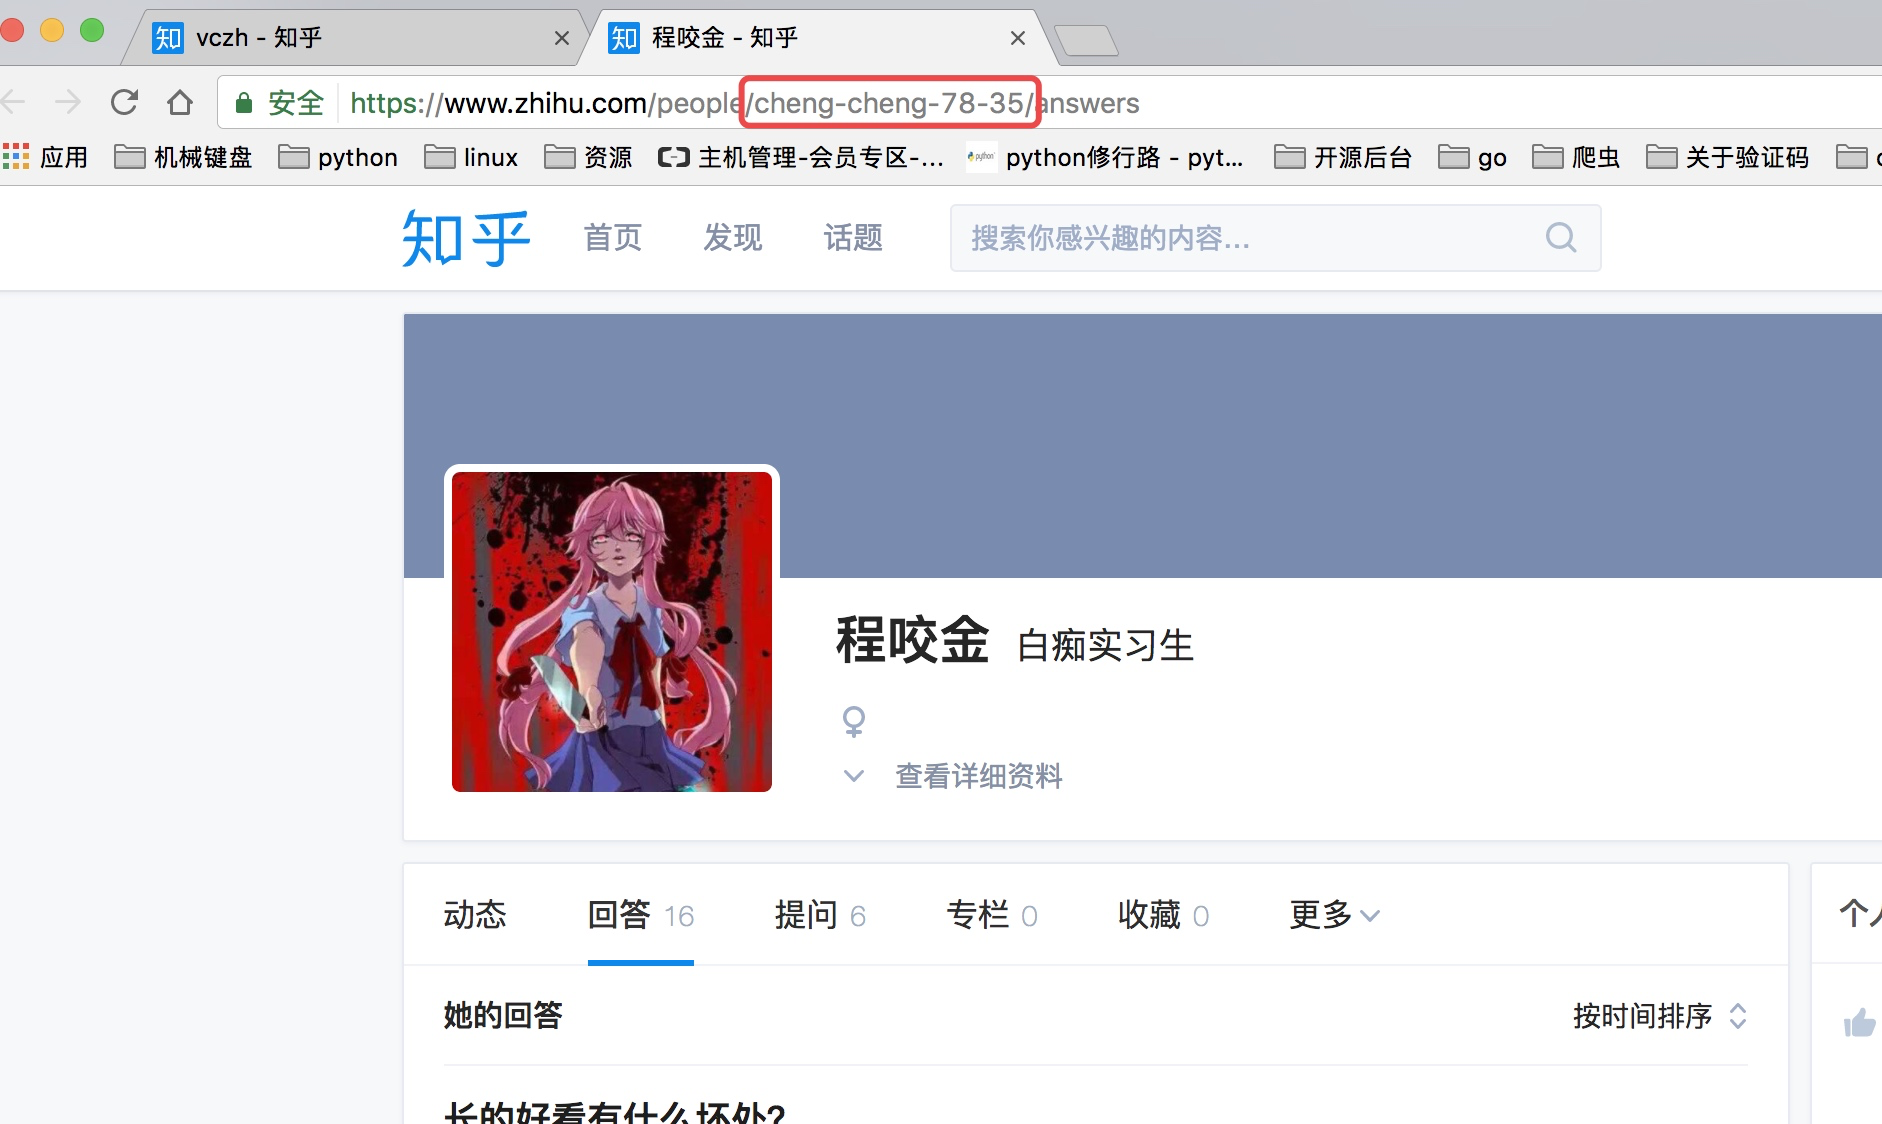
这里我们可以从请求的这两个地址里发现一个问题,关于用户信息里的url_token其实就是获取单个用户详细信息的一个凭证也是请求的一个重要参数,并且当我们点开关注人的的链接时发现请求的地址的唯一标识也是这个url_token
创建项目进行再次分析
通过命令创建项目
scrapy startproject zhihu_user
cd zhihu_user
scrapy genspider zhihu www.zhihu.com
直接通过scrapy crawl zhihu启动爬虫会看到如下错误:

这个问题其实是爬取网站的时候经常碰到的问题,大家以后见多了就知道是怎么回事了,是请求头的问题,应该在请求头中加User-Agent,在settings配置文件中有关于请求头的配置默认是被注释的,我们可以打开,并且加上User-Agent,如下:
关于如何获取User-Agent,可以在抓包的请求头中看到也可以在谷歌浏览里输入:chrome://version/ 查看
这样我们就可以正常通过代码访问到知乎了
然后我们可以改写第一次的请求,这个我们前面的scrapy文章关于spiders的时候已经说过如何改写start_request,我们让第一次请求分别请求获取用户列表以及获取用户信息

这个时候我们再次启动爬虫

我们会看到是一个401错误,而解决的方法其实还是请求头的问题,从这里我们也可以看出请求头中包含的很多信息都会影响我们爬取这个网站的信息,所以当我们很多时候直接请求网站都无法访问的时候就可以去看看请求头,看看是不是请求头的哪些信息导致了请求的结果,而这里则是因为如下图所示的参数:
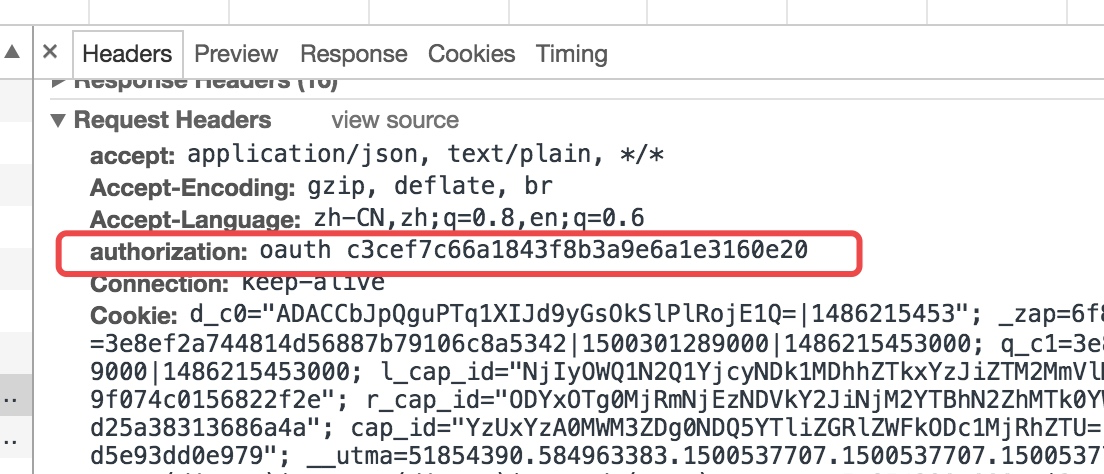
所以我们需要把这个参数同样添加到请求头中:
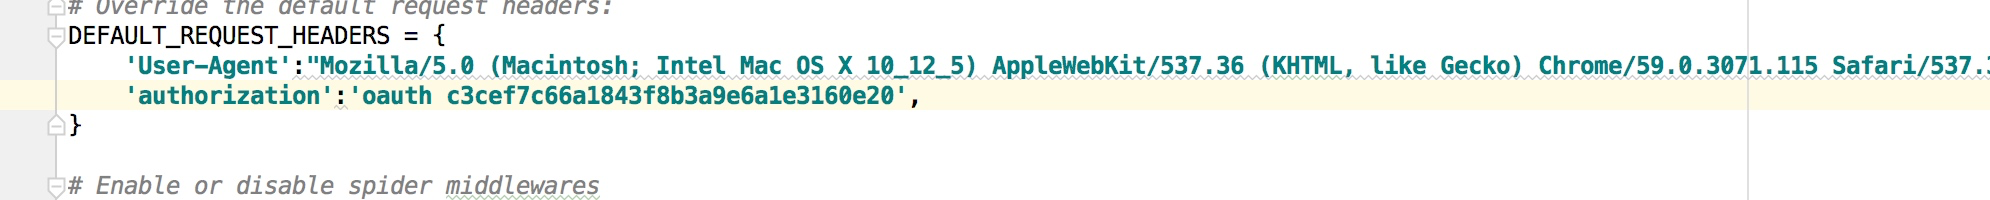
然后重新启动爬虫,这个时候我们已经可以获取到正常的内容
到此基本的分析可以说是都分析好了,剩下的就是具体代码的实现,在下一篇文张中写具体的实现代码内容!
Python爬虫从入门到放弃(十八)之 Scrapy爬取所有知乎用户信息(上)的更多相关文章
- Python之爬虫(二十) Scrapy爬取所有知乎用户信息(上)
爬取的思路 首先我们应该找到一个账号,这个账号被关注的人和关注的人都相对比较多的,就是下图中金字塔顶端的人,然后通过爬取这个账号的信息后,再爬取他关注的人和被关注的人的账号信息,然后爬取被关注人的账号 ...
- Python爬虫从入门到放弃(十九)之 Scrapy爬取所有知乎用户信息(下)
在上一篇文章中主要写了关于爬虫过程的分析,下面是代码的实现,完整代码在:https://github.com/pythonsite/spider items中的代码主要是我们要爬取的字段的定义 cla ...
- Python之爬虫(二十一) Scrapy爬取所有知乎用户信息(下)
在上一篇文章中主要写了关于爬虫过程的分析,下面是代码的实现,完整代码在:https://github.com/pythonsite/spider items中的代码主要是我们要爬取的字段的定义 cla ...
- python爬虫从入门到放弃(八)之 Selenium库的使用
一.什么是Selenium selenium 是一套完整的web应用程序测试系统,包含了测试的录制(selenium IDE),编写及运行(Selenium Remote Control)和测试的并行 ...
- Python爬虫从入门到放弃(二十)之 Scrapy分布式原理
关于Scrapy工作流程回顾 Scrapy单机架构 上图的架构其实就是一种单机架构,只在本机维护一个爬取队列,Scheduler进行调度,而要实现多态服务器共同爬取数据关键就是共享爬取队列. 分布式架 ...
- Python爬虫从入门到放弃(二十二)之 爬虫与反爬虫大战
爬虫与发爬虫的厮杀,一方为了拿到数据,一方为了防止爬虫拿到数据,谁是最后的赢家? 重新理解爬虫中的一些概念 爬虫:自动获取网站数据的程序反爬虫:使用技术手段防止爬虫程序爬取数据误伤:反爬虫技术将普通用 ...
- python爬虫从入门到放弃(三)之 Urllib库的基本使用
官方文档地址:https://docs.python.org/3/library/urllib.html 什么是Urllib Urllib是python内置的HTTP请求库包括以下模块urllib.r ...
- Python爬虫从入门到放弃(十一)之 Scrapy框架整体的一个了解
这里是通过爬取伯乐在线的全部文章为例子,让自己先对scrapy进行一个整理的理解 该例子中的详细代码会放到我的github地址:https://github.com/pythonsite/spider ...
- Python之爬虫从入门到放弃(十三) Scrapy框架整体的了解
这里是通过爬取伯乐在线的全部文章为例子,让自己先对scrapy进行一个整理的理解 该例子中的详细代码会放到我的github地址:https://github.com/pythonsite/spider ...
随机推荐
- 使用 after 伪类清除浮动
以前清除浮动的时候总是在想要清除浮动的元素后面添加 <div style="clear:both;"></div> 或者写在br标签里面来解决,但这样会增加 ...
- JavaSE教程-01初识Java-思维导图
图片看不清楚时: 1)可以将图片另存为图片,保存在本地来查看 2)右击在新标签中打开放大查看. 分解: 1.计算机基本概念的普及 硬件 cpu.内存.硬盘等 软件 系统级软件 Windows.Linu ...
- div,css命名规范!
命名规则说明: 1).所有的命名最好都小写 2).属性的值一定要用双引号("")括起来,且一定要有值如class="pcss5",id="pcss5& ...
- [github项目]基于百度地图二次开发实现的车辆监管(包含车辆定位、车辆图片和方向控制,电子围栏,图形绘制等功能)前端实现(不包含后端实现)
前言:基于百度地图javascript版本开发,百度地图中所用的key已承诺仅用于测试,不用于商业用途 注:本文所有代码可以到github上进行下载,github地址:http://map.eguid ...
- C#简单构架之EF进行读写分离+多数据库(Mysql/SqlService)
最近因为项目需要,研究了下EF的读写分离,所以做了一个demo进行测试,下面是项目的结构 表现层view 主要提供Web.WebApi等表现层的解决方案 公共层public 主要提供项目公共类库,数据 ...
- ASP.NET MVC5(三):表单和HTML辅助方法
表单的使用 Action和Method特性 Action特性用以告知浏览器信息发往何处,因此,Action特性后面需要包含一个Url地址.这里的Url地址可以是相对的,也可以是绝对的.如下Form标签 ...
- 深入浅出HTTP协议
超文本传输协议(HTTP,HyperText Transfer Protocol)是互联网上应用最为广泛的一种网络协议.所有的WWW文件都必须遵守这个标准.设计HTTP最初的目的是为了提供一种发布和接 ...
- 教你轻轻松松入门PHP
入门PHP不用愁,跟我来学一学. 1.我们想学习PHP,首先就要了解PHP,那PHP是什么呢? PHP("PHP: Hypertext Preprocessor",超文本预处理器的 ...
- Linux下Shadow socks的安装和配置
实在受不了在Windows下编程,所以自己就安装了一个Ubutun,公司用的FQ软件shadowsocks在Windows上用起来很简单很爽,但是在Ubutun上的安装和配置就没那么简单了,写下这篇文 ...
- 音乐API之QQ音乐
欢迎大家来到我的博客,这是我在博客园写的第一篇文章,但不会是最后一篇,希望大家多多关注我,支持我哦!正文开始,今天我们要讲的是QQ音乐的API,都是来源于官方的地址,以前我也想写一个,但百度谷歌之后都 ...