
4.1:简单python爬虫
简单python爬虫
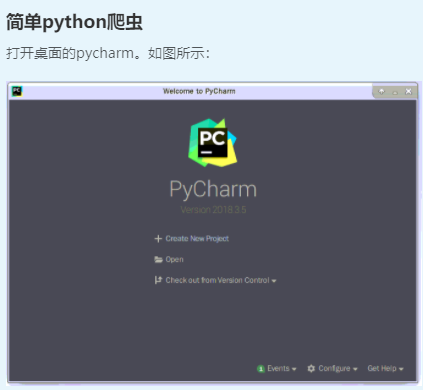
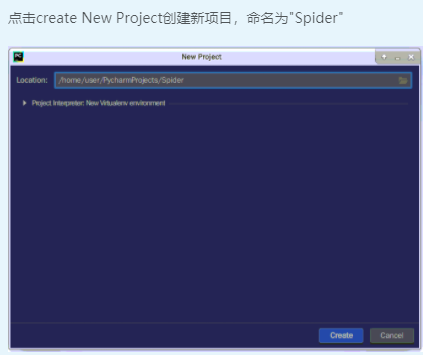
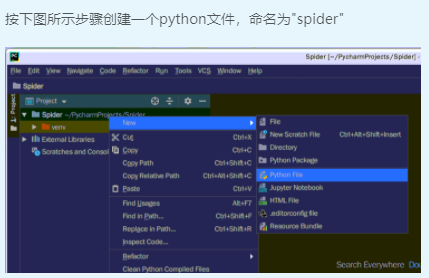
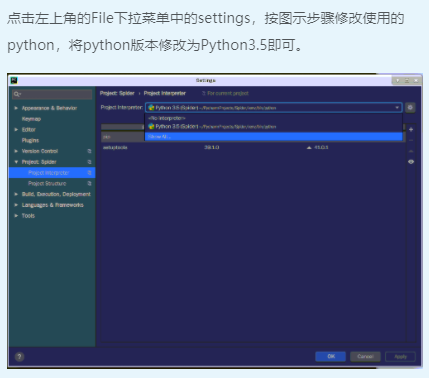
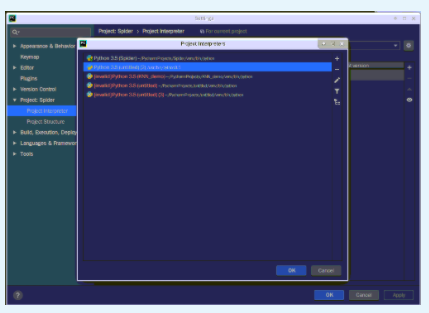
在创建的python文件中输入下列代码:
# coding:utf-8

import requests

from bs4 import BeautifulSoup

def spider(url,headers):

    with open('renming.txt', 'w', encoding='utf-8') as fp:

        r = requests.get(url, headers=headers)

        r.encoding = 'gb2312'

        # test=re.findall('<li>< a href= >(.*?)</ a></li>',r.text)

        # print(test)

        soup = BeautifulSoup(r.text, "html.parser")

        for news_list in soup.find_all(class_="list14"):

            content = news_list.text.strip()

            fp.write(content)

    fp.close()

if __name__=="__main__":

    headers = {'user-agent': 'Mozilla/5.0 (Windows NT 10.0; WOW64) '

                             'AppleWebKit/537.36 (KHTML, like Gecko)'

                             ' Chrome/55.0.2883.87 Safari/537.36'}

    url = 'http://www.people.com.cn/'

    spider(url, headers)
如果代码中存在报错,请在PyCharm最下边找到Terminal,点击Terminal后Pycharm底部控制台处会出现其自带的命令行窗口,输入下面两条命令即可解决报错:pip install requestspip install bs4解决完报错之后,在代码文件的任意处右击,点击Run,之后就会发现在代码文件目录中出现了renmin.txt,里面是爬取的人民网的数据。

4.1:简单python爬虫的更多相关文章
- 一个简单python爬虫的实现——爬取电影信息
最近在学习网络爬虫,完成了一个比较简单的python网络爬虫.首先为什么要用爬虫爬取信息呢,当然是因为要比人去收集更高效. 网络爬虫,可以理解为自动帮你在网络上收集数据的机器人. 网络爬虫简单可以大致 ...
- 简单python爬虫实例
先放上url,https://music.douban.com/chart 这是豆瓣的一个音乐排行榜,这里爬取了左边部分的歌曲排行榜部分,爬虫很简单,就用到了beautifulsoup和request ...
- 简单python爬虫编写,Python采集妹子图!
疫情期间在家闲来无事,每天打游戏荒废了一段时间.我觉得自己不能在这么颓废下去,就立马起身写了一点python代码(本人只是python新手). 很多人学习python,不知道从何学起.很多人学习pyt ...
- 简单python爬虫案例(爬取慕课网全部实战课程信息)
技术选型 下载器是Requests 解析使用的是正则表达式 效果图: 准备好各个包 # -*- coding: utf-8 -*- import requests #第三方下载器 import re ...
- Selenium + PhantomJS + python 简单实现爬虫的功能
Selenium 一.简介 selenium是一个用于Web应用自动化程序测试的工具,测试直接运行在浏览器中,就像真正的用户在操作一样 selenium2支持通过驱动真实浏览器(FirfoxDrive ...
- python (1)一个简单的爬虫: python 在windows下 创建文件夹并写入文件
1.一个简单的爬虫:爬取豆瓣的热门电影的信息 写在前面:如何创建本来存在的文件夹并写入 t_path = "d:/py/inn" #本来不存在inn,先定义路径,然后如果不存在,则 ...
- 一个简单的多线程Python爬虫(一)
一个简单的多线程Python爬虫 最近想要抓取拉勾网的数据,最开始是使用Scrapy的,但是遇到了下面两个问题: 前端页面是用JS模板引擎生成的 接口主要是用POST提交参数的 目前不会处理使用JS模 ...
- 纯手工打造简单分布式爬虫(Python)
前言 这次分享的文章是我<Python爬虫开发与项目实战>基础篇 第七章的内容,关于如何手工打造简单分布式爬虫 (如果大家对这本书感兴趣的话,可以看一下 试读样章),下面是文章的具体内容. ...
- python爬虫——写出最简单的网页爬虫
在我们日常上网浏览网页的时候,经常会看到一些好看的图片,我们就希望把这些图片保存下载,或者用户用来做桌面壁纸,或者用来做设计的素材.我们可以通过python 来实现这样一个简单的爬虫功能,把我们想要的 ...
- 一个简单的python爬虫程序
python|网络爬虫 概述 这是一个简单的python爬虫程序,仅用作技术学习与交流,主要是通过一个简单的实际案例来对网络爬虫有个基础的认识. 什么是网络爬虫 简单的讲,网络爬虫就是模拟人访问web ...
随机推荐
- ES 7.13版本设置索引模板和索引生命周期管理
第一步:索引管理中查看都有哪些索引文件,然后添加索引模式(后面的日期用*表示) 第二步:索引生命周期管理 自带的有一个log,就使用这个,不用再新建了,根据需求修改里面的配置就行了 第三步:添加索引模 ...
- 1.通俗易懂理解Kubernetes核心组件及原理
文章转载自:https://mp.weixin.qq.com/s?__biz=MzI1MDgwNzQ1MQ==&mid=2247483736&idx=1&sn=0cbc3d6a ...
- ELK 性能优化实践
文章转载自:https://mp.weixin.qq.com/s?__biz=MzI5MTU1MzM3MQ==&mid=2247489814&idx=1&sn=6916f8b7 ...
- 使用Kuboard界面在k8s上部署SpringCloud项目
先安装Ingress Controller 安装Ingress Controller后,其他服务设置Ingress后就可以通过设置的域名进行访问了,就不用通过代理的方式或者ip:port的方式进行访问 ...
- Ubuntu20.04和Docker环境下安装Redash中文版
创建Ubunt20.04虚拟机,请参考:https://www.linuxidc.com/Linux/2020-03/162547.htm 一.安装基础环境: # 1.更换APT国内源 sudo se ...
- 史上最全的selenium三大等待介绍
一.强制等待 1.设置完等待后不管有没有找到元素,都会执行等待,等待结束后才会执行下一步 2.实例 driver = webdriver.Chrome() driver.get("https ...
- Kafka与Flume之集成比较
Kafka与Flume之集成比较 一.Kafka与Flume比较 在企业中必须要清楚流式数据采集框架flume和kafka的定位是什么:flume:cloudera公司研发: 适合多个生产者: 适合下 ...
- (Java初学篇)IDEA项目新建流程和软件配置优化以及怎么彻底删除项目
相信很多小伙伴们在初学 Java 时都会出现这样的情况,就是在网上一顿搜索加捣鼓终于把 JDK 和IDEA 这两款软件安装配置好,但是发现面对这个陌生的软件此时却无从下手,那么接下来我就给大家简单地介 ...
- Scanner的用法 从键盘输入
先导入包 import java.util.Scanner; 后输入 Scanner Sc=new Scanner(System.in); //(Sc可以自定义,无实质意义) int i; i=Sc. ...
- 鹅长微服务发现与治理巨作PolarisMesh实践-上
@ 目录 概述 定义 核心功能 组件和生态 特色亮点 解决哪些问题 官方性能数据 架构原理 资源模型 服务治理 基本原理 服务注册 服务发现 安装 部署架构 集群安装 SpringCloud应用接入 ...