
用 BeautifulSoup爬取58商品信息
最近对Python爬虫比较迷恋,看了些爬虫相关的教程
于是乎跟着一起爬取了58上面的一些商品信息,并存入到xlsx文件中,并通过xlsxwirter的方法给表格设置了一些格式。好了,直接贴代码吧~
#coding:utf-8

from bs4 import BeautifulSoup

import requests

import sys

import xlsxwriter

import re

reload(sys)

sys.setdefaultencoding('utf8')

def get_links_from(urls,who_sell=0,page=1):

    list_view = 'http://bj.58.com/haidian/pbdn/{}/pn{}/'.format(str(who_sell), str(page))

    web_data = requests.get(list_view)

    soup = BeautifulSoup(web_data.text, "lxml")

    for url in soup.select('td.t a.t'):

        url = url.get('href').split('?')[0]

        if url.find('zhuanzhuan.58.com') != -1:

            urls.append(url)

    is_next = soup.select('.next')

    if is_next:                                             #如果存在下一页,继续获取url并保存到urls

        get_links_from(urls,who_sell,page+1)

    return  urls

def get_views_from(url):

    id = url.split('/')[-1].strip('z.shtml')

    api = 'http://jst1.58.com/counter?infoid={}'.format(id)

    js = requests.get(api)

    view = js.text.split('=')[-1]

    return view

def get_item_info(who_sell):

    datas = []

    urls = []

    urls = get_links_from(urls,who_sell,1)

    workbook = xlsxwriter.Workbook(u'F:/Python27/magua/download/二手平板.xlsx')

    worksheet = workbook.add_worksheet('haidian')

    format = workbook.add_format({'bold':True, 'font_color': 'B452CD', 'font_size': 16, 'align':'center', 'bg_color':'FFA54F'})

    worksheet.set_row(0, 20)            #设置第1行的单元格高度

    worksheet.set_column('A:A', 100)    #设置第A列的单元格长度

    worksheet.set_column('C:C', 15)     #设置第C列的单元格长度

    worksheet.set_column('D:D', 15)     #设置第D列的单元格长度

    worksheet.set_column('E:E', 15)     #设置第E列的单元格长度

    worksheet.write(0, 0, '标题', format)

    worksheet.write(0, 1, '价格', format)

    worksheet.write(0, 2, '区域', format)

    worksheet.write(0, 3, '个人/商家', format)

    worksheet.write(0, 4, '浏览量', format)

    # workbook.close()

    # return

    row_num = 1

    for url in urls:

        web_data = requests.get(url)

        soup = BeautifulSoup(web_data.text, "lxml")

        data = {

            'title':soup.title.text.strip(),    #strip 去掉字符串中的换行、制表符

            'price':soup.select('.price_now i')[0].text,    # #代表id

            'area':soup.select('.palce_li i')[0].text,

            'cate':u'个人' if who_sell ==0 else u'商家',

            'view':soup.select('.look_time')[0].text.split('次')[0],

            # 'views':get_views_from(url),

        }

        # datas.append(data)

        if row_num%2:

            format_ = workbook.add_format({'bg_color': 'FFEC8B', 'font_size': 12})

        else:

            format_ = workbook.add_format({'bg_color': 'FFDAB9', 'font_size': 12})

        #write the data into .xlsx file

        worksheet.write(row_num, 0, data['title'], format_)

        worksheet.write(row_num, 1, data['price'], format_)

        worksheet.write(row_num, 2, data['area'], format_)

        worksheet.write(row_num, 3, data['cate'], format_)

        worksheet.write(row_num, 4, data['view'], format_)

        row_num = row_num + 1

    workbook.close()

    '''

    for item in datas:

        print repr(item).decode("unicode-escape")

        # print item

    print "total: %d" % len(datas)

    '''

get_item_info(0)    #参数 0为个人,1为商家
在这过程中有点不明白的地方就是xlsxwriter.Workbook 方法在创建xlsx文件的时候,必须要绝对路径才能成功,看官方文档也没找到问题的原因
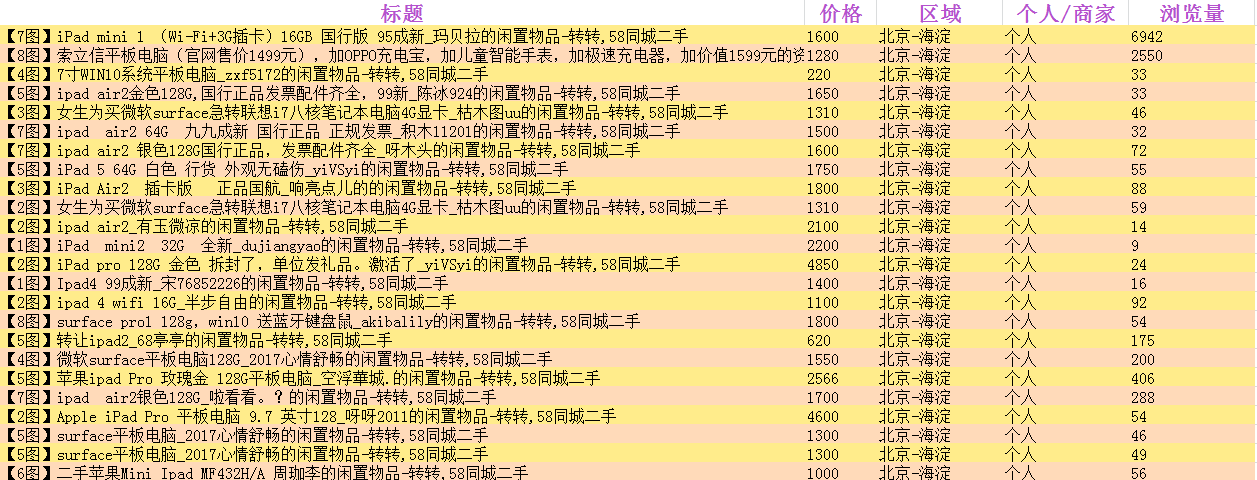
最后抓取信息所生成的表格文件截图
用 BeautifulSoup爬取58商品信息的更多相关文章
- selenium+phantomjs爬取京东商品信息
selenium+phantomjs爬取京东商品信息 今天自己实战写了个爬取京东商品信息,和上一篇的思路一样,附上链接:https://www.cnblogs.com/cany/p/10897618. ...
- selenium模块使用详解、打码平台使用、xpath使用、使用selenium爬取京东商品信息、scrapy框架介绍与安装
今日内容概要 selenium的使用 打码平台使用 xpath使用 爬取京东商品信息 scrapy 介绍和安装 内容详细 1.selenium模块的使用 # 之前咱们学requests,可以发送htt ...
- Python爬虫-爬取京东商品信息-按给定关键词
目的:按给定关键词爬取京东商品信息,并保存至mongodb. 字段:title.url.store.store_url.item_id.price.comments_count.comments 工具 ...
- 爬虫—Selenium爬取JD商品信息
一,抓取分析 本次目标是爬取京东商品信息,包括商品的图片,名称,价格,评价人数,店铺名称.抓取入口就是京东的搜索页面,这个链接可以通过直接构造参数访问https://search.jd.com/Sea ...
- Python爬虫学习之使用beautifulsoup爬取招聘网站信息
菜鸟一只,也是在尝试并学习和摸索爬虫相关知识. 1.首先分析要爬取页面结构.可以看到一列搜索的结果,现在需要得到每一个链接,然后才能爬取对应页面. 关键代码思路如下: html = getHtml(& ...
- 八个commit让你学会爬取京东商品信息
我发现现在不用标题党的套路还真不好吸引人,最近在做相关的事情,从而稍微总结出了一些文字.我一贯的想法吧,虽然才疏学浅,但是还是希望能帮助需要的人.博客园实在不适合这种章回体的文章.这里,我贴出正文的前 ...
- 利用selenium爬取京东商品信息存放到mongodb
利用selenium爬取京东商城的商品信息思路: 1.首先进入京东的搜索页面,分析搜索页面信息可以得到路由结构 2.根据页面信息可以看到京东在搜索页面使用了懒加载,所以为了解决这个问题,使用递归.等待 ...
- scrapy 爬取天猫商品信息
spider # -*- coding: utf-8 -*- from urllib.parse import urlencode import requests import scrapy impo ...
- python爬虫——用selenium爬取京东商品信息
1.先附上效果图(我偷懒只爬了4页) 2.京东的网址https://www.jd.com/ 3.我这里是不加载图片,加快爬取速度,也可以用Headless无弹窗模式 options = webdri ...
随机推荐
- C语言学习第五章
今天要进行一个重要元素数组的学习了.这一章要掌握什么是数组,数组怎么样命名,数组怎么样使用,以及一些常见的错误和需要注意的事项. 一. 数组的基本概念 数组是可以在内存中连续存储多个元素的结 ...
- 关联分析:FP-Growth算法
关联分析又称关联挖掘,就是在交易数据.关系数据或其他信息载体中,查找存在于项目集合或对象集合之间的频繁模式.关联.相关性或因果结构.关联分析的一个典型例子是购物篮分析.通过发现顾客放入购物篮中不同商品 ...
- Java中this关键字的作用
转载: 原文地址:http://www.cnblogs.com/lzq198754/p/5767024.html 一.this关键字主要有三个应用: (1)this调用本类中的属性,也就是类中的成员变 ...
- C# Winform中的窗体传值
关于C#winform窗体之间的传值有以下几种做法 1 通过构造函数传值 2 属性传值 以上两种方法不早详细介绍. 3 通过事件传值,委托传值 首先看一下通过委托传值吧. 1,创建两个窗体,分别是Fo ...
- 详解MySQL存储过程的“异常处理”
阅读目录:存储过程的异常处理 定义异常处理 单一异常处理程序 continue exit 多个异常处理程序 关于错误编号和SQLSTATE码 使用3个处理程序 忽略某一异常的处理 异常处理的命名 异常 ...
- 你真的用好了Python的random模块吗?
random模块 用于生成伪随机数 源码位置: Lib/random.py(看看就好,千万别随便修改) 真正意义上的随机数(或者随机事件)在某次产生过程中是按照实验过程中表现的分布概率随机产生的,其结 ...
- 【NLP】Python实例:申报项目查重系统设计与实现
Python实例:申报项目查重系统设计与实现 作者:白宁超 2017年5月18日17:51:37 摘要:关于查重系统很多人并不陌生,无论本科还是硕博毕业都不可避免涉及论文查重问题,这也对学术不正之风起 ...
- C#设置richtextbox某一段文本颜色
假设 RichTextBox1 文本是"你好,我爱你中国",想要把中国变为红色,则 可以先找到中的位置是 7 :国的位置是8 设置 RichTextBox1.SelectionSt ...
- GTD:让大脑用来思考,而不是用来记事!
前段时间听刘润大师分享了一套GTD时间管理方法理论,感觉非常受用!现拿来跟大家分享下,这套方法是刘润老师践行20多年总结提炼的精华,经亲自实践确实行之有效. 俗话说:工欲善其事,必先利其器!人生也是如 ...
- java面试集锦
HashMap和HashTable的区别 他们都是Map接口的实现类,实现了将唯一键值映射到特定的值上. HashMap没有分类或者排序,它允许一个null和多个null值. HashTable类似于 ...