
吴裕雄 python 数据处理(2)
import pandas as pd
data = pd.read_csv("F:\\python3_pachongAndDatareduce\\data\\pandas data\\hz_weather.csv")
print(data.head())
a = data.stack()
print(a)
b = a.unstack()
print(b)
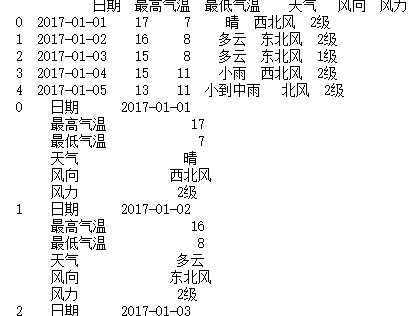
import pandas as pd
data = pd.read_csv("F:\\python3_pachongAndDatareduce\\data\\pandas data\\hz_weather.csv")
print(data.head())
df = data.set_index("日期")
print(df.head())
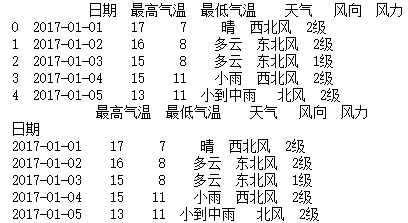
import pandas as pd
data = pd.read_csv("F:\\python3_pachongAndDatareduce\\data\\pandas data\\hz_weather.csv")
a = pd.pivot_table(data,values=["最高气温"],index=["天气"],columns=["风向"])
print(a)
print(a.info())

import pandas as pd
data = pd.read_csv("F:\\python3_pachongAndDatareduce\\data\\pandas data\\qunar_free_trip.csv")
print(data.head())

import pandas as pd
data = pd.read_csv("F:\\python3_pachongAndDatareduce\\data\\pandas data\\qunar_free_trip.csv")
a = data["价格"].groupby([data["出发地"],data["目的地"]]).mean()
print(a)
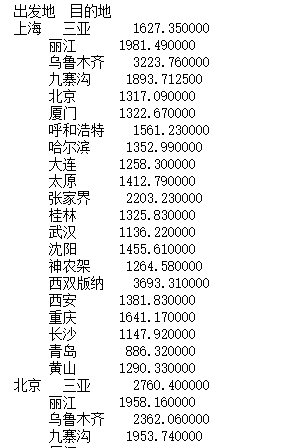
import pandas as pd
data = pd.read_csv("F:\\python3_pachongAndDatareduce\\data\\pandas data\\qunar_route_cnt.csv")
print(data.head())
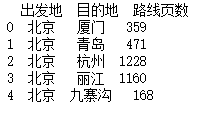
import pandas as pd
data = pd.read_csv("F:\\python3_pachongAndDatareduce\\data\\pandas data\\qunar_free_trip.csv")
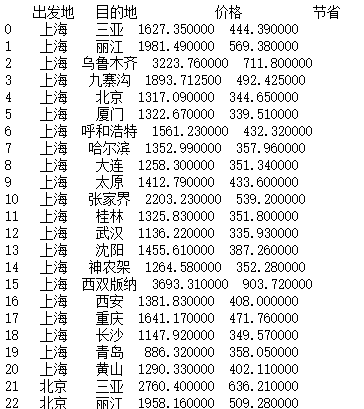
a = data.groupby([data["出发地"],data["目的地"]],as_index=False).mean()
print(a)
import pandas as pd
data = pd.read_csv("F:\\python3_pachongAndDatareduce\\data\\pandas data\\qunar_route_cnt.csv")
print(data.head())
data_1 = pd.read_csv("F:\\python3_pachongAndDatareduce\\data\\pandas data\\qunar_free_trip.csv")
print(data_1.head())
a = data_1.groupby([data_1["出发地"],data_1["目的地"]],as_index=False).mean()
print(a.head())
b = pd.merge(a,data)
print(b.head())

import pandas as pd
data_1 = pd.read_csv("F:\\python3_pachongAndDatareduce\\data\\pandas data\\qunar_free_trip.csv")
a = pd.pivot_table(data_1,values=["价格"],index=["出发地"],columns=["目的地"])
print(a.head())

import pandas as pd
data_1 = pd.read_csv("F:\\python3_pachongAndDatareduce\\data\\pandas data\\qunar_free_trip.csv")
a = pd.pivot_table(data_1[data_1["出发地"]=="杭州"],values=["价格"],index=["出发地","目的地"],columns=["去程方式"])
print(a)

import pandas as pd
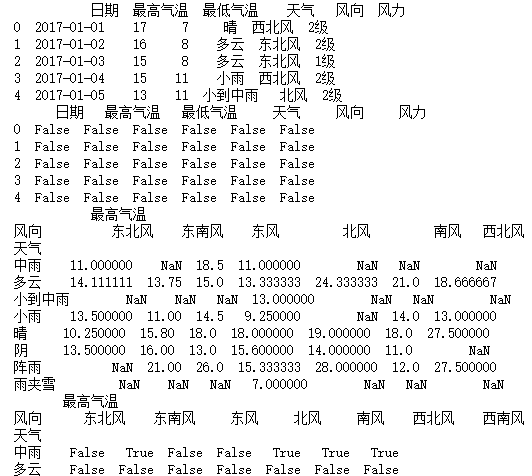
data_1 = pd.read_csv("F:\\python3_pachongAndDatareduce\\data\\pandas data\\hz_weather.csv")
print(data_1.head())
print(data_1.isnull().head())
a = pd.pivot_table(data_1,values=["最高气温"],index=["天气"],columns=["风向"])
print(a)
print(a.isnull())
import pandas as pd
data_1 = pd.read_csv("F:\\python3_pachongAndDatareduce\\data\\pandas data\\hz_weather.csv")
a = pd.pivot_table(data_1,values=["最高气温"],index=["天气"],columns=["风向"])
print(a)
b = a.dropna(axis=0)
print(b)

import pandas as pd
data_1 = pd.read_csv("F:\\python3_pachongAndDatareduce\\data\\pandas data\\hz_weather.csv")
a = pd.pivot_table(data_1,values=["最高气温"],index=["天气"],columns=["风向"])
print(a)
b = a.dropna(axis=1)
print(b)

import pandas as pd
data_1 = pd.read_csv("F:\\python3_pachongAndDatareduce\\data\\pandas data\\hz_weather.csv")
a = pd.pivot_table(data_1,values=["最高气温"],index=["天气"],columns=["风向"])
print(a)
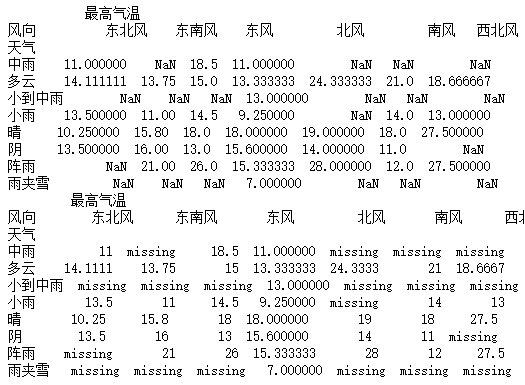
b = a.fillna("missing")
print(b)
import pandas as pd
data_1 = pd.read_csv("F:\\python3_pachongAndDatareduce\\data\\pandas data\\hz_weather.csv")
a = pd.pivot_table(data_1,values=["最高气温"],index=["天气"],columns=["风向"])
print(a)
b = a.fillna(method="pad")
print(b)

import pandas as pd
data_1 = pd.read_csv("F:\\python3_pachongAndDatareduce\\data\\pandas data\\hz_weather.csv")
a = pd.pivot_table(data_1,values=["最高气温"],index=["天气"],columns=["风向"])
print(a)
b = a.fillna(method="bfill",limit=1)
print(b)

import pandas as pd
data_1 = pd.read_csv("F:\\python3_pachongAndDatareduce\\data\\pandas data\\hz_weather.csv")
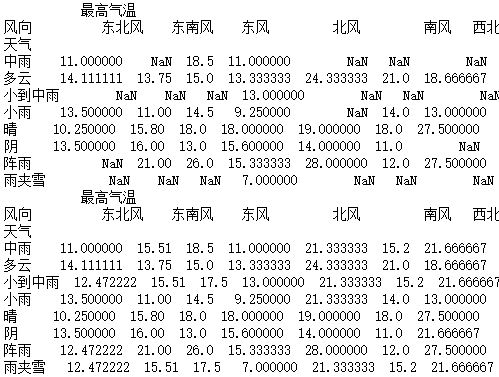
a = pd.pivot_table(data_1,values=["最高气温"],index=["天气"],columns=["风向"])
print(a)
b = a.fillna(a.mean())
print(b)
%matplotlib inline
import numpy as np
import pandas as pd
import matplotlib as mpl
import matplotlib.pyplot as plt
df = pd.read_csv("F:\\python3_pachongAndDatareduce\\data\\pandas data\\hz_weather.csv")
print(np.shape(df))
print(df.head())
fig,ax = plt.subplots(1,1,figsize=(8,5))
ax.hist(df["最低气温"],bins=20)
plt.show()
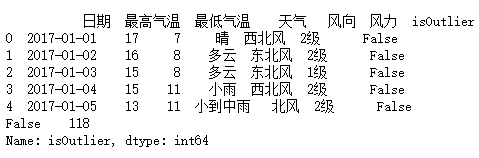
d = df["最低气温"]
zscore = (d-d.mean())/d.std()
df["isOutlier"]=zscore.abs()>3
print(df.head())
a = df["isOutlier"].value_counts()
print(a)

%matplotlib inline
import numpy as np
import pandas as pd
import matplotlib as mpl
import matplotlib.pyplot as plt
df = pd.read_csv("F:\\python3_pachongAndDatareduce\\data\\pandas data\\sale_data.csv")
print(np.shape(df))
print(df.head())
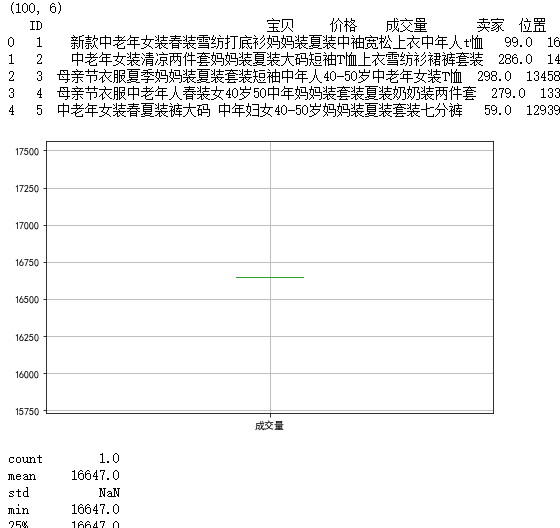
a = df[df["卖家"]=="夏奈凤凰旗舰店"]
fig,ax = plt.subplots(1,1,figsize=(8,5))
a.boxplot(column="成交量",ax=ax)
plt.show()
b = a["成交量"]
print(b.describe())
a["isOutlier"]=d>d.quantile(0.75)
c = a[a["isOutlier"]==True]
print(c)
import numpy as np
import pandas as pd
df = pd.read_csv("F:\\python3_pachongAndDatareduce\\data\\pandas data\\hz_weather.csv")
print(np.shape(df))
print(df.head())
a = df.duplicated()
print(np.shape(a))
print(a[:5])

import numpy as np
import pandas as pd
df = pd.read_csv("F:\\python3_pachongAndDatareduce\\data\\pandas data\\hz_weather.csv")
print(np.shape(df))
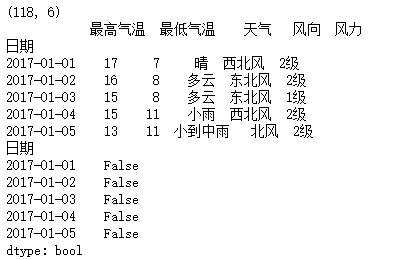
a = df.set_index("日期")
print(a.head())
b = a.duplicated()
print(b[:5])
import numpy as np
import pandas as pd
df = pd.read_csv("F:\\python3_pachongAndDatareduce\\data\\pandas data\\hz_weather.csv")
print(np.shape(df))
a = df.set_index("日期")
print(a.head())
b = a.duplicated("最高气温")
print(b[:5])

import numpy as np
import pandas as pd
df = pd.read_csv("F:\\python3_pachongAndDatareduce\\data\\pandas data\\hz_weather.csv")
print(type(df))
print(np.shape(df))
a = df.set_index("日期")
print(a.head())
b = a.drop_duplicates("最高气温")
print(np.shape(b))
print(b.head())

import numpy as np
import pandas as pd
df = pd.read_csv("F:\\python3_pachongAndDatareduce\\data\\pandas data\\qunar_free_trip.csv")
print(df.head())
print(df.info())

import numpy as np
import pandas as pd
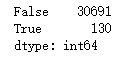
df = pd.read_csv("F:\\python3_pachongAndDatareduce\\data\\pandas data\\qunar_free_trip.csv")
a = df.duplicated().value_counts()
print(a)
import numpy as np
import pandas as pd
df = pd.read_csv("F:\\python3_pachongAndDatareduce\\data\\pandas data\\qunar_free_trip.csv")
a = df.drop_duplicates()
b = a.duplicated().value_counts()
print(b)

import numpy as np
import pandas as pd
df = pd.read_csv("F:\\python3_pachongAndDatareduce\\data\\pandas data\\qunar_free_trip.csv")
a = df.drop_duplicates()
print(a.describe())

%matplotlib inline
import numpy as np
import pandas as pd
import matplotlib as mpl
import matplotlib.pyplot as plt
df = pd.read_csv("F:\\python3_pachongAndDatareduce\\data\\pandas data\\qunar_free_trip.csv")
print(np.shape(df))
fig,axes = plt.subplots(1,2,figsize=(12,5))
axes[0].hist(df["价格"],bins=20)
df.boxplot(column="价格",ax=axes[1])
plt.show()

%matplotlib inline
import numpy as np
import pandas as pd
import matplotlib as mpl
import matplotlib.pyplot as plt
df = pd.read_csv("F:\\python3_pachongAndDatareduce\\data\\pandas data\\qunar_free_trip.csv")
d = df["价格"]
zscore = (d-d.mean())/d.std()
print(zscore[0:3])
df["isOutlier"]=zscore.abs()>3.5
print(df["isOutlier"].value_counts())
a = df[df["isOutlier"]==True]
print(a.head())

吴裕雄 python 数据处理(2)的更多相关文章
- 吴裕雄 python 数据处理(3)
import time a = time.time()print(a)b = time.localtime()print(b)c = time.strftime("%Y-%m-%d %X&q ...
- 吴裕雄 python 数据处理(1)
import time print(time.time())print(time.localtime())print(time.strftime('%Y-%m-%d %X',time.localtim ...
- 吴裕雄 python 神经网络——TensorFlow 输入数据处理框架
import tensorflow as tf files = tf.train.match_filenames_once("E:\\MNIST_data\\output.tfrecords ...
- 吴裕雄 python神经网络 花朵图片识别(10)
import osimport numpy as npimport matplotlib.pyplot as pltfrom PIL import Image, ImageChopsfrom skim ...
- 吴裕雄 python神经网络 花朵图片识别(9)
import osimport numpy as npimport matplotlib.pyplot as pltfrom PIL import Image, ImageChopsfrom skim ...
- 吴裕雄 python 神经网络——TensorFlow pb文件保存方法
import tensorflow as tf from tensorflow.python.framework import graph_util v1 = tf.Variable(tf.const ...
- 吴裕雄 python 神经网络——TensorFlow 花瓣分类与迁移学习(4)
# -*- coding: utf-8 -*- import glob import os.path import numpy as np import tensorflow as tf from t ...
- 吴裕雄 python 神经网络——TensorFlow 花瓣分类与迁移学习(3)
import glob import os.path import numpy as np import tensorflow as tf from tensorflow.python.platfor ...
- 吴裕雄 python 神经网络——TensorFlow 花瓣分类与迁移学习(2)
import glob import os.path import numpy as np import tensorflow as tf from tensorflow.python.platfor ...
随机推荐
- hadoop伪分布式环境搭建之linux系统安装教程
本篇文章是接上一篇<超详细hadoop虚拟机安装教程(附图文步骤)>,上一篇有人问怎么没写hadoop安装.在文章开头就已经说明了,hadoop安装会在后面写到,因为整个系列的文章涉及到每 ...
- 阿里巴巴Java开发手册- 控制语句
1. [强制]在一个 switch 块内,每个 case 要么通过 break / return 等来终止,要么注释说明程序将继续执行到哪一个 case 为止 : 在一个 switch 块内,都必须包 ...
- ML(2): 术语及算法分类汇总
机器学习术语 归纳总结机器学习相关的基本术语,以一批西瓜的数据为例,例如:(色泽=青绿:根蒂=蜷缩:敲声=浊响),(色泽=乌黑:根蒂=稍蜷:敲声=沉闷),(色泽=浅白:根蒂=硬挺:敲声=清脆)... ...
- WPF Demo9外部资源文件
<Window x:Class="Demos.MainWindow" xmlns="http://schemas.microsoft.com/winfx/2006/ ...
- 关于String.valueOf()和.toString的问题
以下是String.valueOf()的源代码 public static String valueOf(Object obj) { return (obj == null) ? " ...
- [转]C# 系统应用之鼠标模拟技术及自动操作鼠标
原文网址: C# 系统应用之鼠标模拟技术及自动操作鼠标 游戏程序的操作不外乎两种——键盘输入控制和鼠标输入控制,几乎所有游戏中都使用鼠标来改变角色的位置和方向,本文主要是讲述如何使用C# ...
- dubbo框架及dubbo环境搭建
https://blog.csdn.net/liuhaiabc/article/details/52781351 dubbo框架及dubbo环境搭建
- javascript继承之组合继承(三)
function Father(name) { this.name = name; } Father.prototype.say = function () { return this.name; } ...
- 6.13-C3p0连接池配置,DBUtils使用
DBCP连接池 一.C3p0连接池配置 开源的JDBC连接池 使用连接池的好处: 减轻数据库服务器压力 数据源: ComboPooledDataSource ComboPooledDataSource ...
- tensorflow入门资料
google出的说明文档 tensorflow_manual_cn.pdf google出的视频 https://www.zhihu.com/question/41667903/answer/1306 ...