
[转载]机器学习优化方法总结:SGD,Momentum,AdaGrad,RMSProp,Adam
[转载]机器学习优化方法总结:SGD,Momentum,AdaGrad,RMSProp,Adam
https://blog.csdn.net/u010089444/article/details/76725843
这篇博客格式不好直接粘贴,就不附原文了。
有几个点可以注意下,原文没有写的很清楚:
优化方法的作用是什么?
可以说,没有优化方法,机器学习模型一般一样可以执行,所以说它并不是必须的。但是优化方法可以动态调整学习率以及影响迭代中参数调整的方向和幅度,可以加速收敛,是对原方法的一种优化。
Momentum:
Momentum方法一般用来辅助SGD,从下图也能看出来:
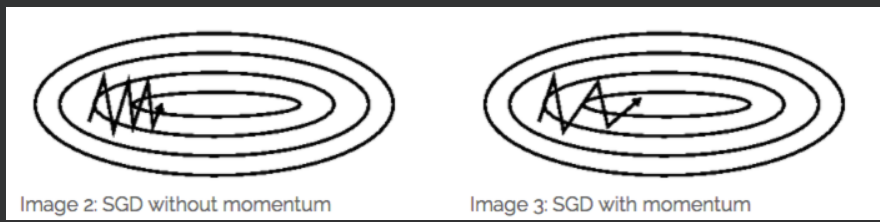
它的作用是加速SGD,并且抑制震荡。
另外,从原理上来说,它应用在BGD上也没有什么问题。
Nesterov Momentum方法是Momentum方法的一种改进,思路也是和传统的思路比较类似的:传统思路中,在一次参数更新中,更新后面的参数如果要使用前面的参数,则使用本次更新中前面参数已经更新了的值可以加速收敛。这里是反过来了:先更新vt,后更新梯度。但是vt的计算中要用到梯度,这里就使用梯度更新后的值可以使得结果更加准确、收敛更快。但是这时更新值还没有计算出来,于是使用了”预测“值,J中的梯度计算取的是迭代公式中的线性部分。
什么是”矩估计“
来源:https://baike.baidu.com/item/%E7%9F%A9%E4%BC%B0%E8%AE%A1
矩估计,即矩估计法,也称“矩法估计”,就是利用样本矩来估计总体中相应的参数。首先推导涉及感兴趣的参数的总体矩(即所考虑的随机变量的幂的期望值)的方程。然后取出一个样本并从这个样本估计总体矩。接着使用样本矩取代(未知的)总体矩,解出感兴趣的参数。从而得到那些参数的估计。
其实就是用样本估计总体
在实际应用中 ,Adam为最常用的方法,可以比较快地得到一个预估结果
[转载]机器学习优化方法总结:SGD,Momentum,AdaGrad,RMSProp,Adam的更多相关文章
- 深度学习笔记:优化方法总结(BGD,SGD,Momentum,AdaGrad,RMSProp,Adam)
深度学习笔记:优化方法总结(BGD,SGD,Momentum,AdaGrad,RMSProp,Adam) 深度学习笔记(一):logistic分类 深度学习笔记(二):简单神经网络,后向传播算法及实现 ...
- 优化方法:SGD,Momentum,AdaGrad,RMSProp,Adam
参考: https://blog.csdn.net/u010089444/article/details/76725843 1. SGD Batch Gradient Descent 在每一轮的训练过 ...
- 机器学习优化方法总结比较(SGD,Adagrad,Adadelta,Adam,Adamax,Nadam)
SGD: 此处的SGD指mini-batch gradient descent,关于batch gradient descent, stochastic gradient descent, 以及 mi ...
- 优化器,SGD+Momentum;Adagrad;RMSProp;Adam
Optimization 随机梯度下降(SGD): 当损失函数在一个方向很敏感在另一个方向不敏感时,会产生上面的问题,红色的点以“Z”字形梯度下降,而不是以最短距离下降:这种情况在高维空间更加普遍. ...
- 5、Tensorflow基础(三)神经元函数及优化方法
1.激活函数 激活函数(activation function)运行时激活神经网络中某一部分神经元,将激活信息向后传入下一层的神经网络.神经网络之所以能解决非线性问题(如语音.图像识别),本质上就是激 ...
- Deep Learning基础--参数优化方法
1. 深度学习流程简介 1)一次性设置(One time setup) -激活函数(Activation functions) - 数据预处理(Data Preprocessing) ...
- 各种优化方法总结比较(sgd/momentum/Nesterov/adagrad/adadelta)
前言 这里讨论的优化问题指的是,给定目标函数f(x),我们需要找到一组参数x,使得f(x)的值最小. 本文以下内容假设读者已经了解机器学习基本知识,和梯度下降的原理. Batch gradient d ...
- 深度学习常见的优化方法(Optimizer)总结:Adam,SGD,Momentum,AdaGard等
机器学习的常见优化方法在最近的学习中经常遇到,但是还是不够精通.将自己的学习记录下来,以备不时之需 基础知识: 机器学习几乎所有的算法都要利用损失函数 lossfunction 来检验算法模型的优劣, ...
- 优化方法总结以及Adam存在的问题(SGD, Momentum, AdaDelta, Adam, AdamW,LazyAdam)
优化方法总结以及Adam存在的问题(SGD, Momentum, AdaDelta, Adam, AdamW,LazyAdam) 2019年05月29日 01:07:50 糖葫芦君 阅读数 455更多 ...
随机推荐
- P2328 [SCOI2005]超级格雷码
P2328 [SCOI2005]超级格雷码 暴力出奇迹喵! 这是一道模拟题 你会发现和 P5657 格雷码[民间数据]有异曲同工之妙,这道题直接按照上边链接题目的操作步骤 暴力模拟 就可以啊 我们观察 ...
- react native Expo适配全面屏/Expo识别全面屏和正常屏
一.最新版本的expo已经默认支持了全面屏,即不会像react native cli一样出现底部黑边 二.但是全面屏通过Dimensions.get('window')获取的高度还是不准确,因为全面屏 ...
- IO注意事项
read()方法返回值为什么是int? 因为字节输入流可以操作任意类型的文件,比如图片音频等,这些文件底层都是以二进制形式的存储的,如果每次读取都返回byte,有可能在读到中间的时候遇到1111111 ...
- Java csv
CsvWriter csvWriter = new CsvWriter("data2019052803.csv", ',', Charset.forName("UTF-8 ...
- JDBC获得DB2表结构并且将表中数据脱敏后转移的程序示例
完整项目地址:https://github.com/zifeiy/totomi 代码示例: import java.io.File; import java.io.FileInputStream; i ...
- webdriervAPI(警告框处理)
from selenium import webdriver driver = webdriver.Chorme() driver.get("http://www.baidu.co ...
- ffmpeg 使用 gdb 调试相关技巧
本文说明了,在ffmpeg二次开发或调用库的过程,如何借助于ffmpeg源码进行调试. 注:ffmpeg版本是4.0. 1. 编写代码 编写将pcm数据转换为mp2的代码 pcm_to_mp2.c # ...
- PJzhang:ms17-010永恒之蓝漏洞在windows 2008R2中的复现
猫宁!!! 参考: https://www.anquanke.com/post/id/86245 https://xz.aliyun.com/t/2536 https://www.cnblogs.co ...
- 【IDEA】格式化代码技巧汇总
1.格式化 Java 代码 快捷键:Ctrl+Alt+L 2.格式化 Mapper 文件中的 SQL 关联到数据库,让 IDEA 认识你的 SQL.如何关联?选择右侧的database,添加数据库即可 ...
- axios对请求各种异常情况处理的封装
前端网络请求封装 前端采用了axios来处理网络请求,为了避免在每次请求时都去判断各种各样的网络情况,比如连接超时.服务器内部错误.权限不足等等不一而足,我对axios进行了简单的封装,这里主要使用了 ...