
基于SVM的鸢尾花数据集分类实现[使用Matlab]
iris数据集的中文名是安德森鸢尾花卉数据集,英文全称是Anderson’s Iris data set。iris包含150个样本,对应数据集的每行数据。每行数据包含每个样本的四个特征和样本的类别信息,所以iris数据集是一个150行5列的二维表。通俗地说,iris数据集是用来给花做分类的数据集,每个样本包含了花萼长度、花萼宽度、花瓣长度、花瓣宽度四个特征(前4列),我们需要建立一个分类器,分类器可以通过样本的四个特征来判断样本属于山鸢尾、变色鸢尾还是维吉尼亚鸢尾(这三个名词都是花的品种)。
数据的获取:
file=importdata('iris.csv');%读取csv文件中从第R-1行,第C-1列的数据开始的数据

data=file.data;

features=data(:,:);%特征列表

classlabel=data(:,);%对应类别

n = randperm(size(features,));%随机产生训练集和测试集
绘制散点图查看数据:
%% 绘制散点图

class_0 = find(data(:,)==);

class_1 = find(data(:,)==);

class_2 = find(data(:,)==);%返回类别为2的位置索引

subplot(,,)

hold on

scatter(features(class_0,),features(class_0,),'x','b')

scatter(features(class_1,),features(class_1,),'+','g')

scatter(features(class_2,),features(class_2,),'o','r')

subplot(,,)

hold on

scatter(features(class_0,),features(class_0,),'x','b')

scatter(features(class_1,),features(class_1,),'+','g')

scatter(features(class_2,),features(class_2,),'o','r')

subplot(,,)

hold on

scatter(features(class_0,),features(class_0,),'x','b')

scatter(features(class_1,),features(class_1,),'+','g')

scatter(features(class_2,),features(class_2,),'o','r')

subplot(,,)

hold on

scatter(features(class_0,),features(class_0,),'x','b')

scatter(features(class_1,),features(class_1,),'+','g')

scatter(features(class_2,),features(class_2,),'o','r')

subplot(,,)

hold on

scatter(features(class_0,),features(class_0,),'x','b')

scatter(features(class_1,),features(class_1,),'+','g')

scatter(features(class_2,),features(class_2,),'o','r')

subplot(,,)

hold on

scatter(features(class_0,),features(class_0,),'x','b')

scatter(features(class_1,),features(class_1,),'+','g')

scatter(features(class_2,),features(class_2,),'o','r')
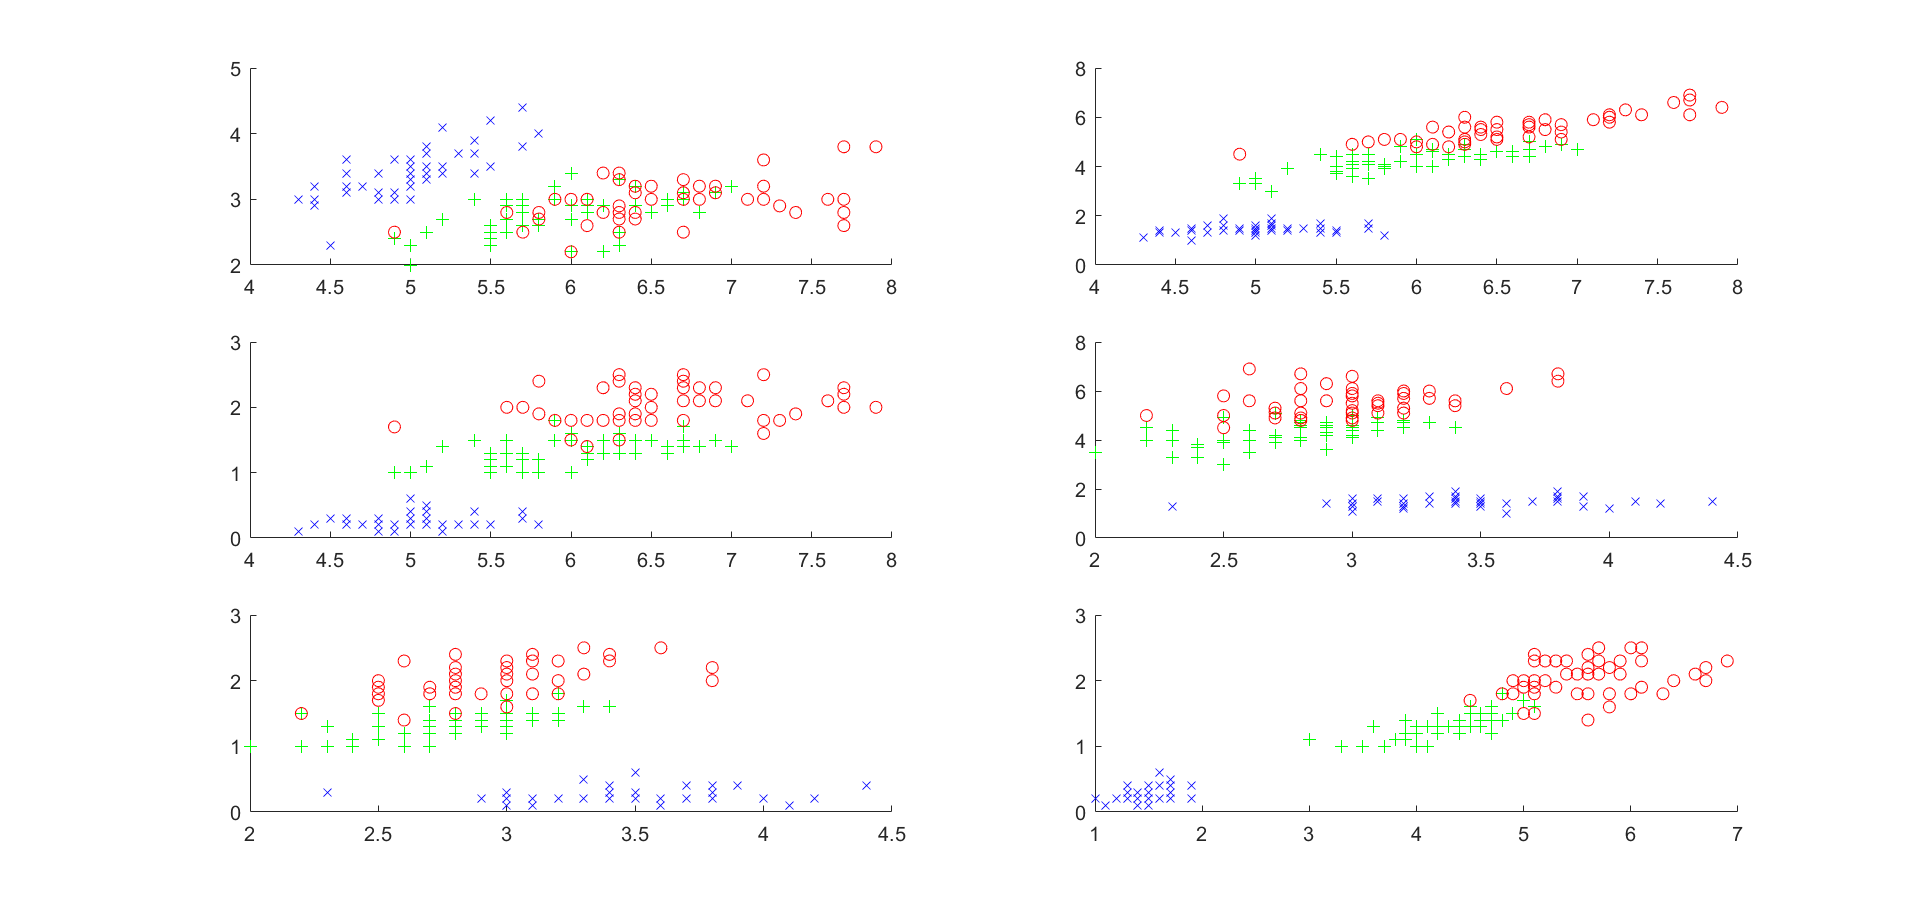
曲线为根据花萼长度、花萼宽度、花瓣长度、花瓣宽度之间的关系绘制的散点图。
训练集与测试集:
%% 训练集--70个样本

train_features=features(n(:),:);

train_label=classlabel(n(:),:);

%% 测试集--30个样本

test_features=features(n(:end),:);

test_label=classlabel(n(:end),:);
数据归一化:
%% 数据归一化

 [Train_features,PS] = mapminmax(train_features');

 Train_features = Train_features';

 Test_features = mapminmax('apply',test_features',PS);

 Test_features = Test_features';
使用SVM进行分类:
%% 创建/训练SVM模型

model = svmtrain(train_label,Train_features);

%% SVM仿真测试

[predict_train_label] = svmpredict(train_label,Train_features,model);

[predict_test_label] = svmpredict(test_label,Test_features,model);

%% 打印准确率

compare_train = (train_label == predict_train_label);

accuracy_train = sum(compare_train)/size(train_label,)*;

fprintf('训练集准确率:%f\n',accuracy_train)

compare_test = (test_label == predict_test_label);

accuracy_test = sum(compare_test)/size(test_label,)*;

fprintf('测试集准确率:%f\n',accuracy_test)
结果:
*
optimization finished, #iter = 18
nu = 0.668633
obj = -21.678546, rho = 0.380620
nSV = 30, nBSV = 28
*
optimization finished, #iter = 29
nu = 0.145900
obj = -3.676315, rho = -0.010665
nSV = 9, nBSV = 4
*
optimization finished, #iter = 21
nu = 0.088102
obj = -2.256080, rho = -0.133432
nSV = 7, nBSV = 2
Total nSV = 40
Accuracy = 97.1429% (68/70) (classification)
Accuracy = 97.5% (78/80) (classification)
训练集准确率:97.142857
测试集准确率:97.500000
基于SVM的鸢尾花数据集分类实现[使用Matlab]的更多相关文章
- Python实现鸢尾花数据集分类问题——基于skearn的SVM
Python实现鸢尾花数据集分类问题——基于skearn的SVM 代码如下: # !/usr/bin/env python # encoding: utf-8 __author__ = 'Xiaoli ...
- Python实现鸢尾花数据集分类问题——基于skearn的NaiveBayes
Python实现鸢尾花数据集分类问题——基于skearn的NaiveBayes 代码如下: # !/usr/bin/env python # encoding: utf-8 __author__ = ...
- Python实现鸢尾花数据集分类问题——基于skearn的LogisticRegression
Python实现鸢尾花数据集分类问题——基于skearn的LogisticRegression 一. 逻辑回归 逻辑回归(Logistic Regression)是用于处理因变量为分类变量的回归问题, ...
- python实现HOG+SVM对CIFAR-10数据集分类(上)
本博客只用于学习,如果有错误的地方,恳请指正,如需转载请注明出处. 看机器学习也是有一段时间了,这两天终于勇敢地踏出了第一步,实现了HOG+SVM对图片分类,具体代码可以在github上下载,http ...
- Python实现鸢尾花数据集分类问题——使用LogisticRegression分类器
. 逻辑回归 逻辑回归(Logistic Regression)是用于处理因变量为分类变量的回归问题,常见的是二分类或二项分布问题,也可以处理多分类问题,它实际上是属于一种分类方法. 概率p与因变量往 ...
- ML学习笔记之XGBoost实现对鸢尾花数据集分类预测
import xgboost as xgb import numpy as np import pandas as pd from sklearn.model_selection import tra ...
- 基于SKLearn的SVM模型垃圾邮件分类——代码实现及优化
一. 前言 由于最近有一个邮件分类的工作需要完成,研究了一下基于SVM的垃圾邮件分类模型.参照这位作者的思路(https://blog.csdn.net/qq_40186809/article/det ...
- 做一个logitic分类之鸢尾花数据集的分类
做一个logitic分类之鸢尾花数据集的分类 Iris 鸢尾花数据集是一个经典数据集,在统计学习和机器学习领域都经常被用作示例.数据集内包含 3 类共 150 条记录,每类各 50 个数据,每条记录都 ...
- 实验一 使用sklearn的决策树实现iris鸢尾花数据集的分类
使用sklearn的决策树实现iris鸢尾花数据集的分类 要求: 建立分类模型,至少包含4个剪枝参数:max_depth.min_samples_leaf .min_samples_split.max ...
随机推荐
- 什么是SOAP,有哪些应用
SOAP 是一种轻量级协议,用于在分散型.分布式环境中交换结构化信息. SOAP 利用 XML 技术定义一种可扩展的消息处理框架,它提供了一种可通过多种底层协议进行交换的消息结构. 这种框架的设计思想 ...
- 前端笔记之JavaScript(四)关于函数、作用域、闭包那点事
一.自定义函数function 函数就是功能.方法的封装.函数能够帮我们封装一段程序代码,这一段代码会具备某一项功能,函数在执行时,封装的这一段代码都会执行一次,实现某种功能.而且,函数可以多次调用. ...
- springboot情操陶冶-web配置(一)
承接前文springboot情操陶冶-@SpringBootApplication注解解析,在前文讲解的基础上依次看下web方面的相关配置 环境包依赖 在pom.xml文件中引入web依赖,炒鸡简单, ...
- Redis的复制是如何实现的?
前言 关系数据库通常会使用一个主服务器向多个从服务器发送更新,并使用从服务器来处理所有的读请求,Redis采用了同样方法来实现自己的复制特性. 简单总结起来就是:在接收到主服务器发送的数据初始副本之后 ...
- c#委托中的同步和异步方法即BeginInvoke和EndInvoke
学习多线程之前我们先了解一下电脑的一些概念,比如进程,线程,这个参考https://www.cnblogs.com/loverwangshan/p/10409755.html 这篇文章.今天我们接着来 ...
- 第46章 发现端点(Discovery Endpoint) - Identity Server 4 中文文档(v1.0.0)
发现端点可用于检索有关IdentityServer的元数据 - 它返回发布者名称,密钥材料,支持的范围等信息.有关详细信息,请参阅规范. 发现端点可通过/.well-known/openid-conf ...
- python3中time模块与datetime模块的简单用法
__author__ = "JentZhang" import time # Timestamp 时间戳 print("Timestamp 时间戳:") pri ...
- 基本数据类型 字典 dict
今日内容一.字典 dict======================================基本使用======================================1.用途:记录 ...
- css中关于table的相关设置
一.设置好看的单边框表格 1.一种实现方式 分别给table标签和td标签设置不在同一方向的border属性,如下table设置‘左上’边框,td设置‘右下’边框.其他设置方式同样可以实现. tabl ...
- vue 新版本 webpack 代理 跨域设置
旧版本中:dev-server.js 这段去掉 var apiRoutes = express.Router() //getList apiRoutes.get('/getDiscList', fun ...