
使用keras的LSTM进行预测----实战练习
代码
import numpy as np

from keras.models import Sequential

from keras.layers import Dense

from keras.layers import LSTM

import marksix_1

import talib as ta

lt = marksix_1.Marksix()

lt.load_data(period=500)

# 指标序列

m = 2

series = lt.adapter(loc='', zb_name='mod', args=(m, lt.get_mod_list(m)), tf_n=0)

# 实时线

close = np.cumsum(series).astype(float)

# 布林线

timeperiod = 5

upper, middle, lower = ta.BBANDS(close, timeperiod=timeperiod, nbdevup=2, nbdevdn=2, matype=0)

# 趋势

qushi1 = np.where(close-middle < 0, 0, 1)# 实时线在均线上、下方

qushi2 = np.where(middle[1:] - middle[:-1] < 0, 0, 1) # 均线上、下行(长度少了1)

# 标签转化为0,1

y = np.where(series==-1, 0, 1)

# 构造特征(注意,已经归一化,全部为非负数)

f = upper-lower

f = f[timeperiod:] # 去掉了前面timeperiod个nan数据!!!

f = (f - f.min()) / (f.max() - f.min()) # 归一化

y = y[timeperiod:]

qushi1 = qushi1[timeperiod:]

qushi2 = qushi2[timeperiod-1:]

features = np.column_stack([y, qushi1, qushi2, f]) # 特征:[标签、趋势1、趋势2、布林宽度]

#

data_len = len(series)

time_steps = 3

# 将数据转化为[样本数, 时间步数, 特征数]的形式

X = [features[i:i+time_steps] for i in range(data_len-time_steps-timeperiod)] # [samples, time steps * features]

X = np.reshape(X, (data_len - time_steps-timeperiod, time_steps, -1)) # [samples, time steps, features]

# 标签长度一致

y = y[time_steps:]

# one-hot编码

y = np.eye(2)[y]

# 划分训练数据、测试数据

train_X, test_X = X[:-20], X[-20:]

train_y, test_y = y[:-20], y[-20:]

# =================================

model = Sequential()

model.add(LSTM(64, input_shape=(X.shape[1], X.shape[2])))

model.add(Dense(y.shape[1], activation='softmax')) # 输出各类的概率(softmax)

model.compile(loss='categorical_crossentropy',     # 单标签,多分类(categorical_crossentropy)

              optimizer='adam',

              metrics=['accuracy'])

model.fit(train_X, train_y, epochs=500, batch_size=1, verbose=2)

#检查模型在测试集上的表现是否良好

test_loss, test_acc = model.evaluate(test_X, test_y)

print('test_acc:', test_acc)
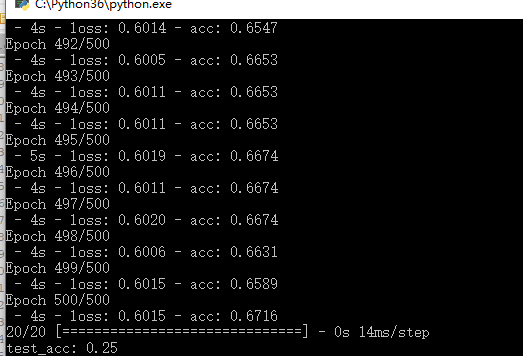
效果图

结论
只测试了mod 2的情况,效果不好.
训练数据精度可以达到三分之二左右,测试数据的精度只有四分之一。头脑风暴,几乎可以反其道而行之!可能不失为可行之策。
下一步:
1.画出后20个数据k线图,看是否是震荡区间,亦或是趋势区间
2.换别的指标看看
使用keras的LSTM进行预测----实战练习的更多相关文章
- Kesci: Keras 实现 LSTM——时间序列预测
博主之前参与的一个科研项目是用 LSTM 结合 Attention 机制依据作物生长期内气象环境因素预测作物产量.本篇博客将介绍如何用 keras 深度学习的框架搭建 LSTM 模型对时间序列做预测. ...
- 基于 Keras 用 LSTM 网络做时间序列预测
目录 基于 Keras 用 LSTM 网络做时间序列预测 问题描述 长短记忆网络 LSTM 网络回归 LSTM 网络回归结合窗口法 基于时间步的 LSTM 网络回归 在批量训练之间保持 LSTM 的记 ...
- 用keras实现lstm 利用Keras下的LSTM进行情感分析
1 I either LOVE Brokeback Mountain or think it’s great that homosexuality is becoming more accept ...
- 时间序列深度学习:状态 LSTM 模型预测太阳黑子
目录 时间序列深度学习:状态 LSTM 模型预测太阳黑子 教程概览 商业应用 长短期记忆(LSTM)模型 太阳黑子数据集 构建 LSTM 模型预测太阳黑子 1 若干相关包 2 数据 3 探索性数据分析 ...
- 基于 Keras 用深度学习预测时间序列
目录 基于 Keras 用深度学习预测时间序列 问题描述 多层感知机回归 多层感知机回归结合"窗口法" 改进方向 扩展阅读 本文主要参考了 Jason Brownlee 的博文 T ...
- Pytorch循环神经网络LSTM时间序列预测风速
#时间序列预测分析就是利用过去一段时间内某事件时间的特征来预测未来一段时间内该事件的特征.这是一类相对比较复杂的预测建模问题,和回归分析模型的预测不同,时间序列模型是依赖于事件发生的先后顺序的,同样大 ...
- 基于 Keras 的 LSTM 时间序列分析——以苹果股价预测为例
简介 时间序列简单的说就是各时间点上形成的数值序列,时间序列分析就是通过观察历史数据预测未来的值.预测未来股价走势是一个再好不过的例子了.在本文中,我们将看到如何在递归神经网络的帮助下执行时间序列分析 ...
- 手把手教你用 Keras 实现 LSTM 预测英语单词发音
1. 动机 我近期在研究一个 NLP 项目,根据项目的要求,需要能够通过设计算法和模型处理单词的音节 (Syllables),并对那些没有在词典中出现的单词找到其在词典中对应的押韵词(注:这类单词类似 ...
- LSTM时间序列预测及网络层搭建
一.LSTM预测未来一年某航空公司的客运流量 给你一个数据集,只有一列数据,这是一个关于时间序列的数据,从这个时间序列中预测未来一年某航空公司的客运流量.数据形式: 二.实战 1)数据下载 你可以go ...
随机推荐
- C# 实现FTP客户端
本文是利用C# 实现FTP客户端的小例子,主要实现上传,下载,删除等功能,以供学习分享使用. 思路: 通过读取FTP站点的目录信息,列出对应的文件及文件夹. 双击目录,则显示子目录,如果是文件,则点击 ...
- java----OO的概念和设计原则(转)
一.OO(面向对象)的设计基础 面向对象(OO):就是基于对象概念,以对象为中心,以类和继承为构造机制,充分利用接口和多态提供灵活性, 来认识.理解.刻划客观世界和设计.构建相应的软件系统.面向对象的 ...
- 一、Tableau基础
有关函数的官方文档:https://onlinehelp.tableau.com/current/pro/desktop/zh-cn/functions_functions_string.htm 注意 ...
- 高通 NXP NFC(PN547PN548) 移植流程 android6.0
一.驱动部分 首先向NXP 的 fae要android 6.0 bring up的代码,如:NFC_NCIHALx_AR0F.4.3.0_M_NoSE 结构目录如下: 1. 添加驱动文件 高通平台需使 ...
- c/c++ 链栈
c/c++ 链栈 链栈 下面的代码实现了以下功能 函数 功能描述 push 压入 pop 弹出 show_list 打印 clear 释放所有内存空间 destroy 释放所有内存空间 nodesta ...
- Windows Server 2016-清理残留域控信息
本章紧接上文,当生产环境中域控出现问题无法修复以后,一方面我们需要考虑抢夺FSMO角色,另一方面我们需要考虑的问题是清理当前域控的残留信息,以防止残留数据信息导致用户验证或者解析异常等问题.本章讲到如 ...
- 洛谷模拟NOIP考试反思
洛谷模拟NOIP考试反思 想法 考了这么简单的试qwq然而依然emmmmmm成绩不好 虽然本次难度应该是大于正常PJ难度的但还是很不理想,离预估分数差很多qwq 于是就有了本反思嘤嘤嘤 比赛链接 原比 ...
- 微服务---Eureka注册中心(服务治理)
在上一篇的初识SpringCloud微服务中,我们简单讲解到服务的提供者与消费者,当服务多了之后,会存在依赖与管理之间混乱的问题,以及需要对外暴露自己的地址,为了解决此等问题,我们学习Eureka注册 ...
- FastJSON、Gson和Jackson性能对比
Java处理JSON数据有三个比较流行的类库FastJSON.Gson和Jackson.本文将测试这三个类库在JSON序列化和反序列化的方面表现,主要测试JSON序列化和反序列化的速度.为了防止由于内 ...
- 不同主机的docker容器互相通信
Docker启动时,会在宿主主机上创建一个名为docker0的虚拟网络接口,默认选择172.17.0.1/16,一个16位的子网掩码给容器提供了 65534个IP地址. docker0只是一个在绑定到 ...