
大数据笔记(十五)——Hive的体系结构与安装配置、数据模型
一.常见的数据分析引擎
- Hive:Hive是一个翻译器,一个基于Hadoop之上的数据仓库,把SQL语句翻译成一个 MapReduce程序。可以看成是Hive到MapReduce的映射器。
Hive HDFS
表 目录
数据 文件
分区 目2
2.Pig
3.Impala
4.Spark SQL
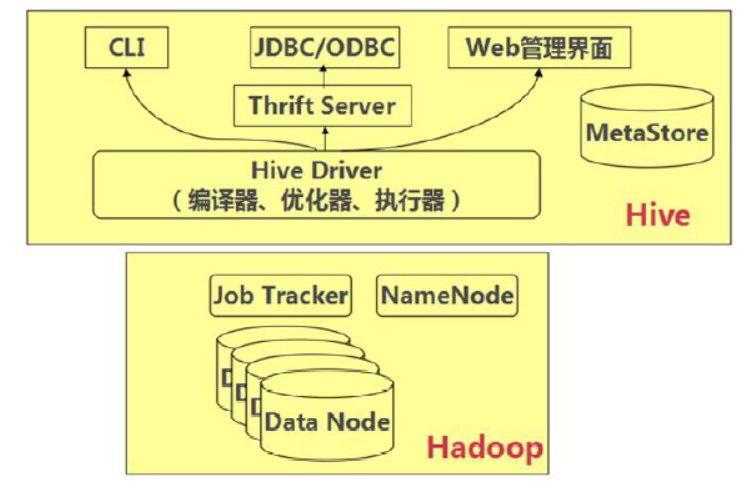
二.Hive 的体系结构
用户接口主要有三个:
1.CLI Shell命令行
2.JDBC/ODBC:Hive的Java,与传统JDBC相似
3.Web管理界面
三.Hive的安装和配置
1、安装模式:嵌入模式 ----> 需要Hive自带的一个关系型数据库:Derby
本地模式、远程模式 ----> 需要MySQL数据库的支持
tar -zxvf apache-hive-2.3.0-bin.tar.gz -C ~/training/
环境变量:vi ~/.bash_profile
HIVE_HOME=/root/training/apache-hive-2.3.0-bin

export HIVE_HOME

PATH=$HIVE_HOME/bin:$PATH

export PATH
2、嵌入模式
(1)使用Hive自带的Derby数据库来存储元信息
(2)Hive只支持一个连接
创建 conf/hive-site.xml
<?xml version="1.0" encoding="UTF-8" standalone="no"?>

<?xml-stylesheet type="text/xsl" href="configuration.xsl"?>

<configuration>

<property>

  <name>javax.jdo.option.ConnectionURL</name>

  <value>jdbc:derby:;databaseName=metastore_db;create=true</value>

</property>

<property>

  <name>javax.jdo.option.ConnectionDriverName</name>

  <value>org.apache.derby.jdbc.EmbeddedDriver</value>

</property>

<property>

  <name>hive.metastore.local</name>

  <value>true</value>

</property>

<property>

  <name>hive.metastore.warehouse.dir</name>

  <value>file:///root/training/apache-hive-2.3.0-bin/warehouse</value>

</property>

</configuration>
初始化MetaStore:
schematool -dbType derby -initSchema
日志:
Hive-on-MR is deprecated in Hive 2 and may not be available in the future versions. Consider using a different execution engine (i.e. spark, tez) or using Hive 1.X releases.
3.远程模式:MySQL
(1)配置MySQL的数据库:http://www.mysqlfront.de/
(2)配置hive-site.xml: JDBC的参数
<?xml version="1.0" encoding="UTF-8" standalone="no"?>

<?xml-stylesheet type="text/xsl" href="configuration.xsl"?>

<configuration>

<property>

  <name>javax.jdo.option.ConnectionURL</name>

  <value>jdbc:mysql://localhost:3306/hive?useSSL=false</value>

</property>

<property>

  <name>javax.jdo.option.ConnectionDriverName</name>

  <value>com.mysql.jdbc.Driver</value>

</property>

<property>

  <name>javax.jdo.option.ConnectionUserName</name>

  <value>hiveowner</value>

</property>

<property>

  <name>javax.jdo.option.ConnectionPassword</name>

  <value>Welcome_1</value>

</property>

</configuration>
(3)把MySQL数据库的驱动放到: Hive/lib下
(4)初始化MySQL数据库
老版本的Hive:第一次运行Hive
新版本的hive:schematool -dbType mysql -initSchema
四. Hive的数据模型
- 内部表:相当于MySQL(Oracle)中表,将数据保存到Hive自己的数据仓库的 目录中: /usr/hive/warehouse
建表:
create table emp

(empno int,

ename string,

job string,

mgr int,

hiredate string,

sal int,

comm int,

deptno int

);
创建表,并且指定分隔符
create table emp1

(empno int,

ename string,

job string,

mgr int,

hiredate string,

sal int,

comm int,

deptno int

)row format delimited fields terminated by ',';
导入数据:load相当于ctrl+X
load data inpath '/scott/emp.csv' into table emp; ----> 导入HDFS
load data local inpath '/root/temp/***' into table emp; ----> 导入本地文件
创建部门表,保存部门数据
create table dept

(deptno int,

dname string,

loc string

)row format delimited fields terminated by ',';

load data inpath '/scott/dept.csv' into table dept;
2.分区表:提高查询的效率----> 查看SQL的执行计划
分区 ----> 目录
(*)根据员工的部门号建立分区
create table emp_part

(empno int,

ename string,

job string,

mgr int,

hiredate string,

sal int,

comm int

)partitioned by (deptno int)

row format delimited fields terminated by ',';
往分区表中导入数据:指明分区
insert into table emp_part partition(deptno=10) select empno,ename,job,mgr,hiredate,sal,comm from emp1 where deptno=10;

insert into table emp_part partition(deptno=20) select empno,ename,job,mgr,hiredate,sal,comm from emp1 where deptno=20;

insert into table emp_part partition(deptno=30) select empno,ename,job,mgr,hiredate,sal,comm from emp1 where deptno=30
3.外部表 external table 相对于内部表
(*)实验的数据
[root@bigdata11 ~]# hdfs dfs -cat /students/student01.txt
1,Tom,23
2,Mary,24
[root@bigdata11 ~]# hdfs dfs -cat /students/student02.txt
3,Mike,26
(*)定义:(1)表结构 (2)指向的路径
create external table students_ext

(sid int,sname string,age int)

row format delimited fields terminated by ','

location '/students';
4、桶表:本质也是一种分区表,类似Hash分区
桶 ----> 文件
创建一个桶表,按照员工的职位job分桶
create table emp_bucket

(empno int,

ename string,

job string,

mgr int,

hiredate string,

sal int,

comm int,

deptno int

)clustered by (job) into 4 buckets

row format delimited fields terminated by ',';
使用桶表,需要打开一个开关
set hive.enforce.bucketing=true;
使用子查询插入数据
insert into emp_bucket select * from emp1;
5、视图:view
(*)视图是一个虚表,虚:视图是不存数据的
(*)优点:简化复杂的查询
(*)举例:查询部门名称、员工的姓名
create view myview

as

select dept.dname,emp1.ename

from emp1,dept

where emp1.deptno=dept.deptno;

select * from myview;
6、Hive的查询
(1)查询所有的员工信息
select * from emp1;
(2)查询员工信息:员工号 姓名 薪水
select empno,ename,sal from emp1;
(3)多表查询:查询部门名称、员工的姓名
select dept.dname,emp1.ename
from emp1,dept
where emp1.deptno=dept.deptno;
(4)子查询:hive只支持:from和where后面的子查询
(5)内置函数:select max(sal) from emp1;
(6)n条件函数 就是一个if else: 做一个报表:涨工资,总裁1000 经理800 其他400
select empno,ename,job,sal,
case job when 'PRESIDENT' then sal+1000
when 'MANAGER' then sal+800
else sal+400
end
from emp1;
select empno,ename,job,sal,
case job when 'PRESIDENT' then sal+1000
when 'MANAGER' then sal+800
else sal+400
end
from emp;
大数据笔记(十五)——Hive的体系结构与安装配置、数据模型的更多相关文章
- 分布式大数据多维分析(OLAP)引擎Apache Kylin安装配置及使用示例【转】
Kylin 麒麟官网:http://kylin.apache.org/cn/download/ 关键字:olap.Kylin Apache Kylin是一个开源的分布式分析引擎,提供Hadoop之上的 ...
- 大数据笔记(五)——HDFS的高级特性
一.HDFS的回收站: recyclebin 1.HDFS的回收站默认是关闭的 2.启用回收站:去core-site.xml配置 路径:/root/training/hadoop-2.7.3/etc/ ...
- 大数据笔记(三)——Hadoop2.0的安装与配置
一.Hadoop安装部署的预备条件 准备:1.安装Linux和JDK. 安装JDK 解压:tar -zxvf jdk-8u144-linux-x64.tar.gz -C ~/training/ 设置环 ...
- 跟上节奏 大数据时代十大必备IT技能
跟上节奏 大数据时代十大必备IT技能 新的想法诞生新的技术,从而造出许多新词,云计算.大数据.BYOD.社交媒体……在互联网时代,各种新词层出不穷,让人应接不暇.这些新的技术,这些新兴应用和对应的IT ...
- 大数据工具篇之Hive与MySQL整合完整教程
大数据工具篇之Hive与MySQL整合完整教程 一.引言 Hive元数据存储可以放到RDBMS数据库中,本文以Hive与MySQL数据库的整合为目标,详细说明Hive与MySQL的整合方法. 二.安装 ...
- 大数据工具篇之Hive与HBase整合完整教程
大数据工具篇之Hive与HBase整合完整教程 一.引言 最近的一次培训,用户特意提到Hadoop环境下HDFS中存储的文件如何才能导入到HBase,关于这部分基于HBase Java API的写入方 ...
- CentOS6安装各种大数据软件 第五章:Kafka集群的配置
相关文章链接 CentOS6安装各种大数据软件 第一章:各个软件版本介绍 CentOS6安装各种大数据软件 第二章:Linux各个软件启动命令 CentOS6安装各种大数据软件 第三章:Linux基础 ...
- 大数据系列之数据仓库Hive安装
Hive系列博文,持续更新~~~ 大数据系列之数据仓库Hive原理 大数据系列之数据仓库Hive安装 大数据系列之数据仓库Hive中分区Partition如何使用 大数据系列之数据仓库Hive命令使用 ...
- 大数据系列之数据仓库Hive命令使用及JDBC连接
Hive系列博文,持续更新~~~ 大数据系列之数据仓库Hive原理 大数据系列之数据仓库Hive安装 大数据系列之数据仓库Hive中分区Partition如何使用 大数据系列之数据仓库Hive命令使用 ...
随机推荐
- [DS+Algo] 005 三种简单排序及其代码实现
目录 1. 冒泡排序 BubbleSort 1.1 算法描述 1.2 性能分析 1.3 Python 代码实现 2. 选择排序 SelectionSort 2.1 算法描述 2.2 选择排序的主要优点 ...
- spring boot @Transactional的一个小坑
同一个类Service下,有两个函数 method_1和 method_2,且method_1内部调用了method_2,那么希望method_2内部意外时,数据库回滚,那么一定要在method_1上 ...
- centos6配置本地yum源
在无法访问外网时,yum安装软件会失败,这时候可以配置yum源为本地的镜像iso来解决这个问题 1. 使用Xftp上传iso镜像文件到服务器 2. 使用如下命令新建挂载点并挂载 sudo mkdir ...
- HNUSTOJ-1698 送外卖(TSP问题 + 状态压缩DP)
1698: 送外卖 时间限制: 1 Sec 内存限制: 128 MB提交: 123 解决: 28[提交][状态][讨论版] 题目描述 在美团和饿了么大行其道的今天,囊中羞涩的小周和小美,也随大流加 ...
- vue-split-table【表格合并和编辑插件】
前言 vue-split-table应用的效果图 vue-split-table开源地址,欢迎star,现在已经开源和同步到npm上轻松搞定表格拆分或者合并,编辑,再也不怕被产品怼啦 1.核心源码分析 ...
- Resharper 2019.1.1 破解
本文链接:https://blog.csdn.net/qq_21361809/article/details/92423949 Resharper ...
- Hadoop本地模式搭建
官方文档,不同版本修改url地址中的数字即可 http://hadoop.apache.org/docs/r2.7.2/hadoop-project-dist/hadoop-common/Single ...
- MongoDB的使用学习之(六)MongoDB的高级查询之条件操作符
此文分为两点,主要是在第二点--java 语法,但是按顺序必须先把原生态的语法写出来 (还有一篇文章也是不错的:MongoDB高级查询用法大全(包含MongoDB命令语法和Java语法,其实就是我整理 ...
- Cockpit- Linux 服务器管理接口
Cockpit- Linux 服务器管理接口 功能 它包含 systemd 服务管理器. 有一个用于故障排除和日志分析的 Journal 日志查看器. 包括 LVM 在内的存储配置比以前任何时候都要简 ...
- Linux下安装chrome浏览器
第一步:进入google-chrome官网下载chrome安装包 官网地址:https://www.google.cn/chrome/ 选择要下载的安装包 注意:这里有两个选项,请按照你安装的系统下载 ...