
[Python爬虫] 使用 Beautiful Soup 4 快速爬取所需的网页信息
一、前言
之前使用原生的 Python 库去爬取网页信息,经常要使用正则表达式,笔者记性不是很好,经常经常忘记相关符号及其作用。
后来使用著名的 Scrapy 框架去爬取信息,感觉太笨重了,特别是一个项目开发到一半,要引入爬虫功能,再使用 Scrapy,就不是那么友好了,其本身就是一个 Web Project。
近来使用一个和之前 Java 爬虫特别简单好使的 Jsoup 框架极其类似的 Beautiful Soup
引入也很简单:
# Python 2+

pip install beautifulsoup4

# Python 3+

pip3 install beautifulsoup4- 1
- 2
- 3
- 4
- 5
使用 Python 爬虫体验当然是比 Java 要好,java开发有点 “做作” —— 每一步都极其格式化(面向对象),Python 则运用自如。
二、需求
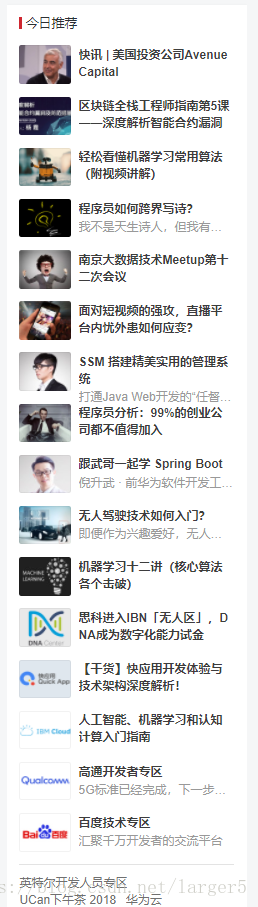
现在要爬取 CSDN首页 的今日推荐的 文章 标题 及其 链接,
2.1.这是网页目标内容
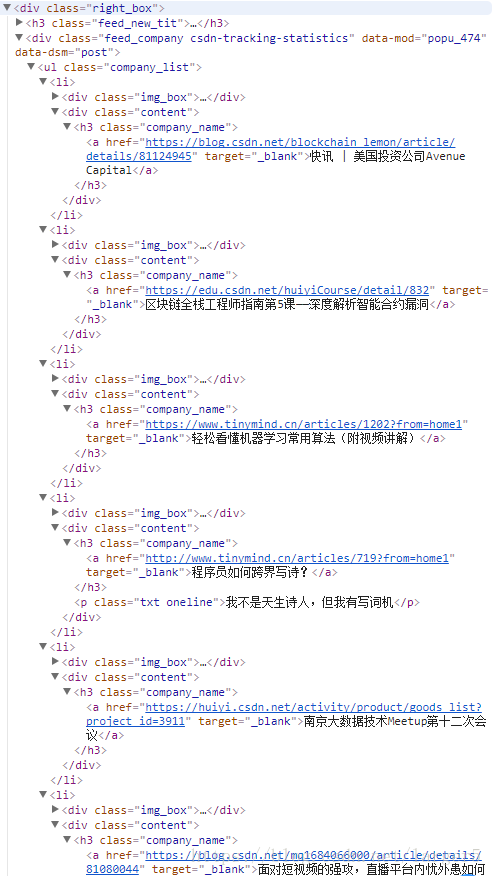
2.2.这是网页目标内容对应的源码
三、实践
你猜需要多少行代码,没错,就这几行,就是这么牛逼。
因力求精简,笔者为此费了几个小时通读官方 API 文档数遍。
3.1.代码
from bs4 import BeautifulSoup

from urllib.request import urlopen

html = urlopen("https://www.csdn.net/").read().decode('utf-8')

soup = BeautifulSoup(html,"html.parser")

titles=soup.select("h3[class='company_name'] a") # CSS 选择器

for title in titles:

print(title.get_text(),title.get('href'))# 标签体、标签属性- 1
- 2
- 3
- 4
- 5
- 6
- 7
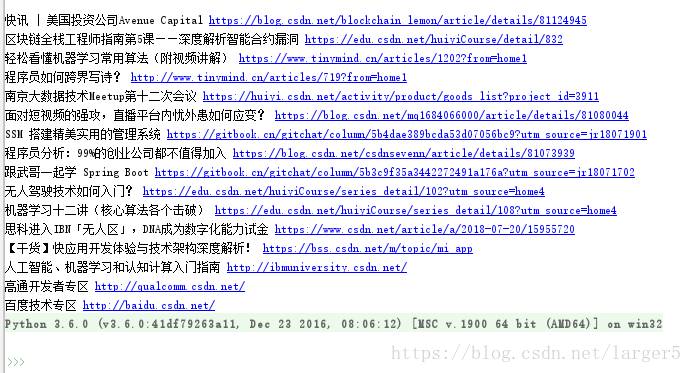
3.2.效果
四、小结
参考文献:
Beautiful Soup 中文文档
[Python爬虫] 使用 Beautiful Soup 4 快速爬取所需的网页信息的更多相关文章
- python爬虫之Beautiful Soup基础知识+实例
python爬虫之Beautiful Soup基础知识 Beautiful Soup是一个可以从HTML或XML文件中提取数据的python库.它能通过你喜欢的转换器实现惯用的文档导航,查找,修改文档 ...
- Python爬虫之Beautiful Soup解析库的使用(五)
Python爬虫之Beautiful Soup解析库的使用 Beautiful Soup-介绍 Python第三方库,用于从HTML或XML中提取数据官方:http://www.crummv.com/ ...
- python 爬虫利器 Beautiful Soup
python 爬虫利器 Beautiful Soup Beautiful Soup 是一个可以从HTML或XML文件中提取数据的Python库.它能够通过你喜欢的转换器实现惯用的文档导航,查找,修改文 ...
- Python爬虫教程-13-爬虫使用cookie爬取登录后的页面(人人网)(下)
Python爬虫教程-13-爬虫使用cookie爬取登录后的页面(下) 自动使用cookie的方法,告别手动拷贝cookie http模块包含一些关于cookie的模块,通过他们我们可以自动的使用co ...
- Python爬虫库-Beautiful Soup的使用
Beautiful Soup 是一个可以从HTML或XML文件中提取数据的Python库,简单来说,它能将HTML的标签文件解析成树形结构,然后方便地获取到指定标签的对应属性. 如在上一篇文章通过爬虫 ...
- python爬虫之Beautiful Soup的基本使用
1.简介 简单来说,Beautiful Soup是python的一个库,最主要的功能是从网页抓取数据.官方解释如下: Beautiful Soup提供一些简单的.python式的函数用来处理导航.搜索 ...
- python标准库Beautiful Soup与MongoDb爬喜马拉雅电台的总结
Beautiful Soup标准库是一个可以从HTML/XML文件中提取数据的Python库,它能够通过你喜欢的转换器实现惯用的文档导航,查找,修改文档的方式,Beautiful Soup将会节省数小 ...
- python 爬虫5 Beautiful Soup的用法
1.创建 Beautiful Soup 对象 from bs4 import BeautifulSoup html = """ <html><head& ...
- Python爬虫实战(2):爬取京东商品列表
1,引言 在上一篇<Python爬虫实战:爬取Drupal论坛帖子列表>,爬取了一个用Drupal做的论坛,是静态页面,抓取比较容易,即使直接解析html源文件都可以抓取到需要的内容.相反 ...
随机推荐
- git submodule 如何push代码
某git项目关联了一个submodule 如何更新该项目下的submodule https://stackoverflow.com/questions/5814319/git-submodule-pu ...
- Flutter移动电商实战 --(50)持久化_shared_preferences
当app关掉了.再进去的时候 ,购物车的内容还是存在. sqflite提供这个来操作SQLite数据库 flutter提供三种持久化的工具 今天要学的就是 shared_preferences 还有一 ...
- python脚本-excel批量转换为csv文件
pandas和SQL数据分析实战视频教程 https://study.163.com/course/courseMain.htm?courseId=1006383008&share=2& ...
- Ionic4.x 中的列表UI组件
1.普通列表 <ion-list> <ion-item> <ion-label>Peperoni</ion-label> </ion-item&g ...
- python使用退格键时出现^H解决方法
Linux 使用退格键时出现^H解决方法 1.临时解决 按ctrl 2.永久解决 基本现象 进入 Python shell,按下 Delete/Backspace 键: Python 3.5.2 (d ...
- iOS-objective-c产生随机数的方法
objective-c 中三种产生随机数的方法 //arc4random() 比较精确不需要生成随即种子 //通过arc4random() 获取0到x-1之间的整数的代码如下: int val ...
- python爬取网页数据方法
"""#最基本,请求地址无参数# response=urllib.request.urlopen("https://www.scetc.edu.cn" ...
- leetcode1277 Count Square Submatrices with All Ones
思路: 使用动态规划,dp[i][j]表示以(i, j)作为右下角的最大的全1矩阵的边长. 实现: class Solution { public: int countSquares(vector&l ...
- TF-IDF算法与余弦相似性
(注:本文转载自阮一峰老师的博文,原文地址:http://www.ruanyifeng.com/blog/2013/03/cosine_similarity.html) 今天,我们再来研究另一个相关的 ...
- CardView的使用(可以实现圆角控件)
简介:ardView继承自FrameLayout,它是一个带圆角背景和阴影的FrameLayout 一些什么实现方式就不赘述了,直接上用法 CardView的常用属性 1.设置背景颜色 app: ...