
Python 爬虫利器 Selenium
前面几节,我们学习了用 requests 构造页面请求来爬取静态网页中的信息以及通过 requests 构造 Ajax 请求直接获取返回的 JSON 信息。
还记得前几节,我们在构造请求时会给请求加上浏览器 headers,目的就是为了让我们的请求模拟浏览器的行为,防止被网站的反爬虫策略限制。今天要介绍的 Selenium 是一款强大的工具,它可以控制我们的浏览器,这样一来程序的行为就和人类完全一样了。
通过使用 Selenium 可以解决几个问题:
- 页面内容是由 JavaScript 动态生成,通过 requests 请求页面无法获取内容。
- 爬虫程序被反爬虫策略限制
- 让程序的行为和人一样
安装
pip install selenium安装浏览器驱动
下载后把驱动文件加入环境变量。或者直接把驱动文件和 Python脚本放到同一文件夹下面
测试
安装完成后,可以编写以下脚本来测试是否安装成功。from selenium import webdriver
driver = webdriver.Chrome() # 创建一个 Chrome WebDriver 实例
driver.get('https://www.baidu.com/') # 打开网址
运行后会发现程序自动打开了 Chrome 浏览器,并且定向到了百度首页。
与页面交互
WebDriver定义了很多方法,我们可以很方便的操作页面上的元素
比如获取元素,可以通过driver.find_element_by_id("id")或者driver.find_element_by_name("name")以及 xpath路径的方式来获取元素。可以通过send_keys 向输入框中写入文本。from selenium import webdriver
driver = webdriver.Chrome()
driver.get('https://www.baidu.com/')
search_input = driver.find_element_by_id("kw") # 获取到百度搜索框
search_input.send_keys("刘亦菲") # 自动输入 刘亦菲
submit = driver.find_element_by_id("su") # 获取到百度一下按钮
submit.click() # 点击搜索
运行以上脚本,程序会自动打开 Chrome 浏览器,并自动搜索 刘亦菲
其他操作
Selenium 可以进行各种各样的操作,使程序完全符合人类的操作习惯。下面看一下还有哪些功能。
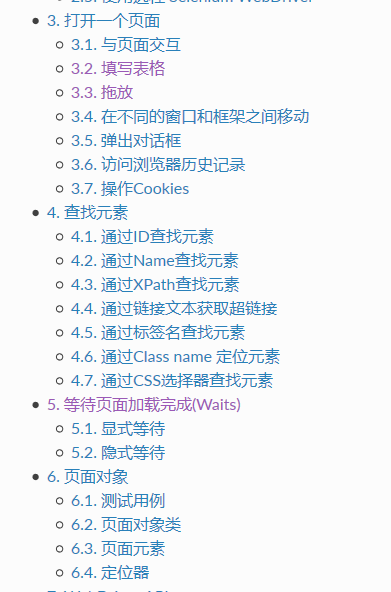
具体可以看官方文档,这里贴一下地址

[https://selenium-python-zh.readthedocs.io/en/latest/index.html](https://selenium-python-zh.readthedocs.io/en/latest/index.html)
Python 爬虫利器 Selenium的更多相关文章
- Python 爬虫利器 Selenium 介绍
Python 爬虫利器 Selenium 介绍 转 https://mp.weixin.qq.com/s/YJGjZkUejEos_yJ1ukp5kw 前面几节,我们学习了用 requests 构造页 ...
- python爬虫利器Selenium使用详解
简介: 用pyhon爬取动态页面时普通的urllib2无法实现,例如下面的京东首页,随着滚动条的下拉会加载新的内容,而urllib2就无法抓取这些内容,此时就需要今天的主角selenium. Sele ...
- (转)Python爬虫利器一之Requests库的用法
官方文档 以下内容大多来自于官方文档,本文进行了一些修改和总结.要了解更多可以参考 官方文档 安装 利用 pip 安装 $ pip install requests 或者利用 easy_install ...
- [Python爬虫]使用Selenium操作浏览器订购火车票
这个专题主要说的是Python在爬虫方面的应用,包括爬取和处理部分 [Python爬虫]使用Python爬取动态网页-腾讯动漫(Selenium) [Python爬虫]使用Python爬取静态网页-斗 ...
- Python爬虫利器二之Beautiful Soup的用法
上一节我们介绍了正则表达式,它的内容其实还是蛮多的,如果一个正则匹配稍有差池,那可能程序就处在永久的循环之中,而且有的小伙伴们也对写正则表达式的写法用得不熟练,没关系,我们还有一个更强大的工具,叫Be ...
- Python爬虫之selenium的使用(八)
Python爬虫之selenium的使用 一.简介 二.安装 三.使用 一.简介 Selenium 是自动化测试工具.它支持各种浏览器,包括 Chrome,Safari,Firefox 等主流界面式浏 ...
- python 爬虫利器 Beautiful Soup
python 爬虫利器 Beautiful Soup Beautiful Soup 是一个可以从HTML或XML文件中提取数据的Python库.它能够通过你喜欢的转换器实现惯用的文档导航,查找,修改文 ...
- Python爬虫利器六之PyQuery的用法
前言 你是否觉得 XPath 的用法多少有点晦涩难记呢? 你是否觉得 BeautifulSoup 的语法多少有些悭吝难懂呢? 你是否甚至还在苦苦研究正则表达式却因为少些了一个点而抓狂呢? 你是否已经有 ...
- Python爬虫利器一之Requests库的用法
前言 之前我们用了 urllib 库,这个作为入门的工具还是不错的,对了解一些爬虫的基本理念,掌握爬虫爬取的流程有所帮助.入门之后,我们就需要学习一些更加高级的内容和工具来方便我们的爬取.那么这一节来 ...
随机推荐
- docker部署jira破解版
1.制作Dockerfile FROM cptactionhank/atlassian-jira-software:7.12.0 USER root # 将代理破解包加入容器 COPY "a ...
- SpringMVC 手动控制事务提交 【转】
1.配置文件 applicationContext.xml: <bean id="txManager" class="org.springframework.jdb ...
- 出错:Error creating bean with name 'studentServiceImpl': Unsatisfied dependency expressed through field 'studentMapper';
详细错误: org.springframework.beans.factory.UnsatisfiedDependencyException: Error creating bean with nam ...
- UI---设置Activity背景为透明
1.在values下colors中设置透明颜色 <?xml version="1.0" encoding="utf-8"?> <resourc ...
- SpringBoot动态配置加载
1.SpringBoot对配置文件集中化进行管理,方便进行管理,也可以使用HttpClient进行对远程的配置文件进行获取. 创建一个类实现EnvironmentPostProcessor 接口,然后 ...
- Nginx+DNS负载均衡实现
负载均衡有多种实现方法,nginx.apache.LVS.F5硬件.DNS等. DNS的负载均衡就是一个域名指向多个ip地址,客户访问的时候进行轮询解析 操作方法,在域名服务商解析的DNS也可以是第三 ...
- 2019全国大学生信息安全竞赛初赛pwn前四题writeup—栈部分
ret to libc技巧:https://blog.csdn.net/zh_explorer/article/details/80306965 如何leak出libc地址:基地址+函数在libc中的 ...
- Maven导入项目时报错 Could not calculate build plan
Could not calculate build plan: Plugin org.apache.maven.plugins:maven-war-plugin:2.2 or one of its d ...
- idea使用阿里工具优化代码+阿里开发手册
idea安装工具 打开插件安装界面 File-Settings-Plugins-Browse repositories... 搜索Alibaba Java Coding Guidelines 进行安装 ...
- ajax 文件下载
作为一个后端开发人员,使用java 生成文件,提供前端下载,这个问题倒不大,可是让我们自己去下载文件的时候,这个问题就大了,对不起,我只对前端一知半解,并不精通,谢谢!! 需求如下:前端检索数据,后台 ...