
Python 爬虫利器 Selenium 介绍
Python 爬虫利器 Selenium 介绍
https://mp.weixin.qq.com/s/YJGjZkUejEos_yJ1ukp5kw
前面几节,我们学习了用 requests 构造页面请求来爬取静态网页中的信息以及通过 requests 构造 Ajax 请求直接获取返回的 JSON 信息。
可以点击链接查看:
还记得前几节,我们在构造请求时会给请求加上浏览器 headers,目的就是为了让我们的请求模拟浏览器的行为,防止被网站的反爬虫策略限制。今天要介绍的 Selenium 是一款强大的工具,它可以控制我们的浏览器,这样一来程序的行为就和人类完全一样了。
通过使用 Selenium 可以解决几个问题:
页面内容是由 JavaScript 动态生成,通过 requests 请求页面无法获取内容。
爬虫程序被反爬虫策略限制
让程序的行为和人一样
安装
pip install selenium安装浏览器驱动
驱动下载地址https://sites.google.com/a/chromium.org/chromedriver/downloads
下载后把驱动文件加入环境变量。或者直接把驱动文件和 Python脚本放到同一文件夹下面
测试
安装完成后,可以编写以下脚本来测试是否安装成功。
from selenium import webdriver
driver = webdriver.Chrome()  # 创建一个 Chrome WebDriver 实例
driver.get('https://www.baidu.com/')  # 打开网址
运行后会发现程序自动打开了 Chrome 浏览器,并且定向到了百度首页。
与页面交互
WebDriver定义了很多方法,我们可以很方便的操作页面上的元素
比如获取元素,可以通过
driver.find_element_by_id("id")或者
driver.find_element_by_name("name")以及 xpath路径的方式来获取元素。可以通过send_keys 向输入框中写入文本。
from selenium import webdriver
driver = webdriver.Chrome()
driver.get('https://www.baidu.com/')
search_input = driver.find_element_by_id("kw") # 获取到百度搜索框
search_input.send_keys("刘亦菲")  # 自动输入 刘亦菲
submit = driver.find_element_by_id("su")  # 获取到百度一下按钮
submit.click()  # 点击搜索
运行以上脚本,程序会自动打开 Chrome 浏览器,并自动搜索 刘亦菲
其他操作
Selenium 可以进行各种各样的操作,使程序完全符合人类的操作习惯。下面看一下还有哪些功能。
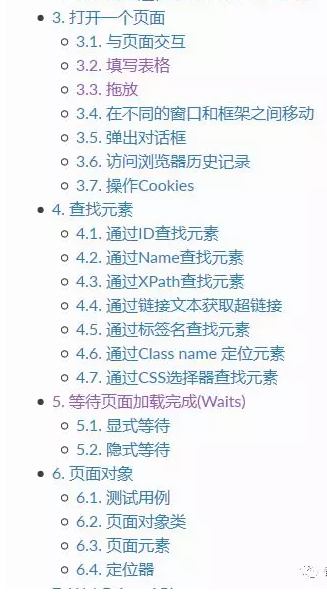
具体可以看官方文档,这里贴一下地址
https://selenium-python-zh.readthedocs.io/en/latest/index.html
Python 爬虫利器 Selenium 介绍的更多相关文章
- python爬虫利器Selenium使用详解
简介: 用pyhon爬取动态页面时普通的urllib2无法实现,例如下面的京东首页,随着滚动条的下拉会加载新的内容,而urllib2就无法抓取这些内容,此时就需要今天的主角selenium. Sele ...
- Python 爬虫利器 Selenium
前面几节,我们学习了用 requests 构造页面请求来爬取静态网页中的信息以及通过 requests 构造 Ajax 请求直接获取返回的 JSON 信息. 还记得前几节,我们在构造请求时会给请求加上 ...
- [Python爬虫]使用Selenium操作浏览器订购火车票
这个专题主要说的是Python在爬虫方面的应用,包括爬取和处理部分 [Python爬虫]使用Python爬取动态网页-腾讯动漫(Selenium) [Python爬虫]使用Python爬取静态网页-斗 ...
- web前端自动化测试/爬虫利器puppeteer介绍
web前端自动化测试/爬虫利器puppeteer介绍 Intro Chrome59(linux.macos). Chrome60(windows)之后,Chrome自带headless(无界面)模式很 ...
- Python爬虫利器二之Beautiful Soup的用法
上一节我们介绍了正则表达式,它的内容其实还是蛮多的,如果一个正则匹配稍有差池,那可能程序就处在永久的循环之中,而且有的小伙伴们也对写正则表达式的写法用得不熟练,没关系,我们还有一个更强大的工具,叫Be ...
- python 爬虫利器 Beautiful Soup
python 爬虫利器 Beautiful Soup Beautiful Soup 是一个可以从HTML或XML文件中提取数据的Python库.它能够通过你喜欢的转换器实现惯用的文档导航,查找,修改文 ...
- Python爬虫利器六之PyQuery的用法
前言 你是否觉得 XPath 的用法多少有点晦涩难记呢? 你是否觉得 BeautifulSoup 的语法多少有些悭吝难懂呢? 你是否甚至还在苦苦研究正则表达式却因为少些了一个点而抓狂呢? 你是否已经有 ...
- Python爬虫利器一之Requests库的用法
前言 之前我们用了 urllib 库,这个作为入门的工具还是不错的,对了解一些爬虫的基本理念,掌握爬虫爬取的流程有所帮助.入门之后,我们就需要学习一些更加高级的内容和工具来方便我们的爬取.那么这一节来 ...
- (转)Python爬虫利器一之Requests库的用法
官方文档 以下内容大多来自于官方文档,本文进行了一些修改和总结.要了解更多可以参考 官方文档 安装 利用 pip 安装 $ pip install requests 或者利用 easy_install ...
随机推荐
- struts2 过滤器和拦截器的区别和使用
java web 过滤器和拦截器的区别和使用 1.1 什么是拦截器: 拦截器,在AOP(Aspect-Oriented Programming)中用于在某个方法或字段被访问之前,进行拦截然 ...
- nginx(一)之默认配置文件
首先是nginx.conf vim /etc/nginx/nginx.conf user nginx; // 设置nginx服务的系统使用用户 worker_processes 1; // 工作进程数 ...
- 简化版的AXI-LITE4和配合使用的RTL
////////////////////////////////////////////////////////////////////////////////// // // The ZYNQ FI ...
- 如何使用PowerShell批量删除Office 365的用户
概述 本文将演示如何在必要的时候(例如在测试环境),通过PowerShell脚本批量删除Office 365的用户,首先需要通过Get-MsolUser的命令(并且配合筛选条件)获取到符合条件的用户列 ...
- redis客户端、分布式锁及数据一致性
Redis Java客户端有很多的开源产品比如Redission.Jedis.lettuce等. Jedis是Redis的Java实现的客户端,其API提供了比较全面的Redis命令的支持:Redis ...
- ignitius and princess 2(全排列)
A - Ignatius and the Princess II Now our hero finds the door to the BEelzebub feng5166. He opens the ...
- LeetCode(107): 二叉树的层次遍历 II
Easy! 题目描述: 给定一个二叉树,返回其节点值自底向上的层次遍历. (即按从叶子节点所在层到根节点所在的层,逐层从左向右遍历) 例如:给定二叉树 [3,9,20,null,null,15,7], ...
- vue用webpack打包时引入es2015插件
1.安装依赖包 $ npm install --save-div babel-preset-es2015 ps:babel-loader.babel-core应该是默认装好的,如果没有安装,请重新安装 ...
- java运行环境增加字体
背景 今天在使用jfreeChart时,显示中文乱码,如下图: 环境:Ubuntu 13.04 64bit java7 tomcat 7.0.42 解决方法--增加系统字体 0. 安装环境包 su ...
- gulp构建自动化项目
'use strict'; var gulp = require('gulp'), browserSync = require('browser-sync').create(), SSI = requ ...